AI News · industry
TypeSafe Jev, 1.759 Kararda Gemini'ye Karşı: 5 Kat Hızlı, 25 Kat Ucuz, %98,5 Doğru
TypeSafe'in yalnızca karar vermek için tasarlanan yeni modelini 13 dilde 1.357 etiketli karar ve 402 gerçek müşteri sohbetiyle test ettik. Öncü bir LLM'e neredeyse yetişti, üstelik zamanın ve maliyetin küçük bir kısmıyla. Sonra da tam olarak nerede kırıldığını gösterdi.
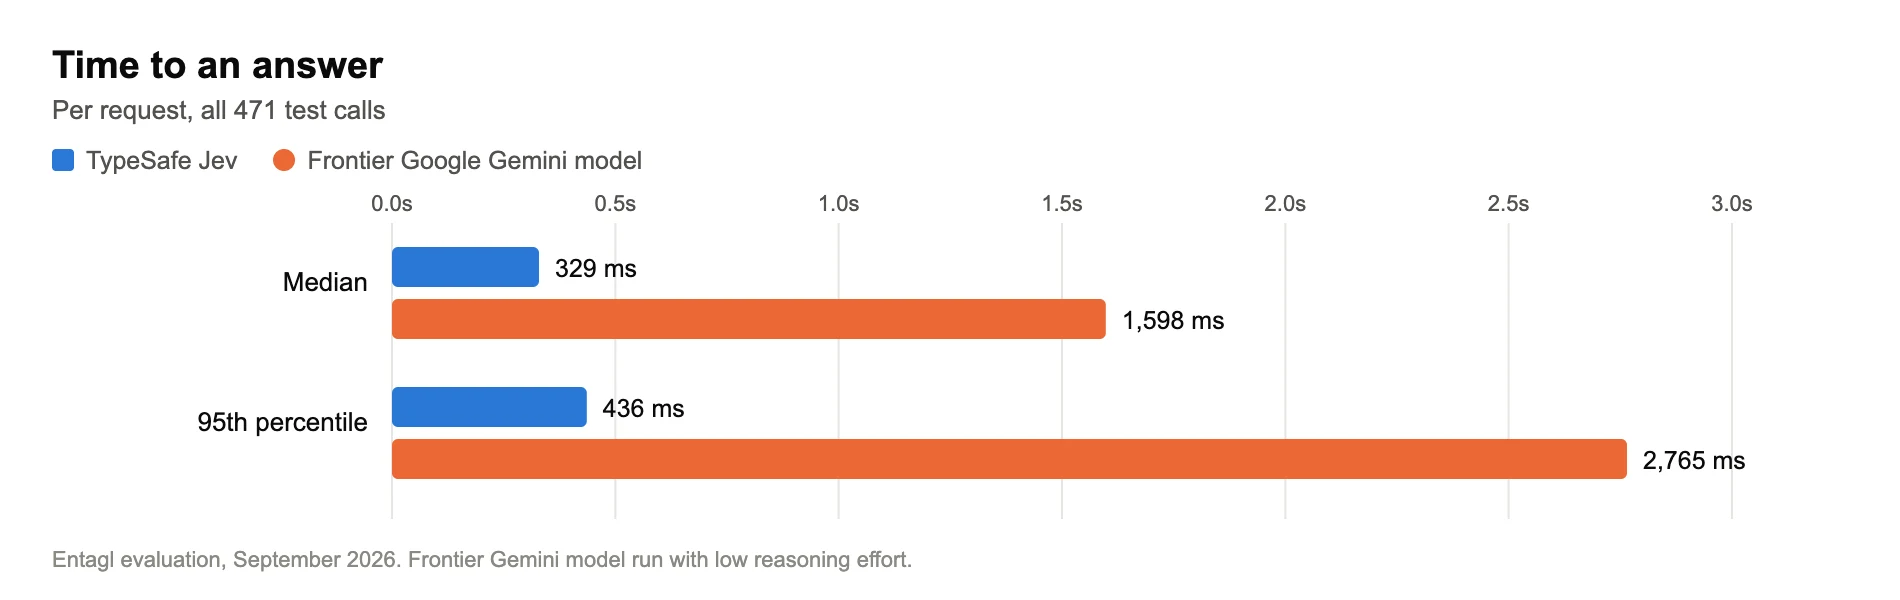
TypeSafe'in 15 Eylül'de duyurduğu, yalnızca karar vermek için tasarlanmış model TypeSafe Jev'e 1.759 karar verdirdik: 13 dilde elle etiketlenmiş 1.357 test kararı ve canlı müşteri sohbetlerinden gelen 402 gerçek yönlendirme kararı. Öncü bir Google Gemini modeline karşı 5 kat daha hızlıydı (medyan 329 ms'ye karşı 1.598 ms), 25 kat daha ucuzdu ve doğrulukta neredeyse başa baş gitti (%98,5'e karşı %99,0). %97 ve üzeri emin olduğunu söylediğinde 986 kararın 986'sında haklı çıktı.
Ardından gerçek müşteri trafiğini yeniden oynattık ve hiçbir test setinin öngörmediği şekillerde kırıldı. Hepsi burada: rakamlar, grafikler, kör noktalar ve onu nerede kullanır, nerede kullanmazdık.
TypeSafe Jev nedir, bir LLM'den farkı ne?
TypeSafe, Jev'i 15 Eylül 2026'da ilk "System One" modeli olarak duyurdu. İsim, Daniel Kahneman'ın hızlı ve sezgisel Sistem 1 düşünme kavramından geliyor. Ondan metin yazmasını istemezsiniz. Olguları (bir mesaj, kısa bir geçmiş, bir seçenek listesi) ve tipli sorularınızı gönderirsiniz; o da size üç yanıt türünden birini döndürür:
| Soru türü | Ne soruyorsunuz | Ne dönüyor |
|---|---|---|
| Evet/hayır | "Bu mesaj, kendisiyle iletişimi kesmemizi mi istiyor?" | Bir olasılık, örneğin 0,97 |
| Birini seç | "Bu dört ekipten hangisi yanıt vermeli?" | Seçim, her seçenek için bir olasılık ve bir güven skoru |
| Puan | "Bu müşteri 5 basamaklı bir ölçekte ne kadar sinirli?" | Ölçekteki konum ve dağılım |
Yanıt yazamaz, araç çağıramaz, görsel okuyamaz. TypeSafe modeli, kendi deyişiyle kalibre kararlar için pekiştirmeli öğrenmeyle eğitiyor. Hedef şu: "%90 eminim" dediğinde gerçekten 10 kararın yaklaşık 9'unda haklı olması. Sıradan dil modelleri bu konuda zayıf. 2017'de yayımlanan ve sık atıf alan bir çalışma, modern sinir ağlarının aşırı özgüvenli olma eğiliminde olduğunu gösterdi (Guo et al., "On Calibration of Modern Neural Networks," ICML 2017). Fiyatlandırma da alışılmışın dışında: TypeSafe yalnızca girdi token'ları için ücret alıyor; çıktı ücretsiz.
Dar kapsamlı, ucuz bir karar modeli, öncü bir LLM'in "karar ver" adımlarını daha fazla hata yapmadan devralabilir mi? Verimiz aşağıda.
Nasıl test ettik?
İki tur yaptık; her modele aynı sorular soruldu.
1. tur: etiketli bir test seti. 13 karar görevine yayılan 283 gerçekçi vaka yazdık ve hiçbir şeyi çalıştırmadan önce her birinin doğru yanıtını etiketledik: 189 standart vaka ve 94 daha zor vaka. Yanıtların tekrarlanıp tekrarlanmadığını görmek için zor vakaları üçer kez çalıştırdık; toplamda 471 vaka çalıştırması ve 1.357 puanlanan karar çıktı. Diller: İngilizce, Türkçe, dört Arapça varyantı, Latin harfleriyle yazılan Arapça ve 10 dil daha. Görevler arasında mesajı doğru uzmana yönlendirmek, prompt injection (istem enjeksiyonu) metnini yakalamak, bir telefon görüşmesi dökümünden görüşmenin sonucunu çıkarmak ve işletmenin hiç belirlemediği bir fiyatı söyleyen yanıtı işaretlemek vardı. Jev ve öncü bir Google Gemini modeli (düşük akıl yürütme seviyesinde) birebir aynı olguları, soruları ve seçenekleri aldı.
2. tur: gerçek geçmişi yeniden oynatmak. Ürünümüzün iki müşteri çalışma alanı için 21 gün boyunca zaten verdiği 402 gerçek yönlendirme kararını aldık, aynı sohbetleri Jev'den geçirdik ve sonuçları karşılaştırdık. A çalışma alanı Orta Doğu'da bir profesyonel hizmetler firması; trafiğin çoğu WhatsApp üzerinden ve Arapça. B çalışma alanı bir sağlık destek hizmeti; trafiğin çoğu web sohbeti üzerinden ve İngilizce ile Portekizce. Orijinal kararları öncü Google Gemini ve OpenAI GPT modelleri vermişti. Hiçbir metin sistemlerimizden çıkmadan önce isimler, telefon numaraları, e-postalar ve bağlantılar maskelendi. Jev ile orijinal karar ayrıştığında sohbeti okuduk ve hangi yanıtın müşterinin kendi yazılı kurallarına uyduğuna karar verdik. Kuralların netleştirmediği vakaları dışarıda bıraktık.
Jev etiketli testte ne kadar doğruydu?
Öncü model kadar doğru sayılır: 1.357 puanlanan kararda %99,0'a karşı %98,5. Üstelik yaklaşık beş kat daha hızlı.
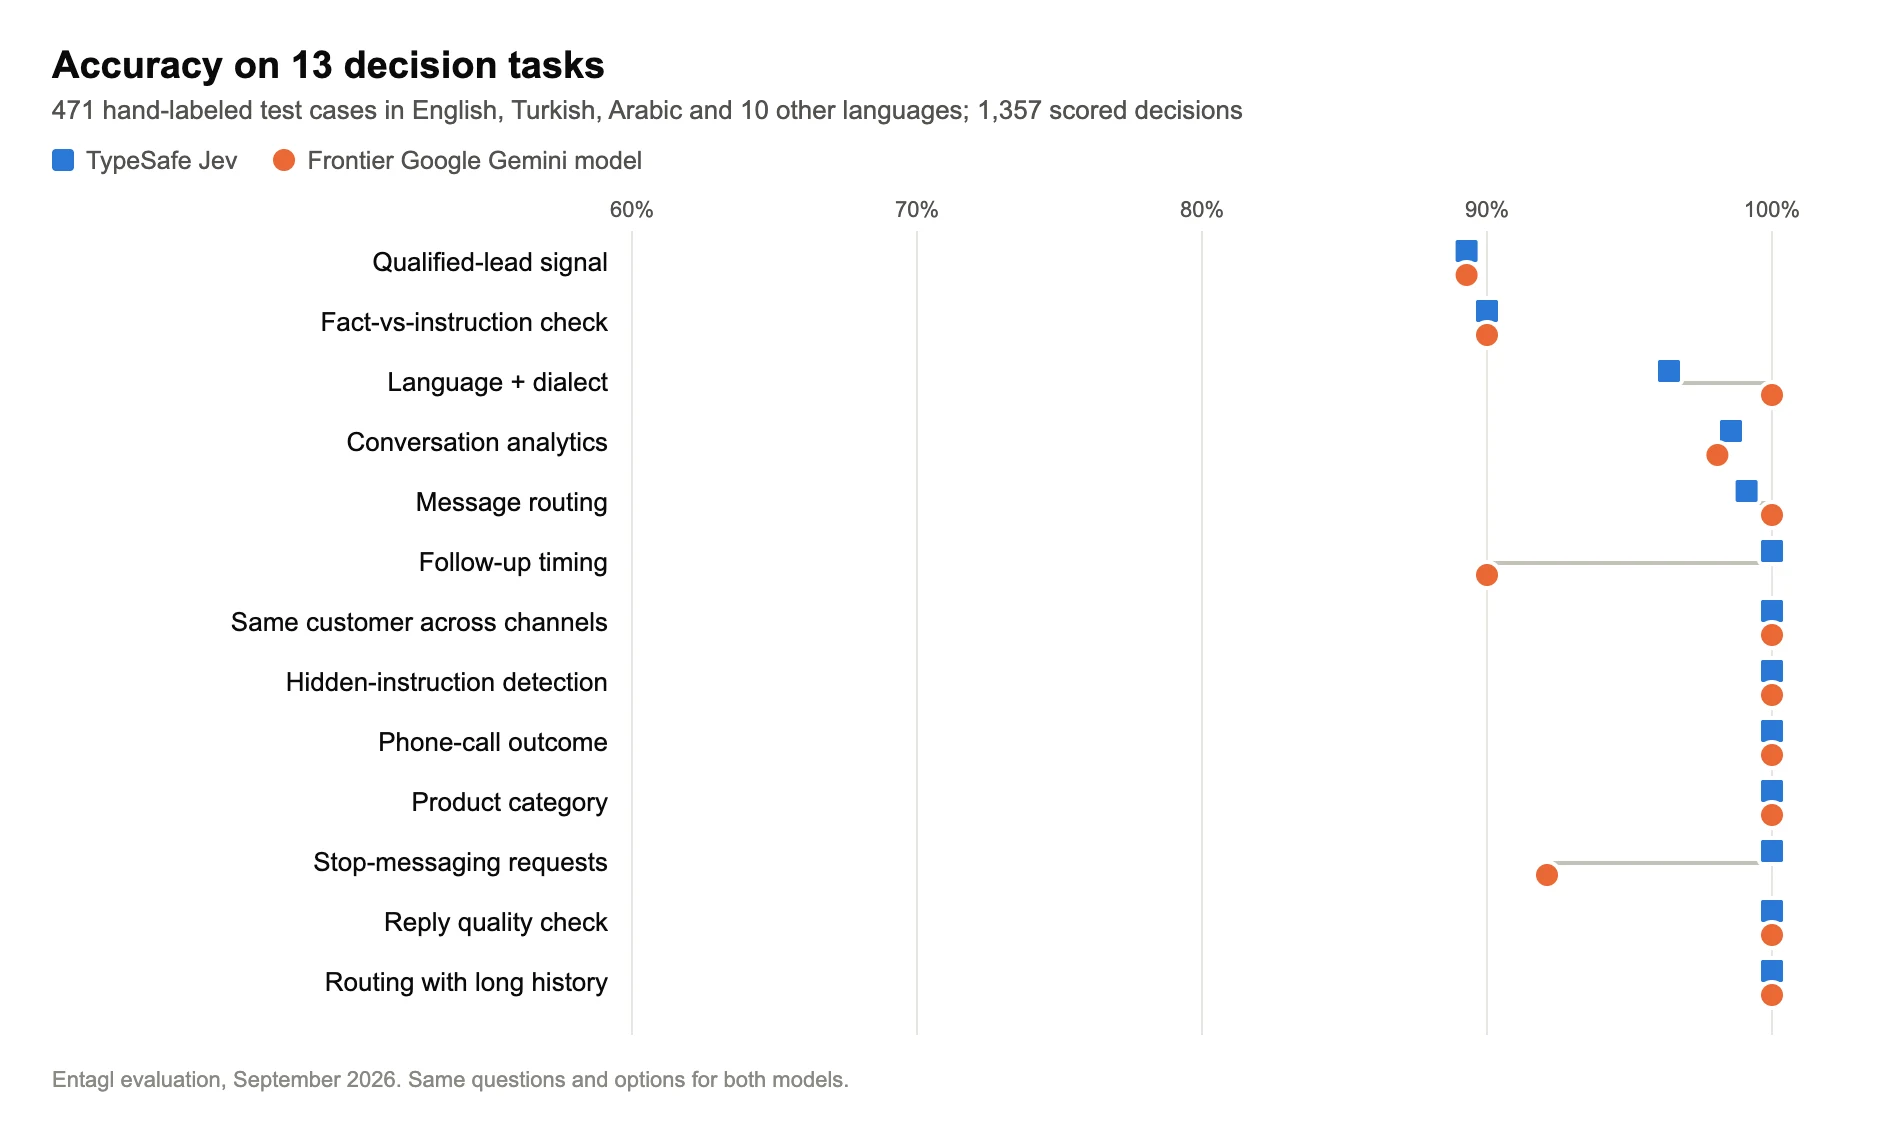
Farklar küçük ve iki yöne de işaret ediyor. Jev, "Artık ilgilenmiyorum" cümlesinin abonelikten çıkma talebi olmadığını bildi; Gemini ise bunu işaretledi. Gemini ayrıca "ekibimiz sizi arayacak" ifadesini müşteriyi telefona yönlendirmek olarak saydı ve "biraz pahalı, belki sonra" diyen birini takibe değmez buldu. Oysa tam da dürtmek isteyeceğiniz aday bu.
Jev'in zayıf noktası Arapça lehçelerdi. Metnin Arapça olduğunu her seferinde bildi, ama iki Körfez Arapçası mesajını her çalıştırmada Mısır ya da Levanten Arapçası olarak okudu (toplam altı hata). Ayrıca iki model de "Fiyatı ne? 😍" mesajını nitelikli aday saydı; oysa kuralımız fiyatın yanında zamanlama ya da iletişim bilgisi de istiyordu. Orada sorun modellerde değil, kuraldaydı.
Güven skoruna güvenebilir misiniz?
Bu testte, evet. Jev'in sunduğu en faydalı şey de bu.
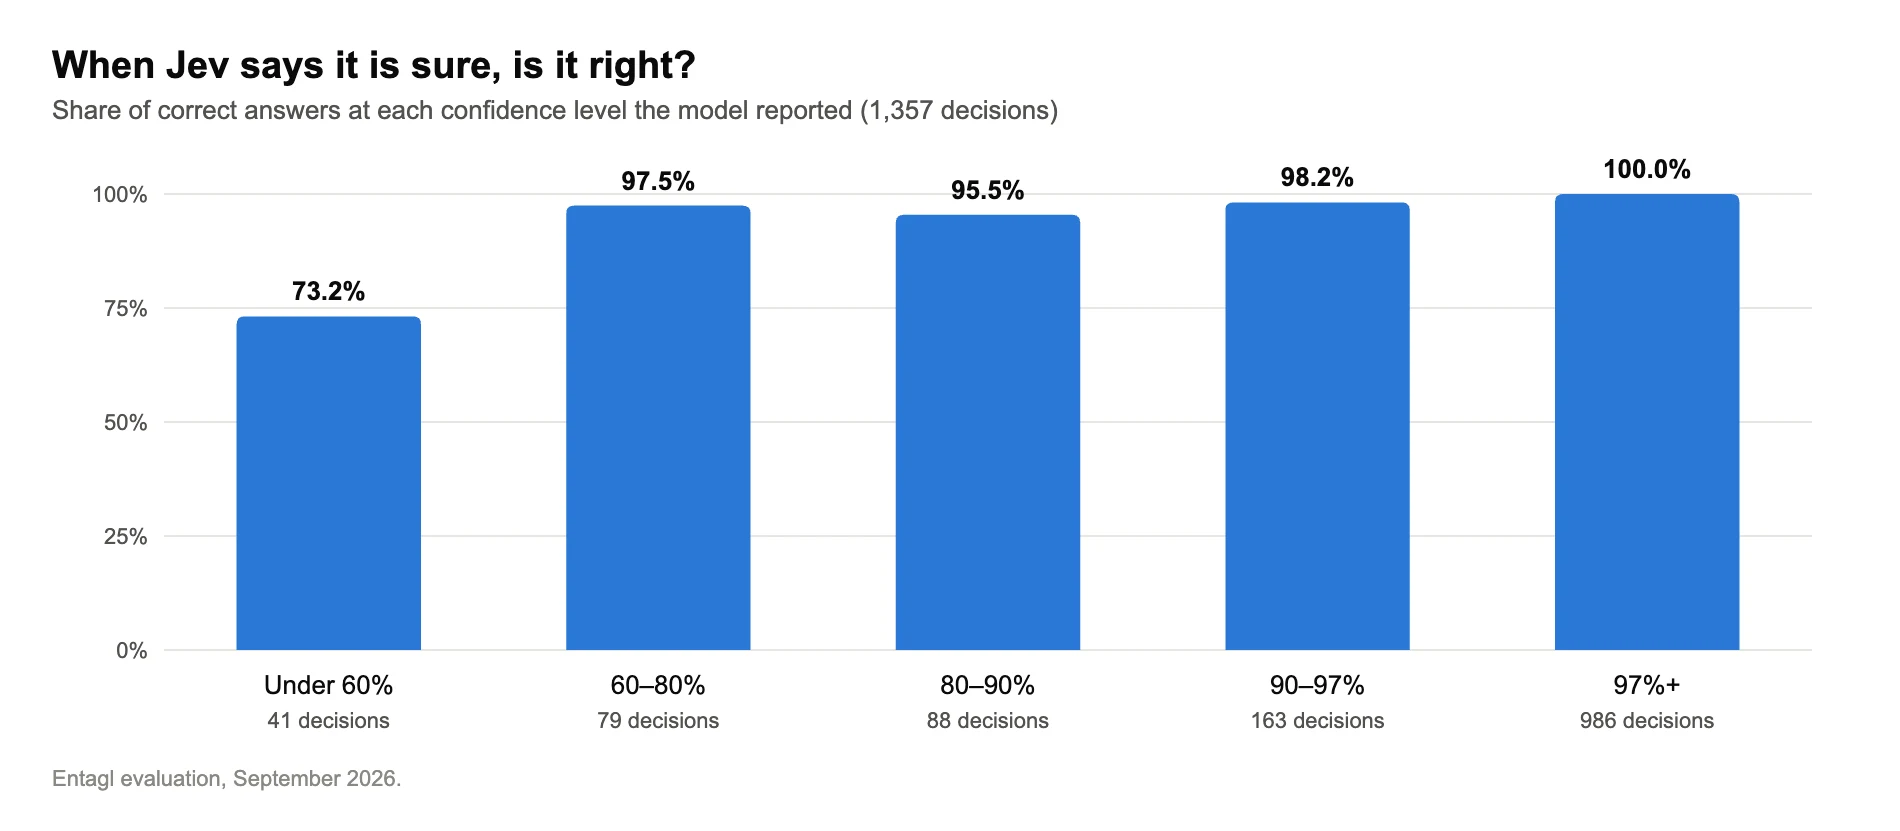
Basit bir kural koyun: "Jev'in yanıtını yalnızca en az %85 emin olduğunda kullan, değilse büyük modele sor." Bu durumda Jev kararların %88'ini %99,75 doğrulukla üstleniyor ve 20 hatasının 17'si yedek modele gidiyor. Arapça lehçe hatalarının hepsi 0,36 ile 0,40 arasında bir güven skoruyla geldi, yani kural hepsini yakaladı.
Yine de bir hata yüksek güvenle geçti. Türkiye'den bir reklam ajansı "sizinle çalışmak istiyoruz" diye yazdı. Jev bunu üç çalıştırmanın üçünde de 0,95 güvenle iş başvurusu olarak okudu. Bağlam içinde zararı olmadı (Jev mesajı aynı zamanda satış teklifi olarak işaretledi ve geçerli olan o karardı), ama yerinde bir uyarı: güven skoru bir kanıttır, izin değil. Herhangi bir şeyi devreye aldıktan sonra da etiketli kontrollere ve sonuç takibine ihtiyacınız var.
Gerçek sohbetleri yeniden oynattığımızda ne oldu?
Orijinal kararlarla ham uyum yalnızca %74–84 oldu, ama bu farkın çoğu Jev'in yanılmasından kaynaklanmıyordu.
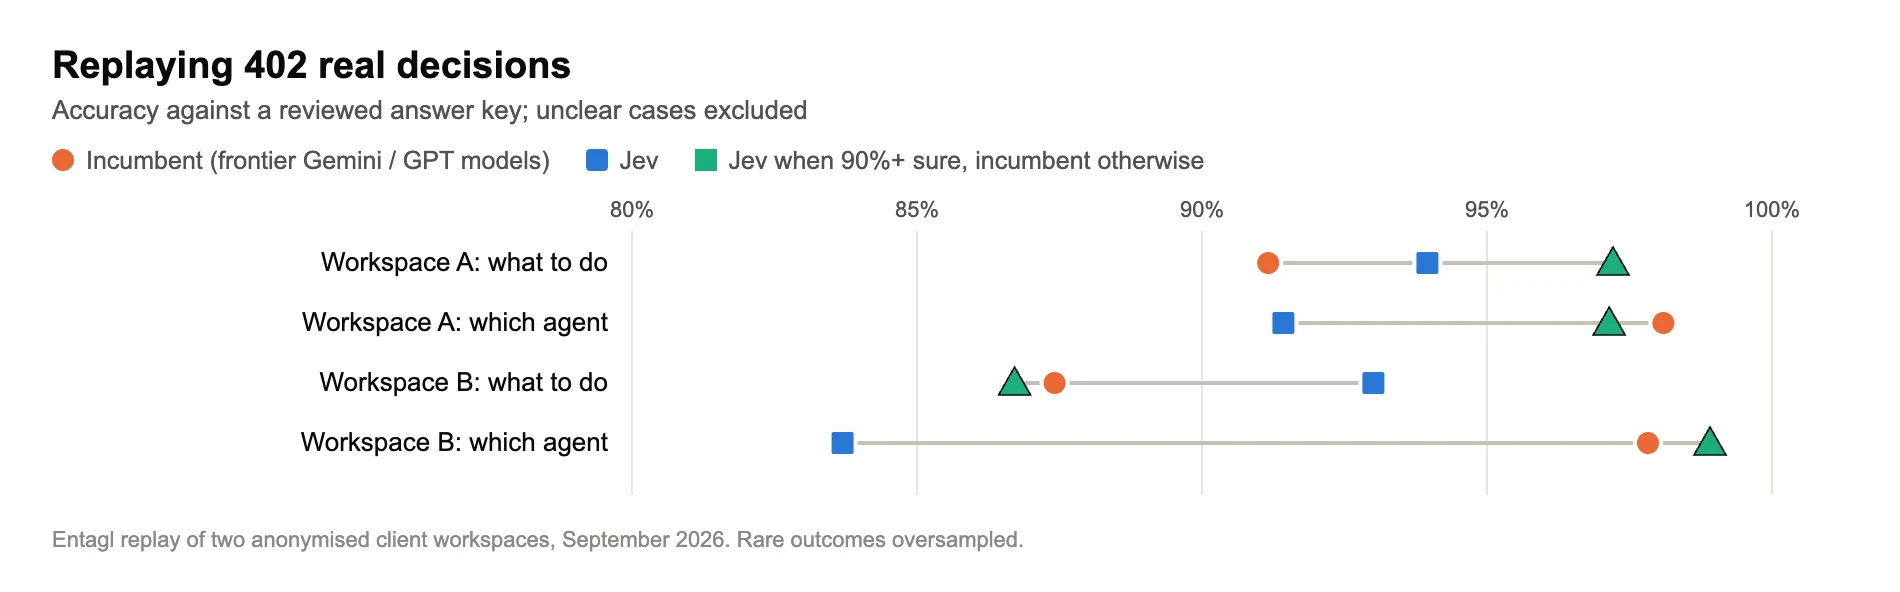
Gözden geçirilmiş cevap anahtarına göre puanlar:
| Karar | Orijinal (öncü Gemini / GPT) | Jev | %90+ emin olduğunda Jev, değilse orijinal |
|---|---|---|---|
| A çalışma alanı: mesajla ne yapılacağı | %91,2 | %94,0 | %97,2 |
| A çalışma alanı: hangi uzmanın yanıtlayacağı | %98,1 | %91,4 | %97,1 |
| B çalışma alanı: mesajla ne yapılacağı | %87,4 | %93,0 | %86,7 |
| B çalışma alanı: hangi uzmanın yanıtlayacağı | %97,8 | %83,7 | %98,9 |
Bir tuhaflık var: B çalışma alanında eşik uygulamak mesaj kararını biraz kötüleştirdi (%86,7). Çünkü Jev'in emin olmadığı mesajlarda orijinale dönmek, orijinalin en zayıf yanıtlarını kullanmak anlamına geliyordu.
Mesajla ne yapılacağına karar vermek (yanıtla, yok say, ekibe devret, hazır yanıt gönder) iki çalışma alanında da Jev'in lehine sonuçlandı. Uzmanı seçmek ise öyle olmadı ve bunun somut bir nedeni var. Hataların çoğu, zaten bir uzmanla süren bir sohbetteki "Hindistan" ya da "yarın konuşacağım" gibi devam mesajlarıydı. Müşterinin kuralları o uzmanla devam edilmesini söylüyor. Jev son sekiz mesajı gördü ama sohbetin kime ait olduğu ona söylenmedi; bu yüzden kelimelerden tahmin yürüttü. Orijinal kurulumda bu bağlam vardı ve kullanıldı.
Yeniden oynatma, orijinal kararlardaki hataları da ortaya çıkardı; hem de rastgele kontrolün kaçıracağı türden:
- Yanlış kişilerde tetiklenen bir anahtar kelime kuralı. Biri "legal" (hukuki) ya da "lawyer" (avukat) kelimesini kullandığında hazır bir yönlendirme yanıtı gidiyordu. 20'lik bir örneklemde 15'i, "bunun için hangi hukuki belgelere ihtiyacım var?" gibi sıradan iş sorularıydı. Jev bunları gerçek bir yanıta yönlendirdi.
- Tekrarlanan devirler. Müşteri adını ve numarasını bir kez verdikten sonra, "teşekkürler" ya da "obrigada" gibi sonraki mesajların her biri ekibe yeni bir devir tetikledi. İncelediğimiz 41 devrin 17'si bu türden tekrarlardı.
- Birbiriyle çelişen iki kural. Bu yüzden iki model de aynı mesajlarda tahmin yürütüyordu.
Bunları kaynağında düzeltilmek üzere işaretledik. İlki gibi anahtar kelime kuralları, AI halüsinasyonlarını durdurma rehberimizin tam olarak uyardığı şey.
Jev nerede yetersiz kalıyor?
Açıkça söyleyelim:
- İngilizce dışındaki nüanslar. TypeSafe'in kendi dokümantasyonu, İngilizcenin birincil eğitim dili olduğunu ve diğer dillerin "işlendiğini ama aynı ölçüde iyi işlenmediğini" söylüyor. Biz de bunu gördük: İngilizcede %99,1, Türkçede %98,4, Arapçada %96,5. Dokuz Arapça hatasının altısı lehçe karışıklığıydı; kalan üçü "bu bir şikâyet mi?" sorusunda sınırda kalan tek bir mesajdan ve bizim de tartışacağımız bir etiketten geldi.
- Çıkaramayacağı eksik bağlam. Sohbetin kime ait olduğu, iletişim bilgilerinin zaten alınıp alınmadığı: gerçek yeniden oynatmada yanıt, gönderdiğimiz metinde olmayan bir olguya bağlı olduğu her seferinde Jev puan kaybetti. Çözüm, bu olguları kodda hesaplayıp modele vermek; modelin tahmin etmesini ummak değil.
- Önceden doldurulmuş reklam metni. Tıkla-mesaj gönder reklamlarından gelen pek çok WhatsApp sohbeti "Hizmetleriniz hakkında daha fazla bilgi almak istiyorum" gibi bir şablon satırıyla başlıyor. Jev bu satıra fazla yaslandı ve gerçek iş arayanlardan ve bağış taleplerinden birkaçını iş fırsatı olarak geçirdi; biri 0,92 güvenle. Şablonu önce ayıklayın.
- Hiç yapılmak üzere tasarlanmadığı işler. TypeSafe kendi "pürüzlü kenarlarını" listeliyor: aritmetik, sayma, tarih karşılaştırma, alakasız ayrıntılarla dolu uzun girdiler ve onu manipüle etmek için yazılmış metinler. Matematiği ve tarihleri kodda tutun.
- Yepyeni. Eylül 2026'da çıktı ve hız limitleri, satıcının deyişiyle değişebilir. Üzerine inşa edilen her şeyin bir yedeği olmalı.
Jev gibi bir karar modelini nerede kullanırdık?
Bir LLM'den listeden seçim yapmasının istendiği ve çıktıyı kimsenin okumadığı her yerde:
- İlk aşama yönlendirme ve eleme: bir güven eşiği ve arkasında daha büyük bir modelle.
- Günlük sohbet analitiği (kategori, duygu, "fiyat sordu mu"): örneklemde değil, her sohbette.
- Sürekli açık güvenlik kontrolleri: her dilde mesajlaşmayı durdurma talepleri ya da asistana talimat vermeye çalışan metinler (prompt injection rehberimize göz atın).
- Veri olarak görüşme sonuçları: dökümden okunarak.
Sorularınızı da toplu gönderin: TypeSafe'in uzun bir doküman üzerindeki kendi testinde, 13 soruyu 13 ayrı çağrı yerine tek çağrıda sormak 12,2 kat daha ucuz ve 10 kat daha hızlıydı, yanıtlar ise aynıydı.
Kullanmayacağımız yerler ise şunlar: yanıt yazmak, sayısal her şey ve kendinden emin ama yanlış bir yanıtın gerçek bir müşteriyi susturacağı her durum. Bir mesajı doğrudan engellemek, çok yüksek güven ya da ikinci bir görüş gerektirmeli.
Bir karar modelini kendiniz nasıl değerlendirmelisiniz?
Bizim için işe yarayanlar:
- Çalıştırmadan önce etiketleyin. "Mevcut modelle aynı fikirde" olmak, "doğru" olmakla aynı şey değil. Yeniden oynatmamız, mevcut modelin önemsenecek sıklıkta yanıldığını gösterdi.
- Dile göre ayırın. %98'lik bir ortalama, müşterilerinizin gerçekten kullandığı bir dilde %96'yı gizleyebilir.
- Doğruluğu güven düzeyine göre grafiğe dökün, sonra gerçek geçmişi yeniden oynatın. Güvenilir bir eşiği olmayan ucuz bir model bir yüktür. Yazdığımız vakalarda iki model de %100'e yakın bir tavana dayandı; farklar ve mevcut modelin kendi hataları gerçek trafikte ortaya çıktı.
- Geçiş yapmadan önce gölge modda çalıştırın. Yeni modeli eskisinin yanında sessizce çalıştırın ve geçişi görev görev yapın; asla hepsini birden değil.
Bu, ürününüzü tek bir AI modeline emanet etmemek konusunda daha önce vurguladığımız genel bir noktayla örtüşüyor: "karar ver" işi için doğru model, çoğu zaman "yaz" işi için doğru model değildir ve daha küçük, daha ucuz modeller artık ilk işin çoğu ekibin sandığından daha büyük kısmını üstlenebiliyor.
SSS
TypeSafe Jev, GPT ya da Gemini'nin yerini alır mı?
Hayır. Yalnızca bir çağrı türünün yerini alır: tanımladığınız seçenekler arasından seçim yapmak, bir ölçekte puan vermek ya da evet/hayır yanıtlamak. Metin yazamaz, araç kullanamaz, görsel okuyamaz; bu yüzden müşteriyle konuşan bir ajanın yanıt için yine bir dil modeline ihtiyacı var.
TypeSafe Jev öncü LLM'lere kıyasla ne kadar doğru?
Eylül 2026'da 1.357 etiketli kararla yaptığımız testte %98,5 aldı; öncü bir Google Gemini modeli ise %99,0 aldı. Gerçek sohbet geçmişinde mesajla ne yapılacağına karar vermede daha iyi, sohbetin ortasında doğru uzmanı seçmede daha kötüydü.
TypeSafe Jev Arapça ve Türkçede çalışıyor mu?
Evet, bir çekinceyle. Testimizde Türkçe İngilizceye yakındı (%99,1'e karşı %98,4). Arapça %96,5'te kaldı. Hataların çoğu lehçe karışıklığıydı (Körfez Arapçasının Mısır ya da Levanten olarak okunması); dil hiçbir zaman yanlış tespit edilmedi ve bu hatalar düşük güven skorlarıyla geldi.
Jev'in güven skoruna güvenebilir misiniz?
Verilerimizde doğrulukla iyi örtüştü: %97 ve üzeri güvende %100 doğru, %60'ın altında %73. Yine de bir kendinden emin hata (0,95) yaşandı; bu yüzden skoru ne zaman yedeğe döneceğinize karar vermek için kullanın ve gerçek sonuçları kontrol etmeye devam edin.
Bir LLM'den daha ucuz ve daha hızlı mı?
Test çağrılarımızda yaklaşık 25 kat daha ucuza geldi ve medyan 1.598 ms'ye karşı 329 ms'de yanıt verdi. Bunun temel nedeni, Jev'in yalnızca girdi token'larını ücretlendirmesi ve üretilmiş metin yerine kısa, tipli bir yanıt döndürmesi.
Ne zaman emin olmadığını bilen bir AI mı istiyorsunuz?
Bu tür modelleri, müşterilerinize yanıt veren ajanlar ucuz ve hızlı kararları doğru versin, zor olanları da daha büyük bir modele devretsin diye test ediyoruz. Bunun kendi DM'lerinizde nasıl işlediğini görmek için 30 dakikalık bir demo planlayın ya da Instagram ve WhatsApp DM'leri için AI ajanlarımızın bugün bunu nasıl yönettiğine göz atın.
Kaynaklar ve yöntem: Entagl değerlendirmesi, Eylül 2026. 1. tur: elle etiketlenmiş 283 test vakası (189 standart ve üçer kez çalıştırılan 94 zor vaka: 471 vaka çalıştırması), 1.357 puanlanan karar; TypeSafe Jev (jev-1.13.0), aynı girdilerle öncü bir Google Gemini modeline karşı. Maliyet karşılaştırması, aynı çağrılar için faturalanan token'ları her satıcının Eylül 2026 itibarıyla geçerli liste fiyatıyla karşılaştırır (Jev yalnızca girdi token'larını ücretlendirir). 2. tur: anonimleştirilmiş iki müşteri çalışma alanından 21 gün boyunca alınan 402 gerçek yönlendirme kararı; kişisel veriler işlenmeden önce maskelendi. Ayrışmalar her müşterinin yazılı kurallarına göre incelendi, belirsiz vakalar dışarıda bırakıldı ve nadir sonuçlar örneklemde fazla temsil edildi; bu nedenle yüzdeler bir üretim ortalaması değildir. Tek bir değerlendirici. Satıcı bilgileri: TypeSafe lansman yazısı, TypeSafe model dokümantasyonu, Jev 1.13 bilinen sınırlamaları, TypeSafe paralel sorular rehberi. Kalibrasyon arka planı: Guo et al., ICML 2017.