AI News · industry
TypeSafe Jev против Gemini на 1,759 решениях: в 5 раз быстрее, в 25 раз дешевле, точность 98.5%
Мы проверили новую модель TypeSafe, которая умеет только принимать решения, на 1,357 размеченных решениях на 13 языках и 402 реальных чатах с клиентами. Она почти догнала передовую LLM за малую долю времени и денег, а потом точно показала, где ломается.
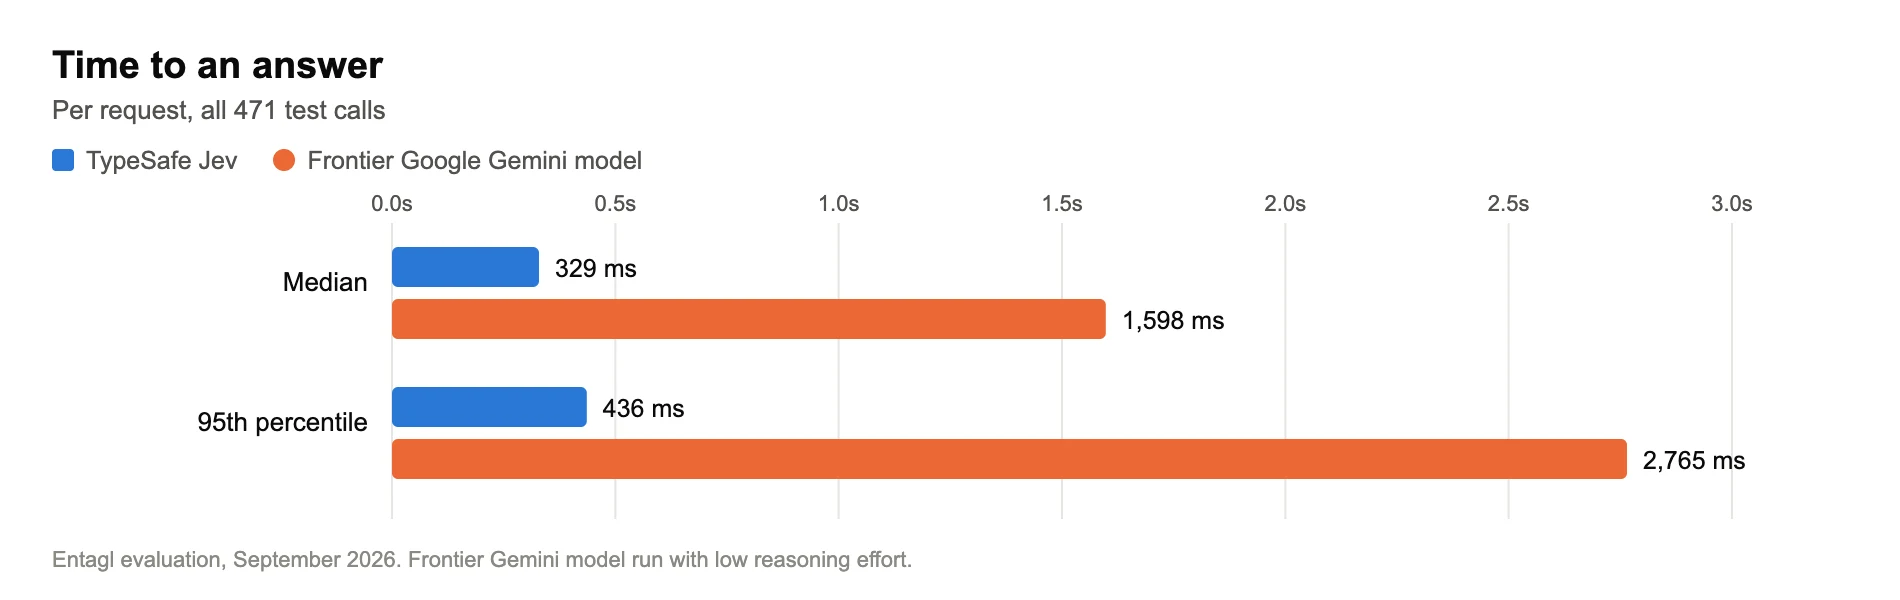
TypeSafe Jev вышла 15 сентября. Это модель, которая не пишет текст, а только принимает решения. Мы дали ей 1,759 решений: 1,357 тестовых с ручной разметкой на 13 языках и 402 реальных решения о маршрутизации из живых чатов с клиентами. По сравнению с передовой моделью Google Gemini она оказалась в 5 раз быстрее (медиана 329 ms против 1,598 ms), в 25 раз дешевле и почти такой же точной (98.5% против 99.0%). Когда Jev была уверена на 97% и выше, она оказалась права 986 раз из 986.
Потом мы прогнали через неё реальный клиентский трафик, и она ошиблась там, где ни один тестовый набор этого не предсказывал. Ниже всё целиком: цифры, графики, слепые зоны и то, где мы стали бы её использовать, а где нет.
Что такое TypeSafe Jev и чем она отличается от LLM?
TypeSafe анонсировала Jev 15 сентября 2026 года как свою первую модель класса «System One». Название отсылает к быстрому интуитивному мышлению «Системы 1» по Daniel Kahneman. Промптом текст из неё не вытянуть. Вы передаёте факты (сообщение, короткую историю переписки, список вариантов) и типизированные вопросы, а в ответ получаете один из трёх типов ответа:
| Тип вопроса | Что вы спрашиваете | Что возвращается |
|---|---|---|
| Да/нет | «Просит ли клиент в этом сообщении больше с ним не связываться?» | Вероятность, например 0.97 |
| Выбор одного варианта | «Какая из четырёх команд должна ответить?» | Выбранный вариант, вероятность для каждого варианта и оценка уверенности |
| Оценка по шкале | «Насколько раздражён клиент по шкале из 5 ступеней?» | Позиция на шкале и разброс |
Писать ответы, вызывать инструменты и читать изображения она не умеет. TypeSafe обучает её методом, который сама называет обучением с подкреплением для калиброванных решений. Цель в том, чтобы «уверена на 90%» действительно означало «права примерно 9 раз из 10». Обычным языковым моделям это даётся плохо: известное исследование 2017 года показало, что современные нейросети, как правило, слишком самоуверенны (Guo et al., «On Calibration of Modern Neural Networks», ICML 2017). Необычна и тарификация: TypeSafe берёт плату только за входные токены, выходные бесплатны.
Может ли узкая и дешёвая модель для решений забрать у передовой LLM шаги «решить», не добавив ошибок? Вот наши данные.
Как мы тестировали?
Два раунда, одинаковые вопросы для всех моделей.
Раунд 1: размеченный тестовый набор. Мы составили 283 реалистичных кейса по 13 задачам принятия решений и до всякого запуска разметили правильный ответ для каждого: 189 стандартных кейсов и 94 более сложных. Сложные прогоняли трижды, чтобы проверить, повторяются ли ответы. В сумме вышло 471 прогон кейсов и 1,357 оценённых решений. Языки: английский, турецкий, четыре варианта арабского, арабский латиницей и ещё 10. Среди задач: направить сообщение нужному специалисту, распознать текст с prompt injection, определить по расшифровке телефонного звонка, чем он закончился, и отметить ответ, в котором названа цена, которую бизнес никогда не устанавливал. Jev и передовая модель Google Gemini (с низким уровнем рассуждений) получали одинаковые факты, вопросы и варианты.
Раунд 2: повтор реальной истории. Мы взяли 402 реальных решения о маршрутизации, которые наш продукт уже принял за 21 день в двух клиентских рабочих пространствах, заново прогнали те же диалоги через Jev и сравнили. Пространство A принадлежит фирме профессиональных услуг на Ближнем Востоке, там в основном арабский язык и WhatsApp. Пространство B принадлежит службе поддержки в сфере здравоохранения, там в основном английский и португальский в веб-чате. Исходные решения в обоих принимали передовые модели Google Gemini и OpenAI GPT. Имена, телефоны, email и ссылки мы замаскировали до того, как какой-либо текст покинул наши системы. Там, где Jev расходилась с исходным решением, мы читали диалог и определяли, какой ответ соответствует письменным правилам самого клиента. Кейсы, которые правила не решали однозначно, мы исключили.
Насколько точной была Jev на размеченном тесте?
Примерно такой же, как передовая модель: 98.5% против 99.0% на 1,357 оценённых решениях. И примерно в пять раз быстрее.
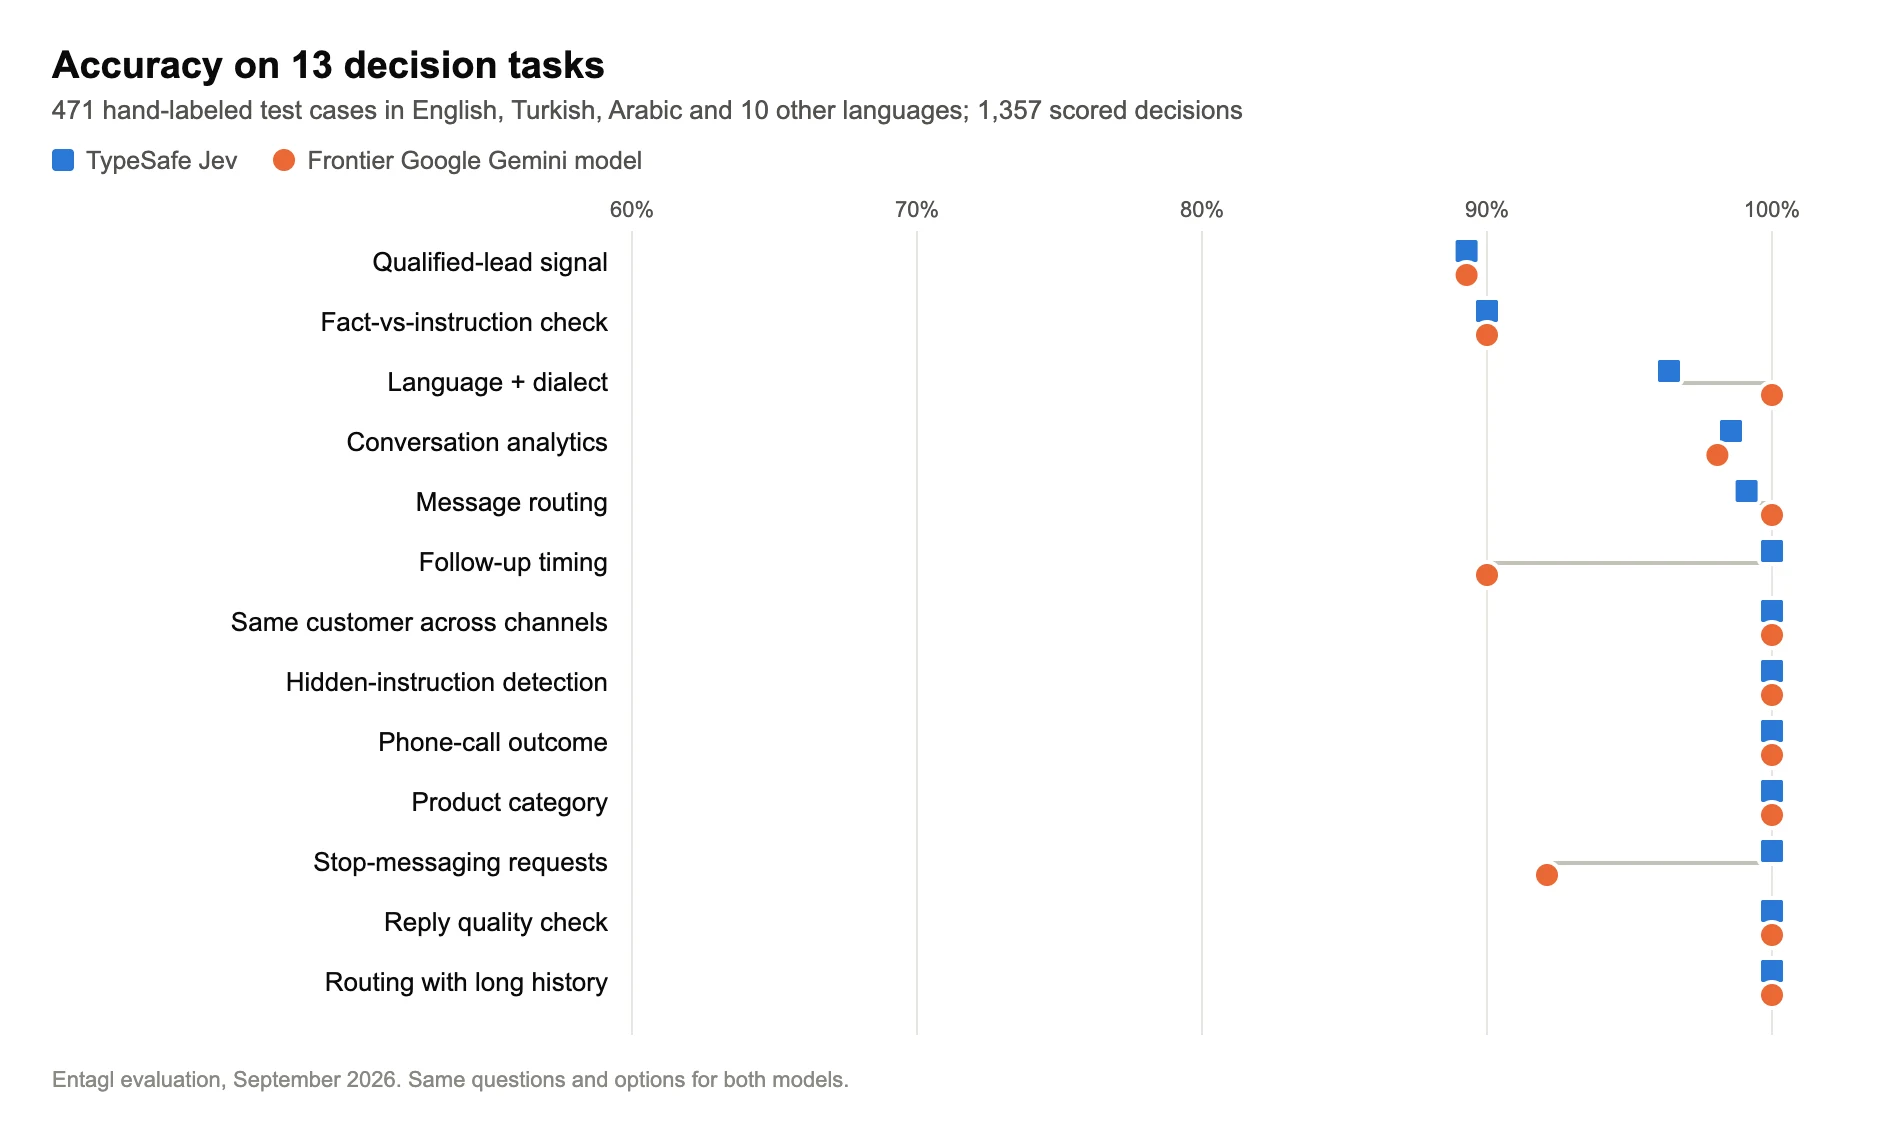
Разница небольшая, и она в пользу то одной, то другой модели. Jev поняла, что «мне это больше не интересно» не является просьбой отписаться, а Gemini отметила это сообщение как отписку. Ещё Gemini посчитала фразу «наша команда вам позвонит» переводом клиента на телефон и решила, что «дороговато, может быть позже» не стоит повторного контакта. А ведь именно такого лида и нужно мягко подтолкнуть.
Слабым местом Jev оказались арабские диалекты. Что текст на арабском, она определяла всегда, но два сообщения на заливном арабском в каждом прогоне принимала за египетский или левантийский (всего шесть промахов). А фразу «Сколько? 😍» обе модели сочли квалифицированным лидом, хотя по нашему правилу нужна цена плюс сроки или контактные данные. Проблема тут была в правиле, а не в моделях.
Можно ли доверять оценке уверенности?
На этом тесте да. Это самое полезное, что даёт Jev.
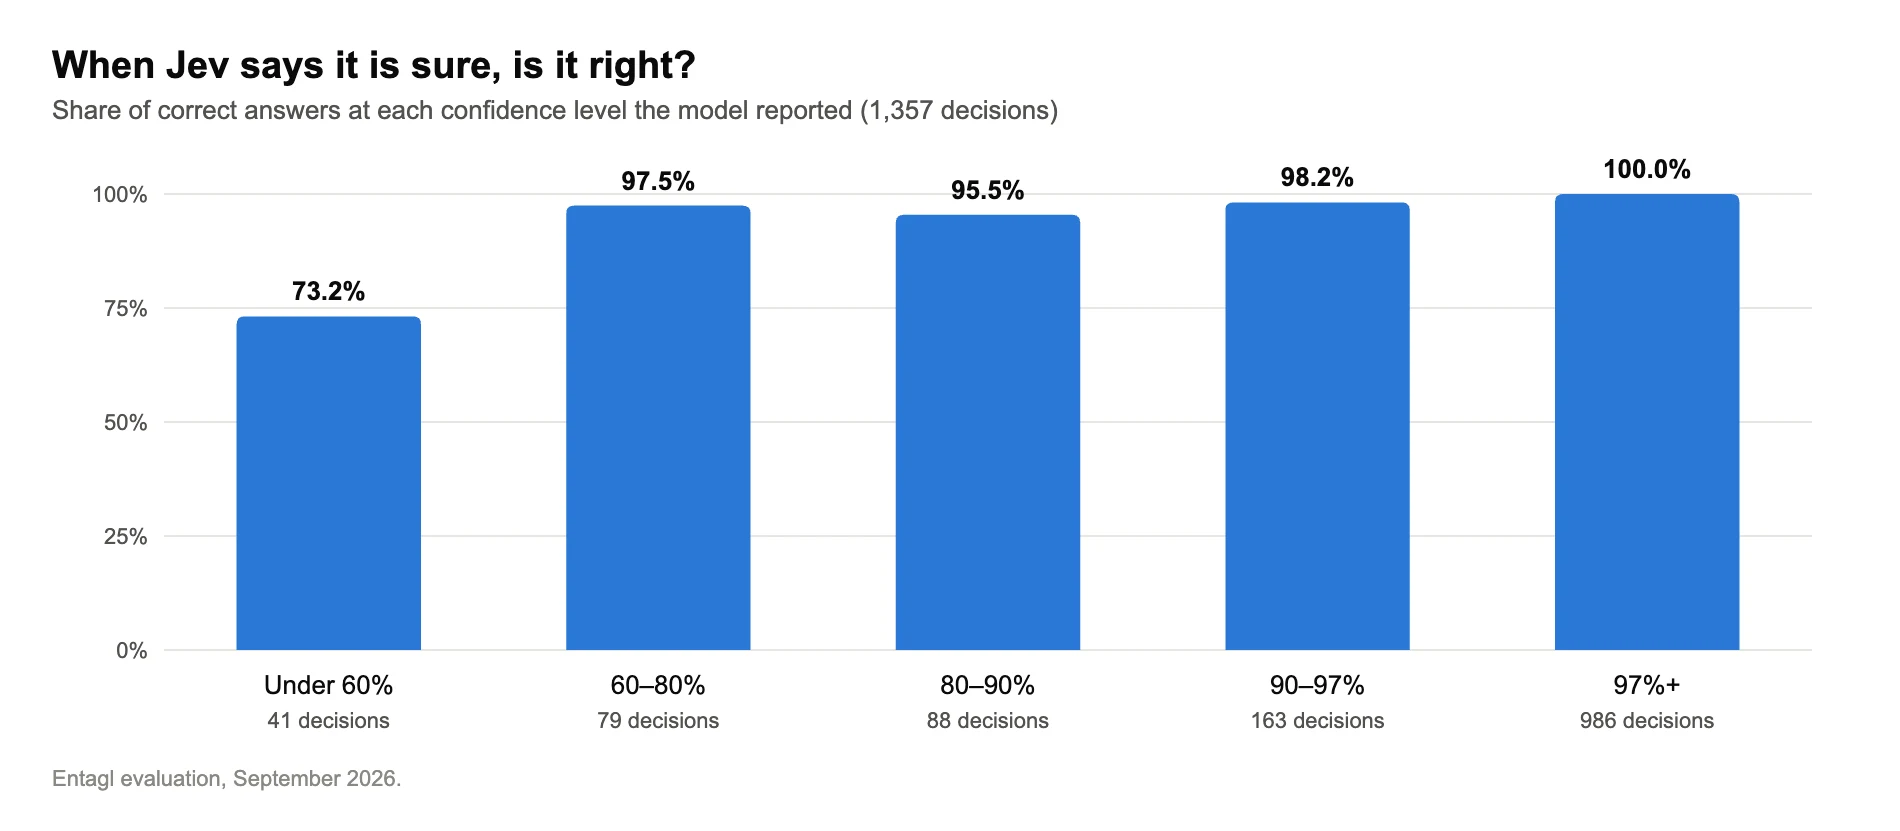
Задайте простое правило: «брать ответ Jev, только если она уверена хотя бы на 85%, иначе спрашивать большую модель». Тогда Jev закрывает 88% решений с точностью 99.75%, а 17 из её 20 ошибок уходят на резервную модель. Все промахи с арабскими диалектами шли с уверенностью от 0.36 до 0.40, так что правило их перехватило.
Одна ошибка всё же прошла с высокой уверенностью. Турецкое рекламное агентство написало «мы хотели бы с вами поработать». Jev во всех трёх прогонах приняла это за отклик на вакансию, с уверенностью 0.95. В контексте вреда не было (Jev заодно отметила сообщение как коммерческое предложение, и это решение имеет приоритет), но предупреждение справедливое: оценка уверенности служит доказательством, а не разрешением. После того как вы что-то включили, всё равно нужны размеченные проверки и отслеживание результатов.
Что произошло, когда мы повторили реальные диалоги?
Прямое совпадение с исходными решениями составило лишь 74–84%, но большая часть этого разрыва не связана с ошибками Jev.
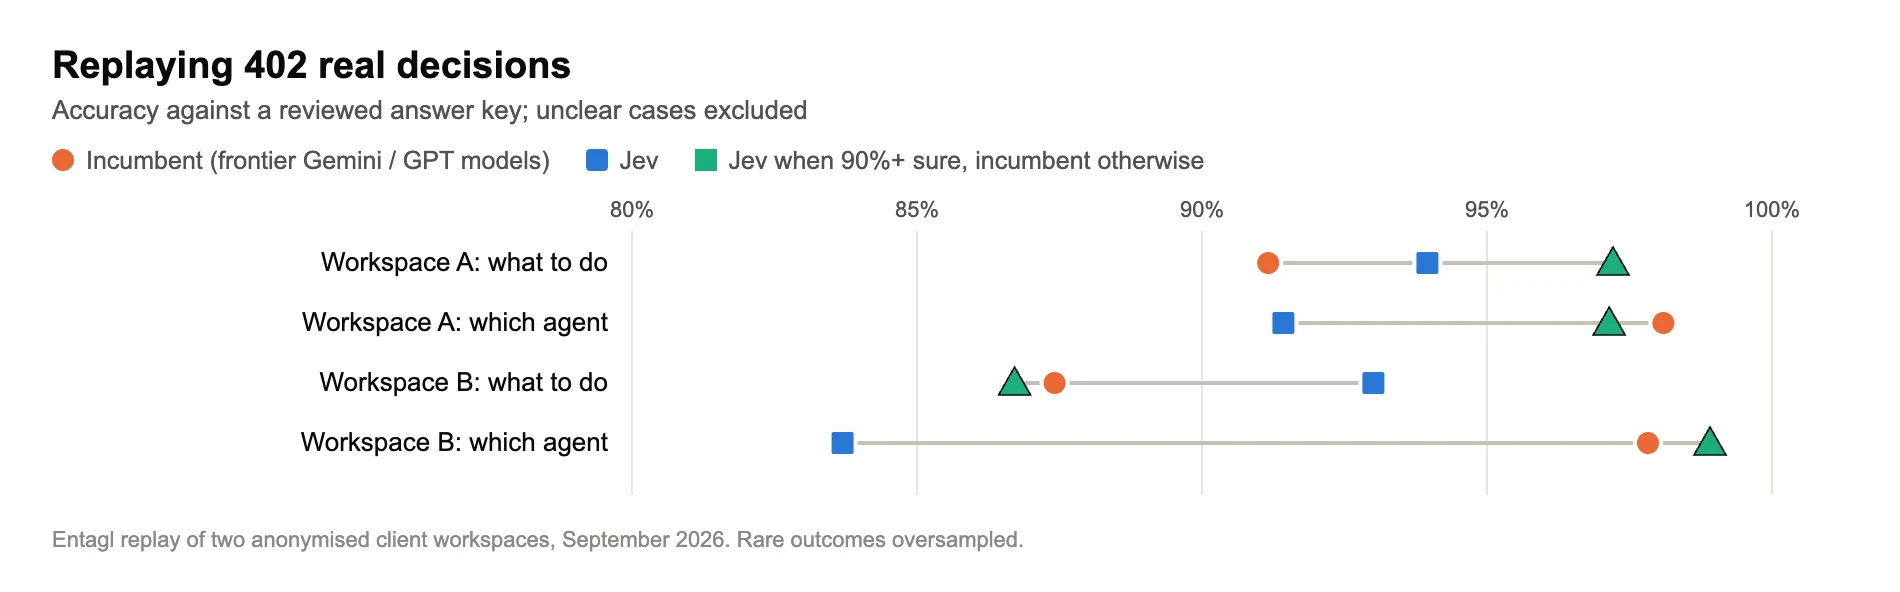
Результаты относительно проверенного ключа ответов:
| Решение | Исходное (передовые Gemini / GPT) | Jev | Jev при уверенности 90%+, иначе исходное |
|---|---|---|---|
| Пространство A: что делать с сообщением | 91.2% | 94.0% | 97.2% |
| Пространство A: какой специалист отвечает | 98.1% | 91.4% | 97.1% |
| Пространство B: что делать с сообщением | 87.4% | 93.0% | 86.7% |
| Пространство B: какой специалист отвечает | 97.8% | 83.7% | 98.9% |
Одна странность. В пространстве B порог уверенности немного ухудшил решение по сообщениям (86.7%): на тех сообщениях, где Jev сомневалась, откат к исходному решению означал использовать самые слабые ответы исходной системы.
Решение о том, что делать с сообщением (ответить, проигнорировать, передать человеку, отправить шаблонный ответ), в обоих пространствах удавалось Jev лучше. С выбором специалиста вышло иначе, и причина конкретная. Большинство промахов пришлось на продолжения вроде «Индия» или «обсужу завтра» в диалоге, который уже ведёт один специалист. Правила клиента требуют оставаться с этим специалистом. Jev видела последние восемь сообщений, но ей не сообщили, кто ведёт чат, поэтому она угадывала по словам. У исходной конфигурации этот контекст был, и она им пользовалась.
Повтор заодно выявил ошибки в исходных решениях, из тех, что выборочная проверка пропускает:
- Правило по ключевым словам, срабатывавшее не на тех людях. Шаблонный ответ с перенаправлением уходил каждому, кто употребил слово «юридический» или «юрист». В выборке из 20 таких случаев 15 оказались обычными деловыми вопросами вроде «какие юридические документы мне для этого нужны?». Jev направила их на полноценный ответ.
- Повторные передачи человеку. После того как клиент один раз оставил имя и номер, каждое следующее сообщение вроде «спасибо» или «obrigada» заново запускало передачу сотрудникам. Из 41 передачи в нашей выборке 17 были именно такими повторами.
- Два правила, противоречившие друг другу, из-за чего обе модели угадывали на одних и тех же сообщениях.
Мы отметили эти проблемы, чтобы исправить их у источника. Как раз о правилах по ключевым словам вроде первого предупреждает наше руководство о том, как остановить галлюцинации ИИ.
В чём Jev не дотягивает?
Без прикрас:
- Нюансы языков, кроме английского. В собственной документации TypeSafe сказано, что английский для неё основной язык обучения, а другие языки «поддерживаются, но не одинаково хорошо». Мы это увидели: 99.1% на английском, 98.4% на турецком, 96.5% на арабском. Шесть из девяти арабских промахов пришлись на путаницу диалектов. Остальные три дали одно пограничное сообщение «жалоба это или нет?» и разметка, о которой мы и сами готовы поспорить.
- Недостающий контекст, который нельзя вывести. Кто ведёт диалог, собраны ли уже контакты: в реальном повторе Jev теряла баллы каждый раз, когда ответ зависел от факта, которого не было в отправленном ей тексте. Решение в том, чтобы вычислять такие факты в коде и передавать модели, а не надеяться, что она догадается.
- Заранее заполненный текст из рекламы. Многие чаты в WhatsApp, начатые из рекламы с переходом в переписку, открываются шаблонной строкой вроде «Хочу узнать больше о ваших услугах». Jev опиралась на эту строку и пропустила как деловые лиды нескольких реальных соискателей и благотворительные запросы, один с уверенностью 0.92. Сначала удаляйте шаблон.
- То, для чего она не создавалась. TypeSafe сама перечисляет свои «неровные края»: арифметика, подсчёт, сравнение дат, длинные входные данные с кучей лишних деталей и текст, написанный для манипуляции моделью. Математику и даты держите в коде.
- Она совсем новая. Запуск в сентябре 2026 года, лимиты запросов, которые, по словам вендора, могут меняться. Всему, что на ней построено, нужен резервный вариант.
Где мы стали бы использовать модель для решений вроде Jev?
Везде, где LLM просят выбрать из списка и никто не читает её вывод:
- Первичная маршрутизация и отсев, с порогом уверенности и более крупной моделью в резерве.
- Ежедневная аналитика диалогов (категория, тональность, «спросил цену») по каждому диалогу, а не по выборке.
- Постоянно работающие проверки безопасности: просьбы прекратить переписку на любом языке или текст, который пытается давать указания ассистенту (см. наше руководство по prompt injection).
- Итоги звонков в виде данных, извлечённых из расшифровки.
И объединяйте вопросы в пакеты. Собственный тест TypeSafe на одном длинном документе показал, что 13 вопросов в одном вызове вместо 13 отдельных вызовов обходятся в 12.2 раза дешевле и в 10 раз быстрее при тех же ответах.
А где мы бы её не использовали: написание ответов, всё, что связано с числами, и любые случаи, где уверенный неверный ответ заставит замолчать реального клиента. Полная блокировка сообщения должна требовать очень высокой уверенности или второго мнения.
Как оценить модель для решений самостоятельно?
Что сработало у нас:
- Размечайте до запуска. «Совпадает с текущей моделью» и «правильно» не одно и то же. Наш повтор показал, что действующая система ошибалась достаточно часто, чтобы это имело значение.
- Разбивайте по языкам. Средние 98% могут скрывать 96% на языке, на котором реально пишут ваши клиенты.
- Постройте график точности по уверенности, затем повторите реальную историю. Дешёвая модель без надёжного порога становится обузой. На наших написанных вручную кейсах обе модели упёрлись почти в 100%, а различия, как и собственные баги действующей системы, проявились только на реальном трафике.
- Запустите в теневом режиме, прежде чем переключаться. Пусть новая модель молча работает рядом со старой, а переключайтесь по одной задаче, никогда не всё сразу.
Это часть более широкой мысли, которую мы уже высказывали: не ставьте продукт на одну-единственную модель ИИ. Модель, которая хороша для «решить», часто не годится для «написать», а небольшие и дешёвые модели сегодня берут на себя больше первой работы, чем думает большинство команд.
FAQ
Заменяет ли TypeSafe Jev GPT или Gemini?
Нет. Она заменяет один тип вызова: выбор из заданных вами вариантов, оценку по шкале или ответ да/нет. Писать текст, пользоваться инструментами и читать изображения она не умеет, поэтому агенту, который общается с клиентами, для самого ответа всё равно нужна языковая модель.
Насколько точна TypeSafe Jev по сравнению с передовыми LLM?
В нашем тесте в сентябре 2026 года на 1,357 размеченных решениях она набрала 98.5% против 99.0% у передовой модели Google Gemini. На реальной истории диалогов она лучше решала, что делать с сообщением, и хуже выбирала нужного специалиста посреди разговора.
Работает ли TypeSafe Jev на арабском и турецком?
Да, с оговоркой. Турецкий в нашем тесте был близок к английскому (98.4% против 99.1%). Арабский дал 96.5%. Большинство промахов пришлось на путаницу диалектов (заливной арабский принимался за египетский или левантийский), язык она не путала ни разу, и эти промахи шли с низкой уверенностью.
Можно ли полагаться на оценку уверенности Jev?
В наших данных она хорошо отражала точность: 100% верных ответов при уверенности 97% и выше, 73% при уверенности ниже 60%. Одна уверенная ошибка (0.95) всё же случилась, поэтому используйте оценку, чтобы решать, когда переходить на резервную модель, и продолжайте проверять реальные результаты.
Дешевле и быстрее ли она, чем LLM?
На наших тестовых вызовах она стоила примерно в 25 раз меньше и отвечала с медианой 329 ms против 1,598 ms. В основном потому, что Jev берёт плату только за входные токены и возвращает короткий типизированный ответ вместо сгенерированного текста.
Нужен ИИ, который знает, когда он не уверен?
Мы тестируем такие модели, чтобы агенты, которые отвечают вашим клиентам, правильно принимали дешёвые и быстрые решения, а сложные передавали чему-то покрупнее. Чтобы увидеть, как это работает на ваших собственных DM, запишитесь на 30-минутное демо или посмотрите, как с этим уже сегодня справляются наши ИИ-агенты для DM в Instagram и WhatsApp.
Источники и методика: оценка Entagl, сентябрь 2026 года. Раунд 1: 283 тестовых кейса с ручной разметкой (189 стандартных плюс 94 сложных, прогнанных трижды: 471 прогон кейсов), 1,357 оценённых решений, TypeSafe Jev (jev-1.13.0) против передовой модели Google Gemini на одинаковых входных данных; стоимость сравнивает оплаченные токены для одинаковых вызовов по прайс-листу каждого вендора на сентябрь 2026 года (Jev берёт плату только за входные токены). Раунд 2: 402 реальных решения о маршрутизации из двух анонимизированных клиентских рабочих пространств за 21 день, персональные данные замаскированы до обработки; расхождения проверены по письменным правилам каждого клиента, неясные случаи исключены, редкие исходы взяты с избыточной выборкой, поэтому проценты не являются средним по продакшену. Один проверяющий. Факты о вендоре: пост TypeSafe о запуске, документация моделей TypeSafe, известные ограничения Jev 1.13, руководство TypeSafe по параллельным вопросам. Контекст о калибровке: Guo et al., ICML 2017.