AI News · industry
TypeSafe Jev vs Gemini em 1.759 decisões: 5x mais rápido, 25x mais barato e 98,5% de acerto
Testamos o novo modelo de decisão da TypeSafe em 1.357 decisões rotuladas em 13 idiomas e em 402 conversas reais de clientes. Ele quase empatou com um LLM de ponta gastando uma fração do tempo e do custo, e depois mostrou exatamente onde quebra.
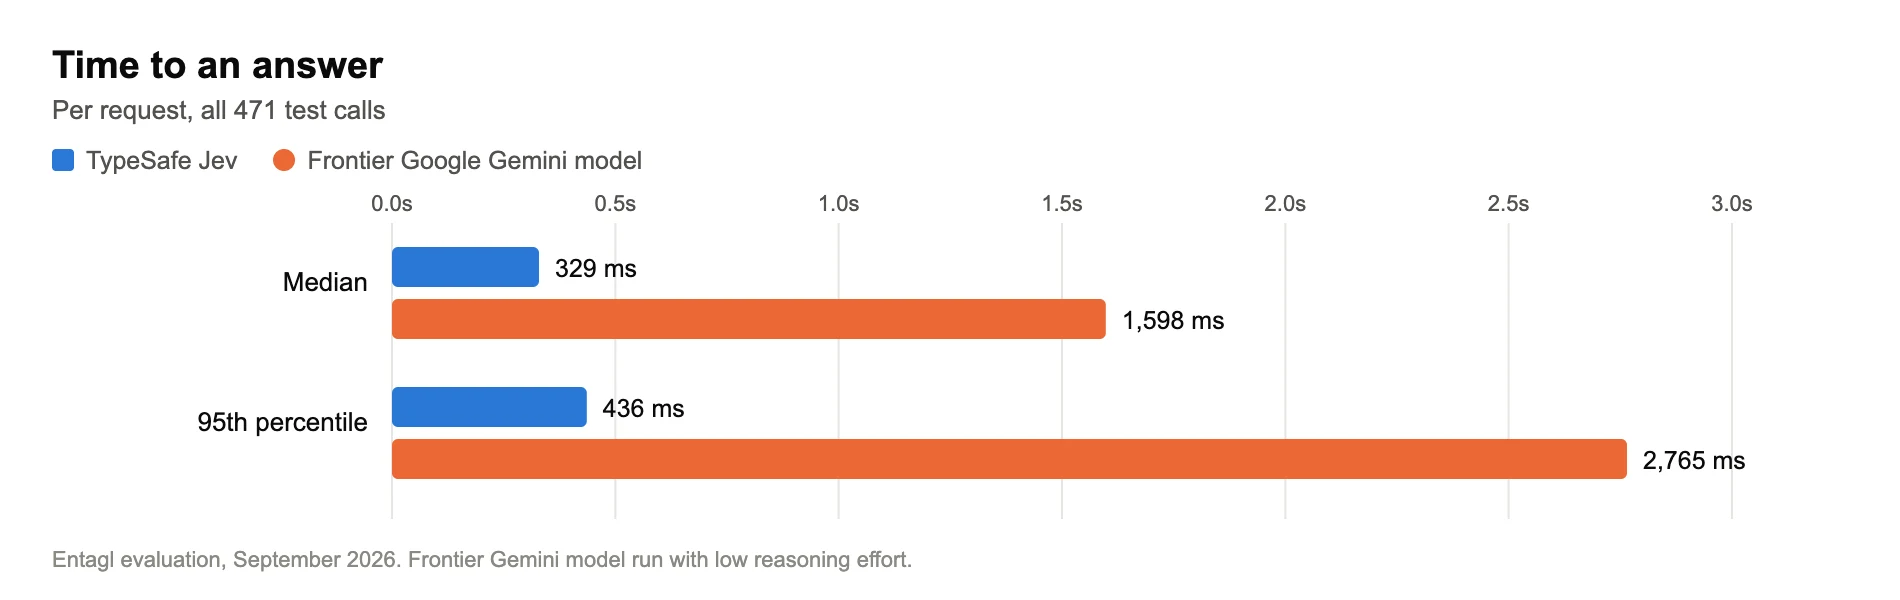
Demos ao TypeSafe Jev, o modelo só de decisão que a TypeSafe lançou em 15 de setembro, 1.759 decisões para tomar: 1.357 decisões de teste rotuladas à mão em 13 idiomas e 402 decisões reais de roteamento tiradas de conversas ao vivo com clientes. Contra um modelo Google Gemini de ponta, ele foi 5x mais rápido (mediana de 329 ms contra 1.598 ms), 25x mais barato e praticamente tão preciso quanto (98,5% contra 99,0%). Quando dizia ter 97% de certeza ou mais, acertou 986 vezes em 986.
Aí reproduzimos tráfego real de clientes, e ele falhou de formas que nenhum conjunto de teste previu. Está tudo aqui: os números, os gráficos, os pontos cegos e onde usaríamos (ou não) esse modelo.
O que é o TypeSafe Jev e em que ele difere de um LLM?
A TypeSafe anunciou o Jev em 15 de setembro de 2026 como seu primeiro modelo "System One", nome emprestado do pensamento rápido e intuitivo do Sistema 1 descrito por Daniel Kahneman. Você não pede texto a ele. Você envia os fatos (uma mensagem, um histórico curto, uma lista de opções) e perguntas tipadas, e ele devolve um de três tipos de resposta:
| Tipo de pergunta | O que você pergunta | O que volta |
|---|---|---|
| Sim/não | "Esta mensagem pede para pararmos de entrar em contato?" | Uma probabilidade, por exemplo 0,97 |
| Escolha única | "Qual destas quatro equipes deve responder?" | A escolha, uma probabilidade para cada opção e um índice de confiança |
| Nota | "Quão frustrado está este cliente, numa escala de 5 níveis?" | Uma posição na escala e a dispersão |
Ele não escreve respostas, não chama ferramentas e não lê imagens. A TypeSafe o treina com o que chama de aprendizado por reforço para decisões calibradas. A ideia é que "90% de certeza" signifique mesmo acertar cerca de 9 em cada 10 vezes, algo em que os modelos de linguagem comuns vão mal. Um estudo conhecido de 2017 mostrou que as redes neurais modernas tendem ao excesso de confiança (Guo et al., "On Calibration of Modern Neural Networks," ICML 2017). O preço também foge do padrão: a TypeSafe cobra só pelos tokens de entrada; a saída é gratuita.
Um modelo de decisão estreito e barato consegue assumir as etapas de "decidir" de um LLM de ponta sem errar mais? Veja o que os nossos dados dizem.
Como fizemos o teste?
Duas rodadas, com as mesmas perguntas para todos os modelos.
Rodada 1: um conjunto de teste rotulado. Escrevemos 283 casos realistas em 13 tarefas de decisão e rotulamos a resposta correta de cada um antes de rodar qualquer coisa: 189 casos padrão e 94 mais difíceis. Os difíceis rodaram três vezes para conferir se as respostas se repetem, somando 471 execuções e 1.357 decisões avaliadas. Idiomas: inglês, turco, quatro variedades de árabe, árabe escrito em letras latinas e mais 10. Entre as tarefas estavam encaminhar uma mensagem ao especialista certo, identificar texto de prompt injection, ler a transcrição de uma ligação para extrair o resultado e sinalizar uma resposta que cita um preço que a empresa nunca definiu. O Jev e um modelo Google Gemini de ponta (com esforço de raciocínio baixo) receberam exatamente os mesmos fatos, perguntas e opções.
Rodada 2: reprodução do histórico real. Pegamos 402 decisões reais de roteamento que o nosso produto já tinha tomado para dois clientes ao longo de 21 dias, passamos as mesmas conversas pelo Jev e comparamos. O Workspace A é uma empresa de serviços profissionais no Oriente Médio, com a maior parte das conversas em árabe no WhatsApp. O Workspace B é um serviço de atendimento em saúde, principalmente em inglês e português no chat do site. As decisões originais vieram de modelos de ponta Google Gemini e OpenAI GPT. Nomes, telefones, e-mails e links foram mascarados antes de qualquer texto sair dos nossos sistemas. Quando o Jev e a decisão original discordavam, lemos a conversa e julgamos qual resposta seguia as regras escritas do próprio cliente. Os casos que as regras não resolviam ficaram de fora.
Qual foi a precisão do Jev no teste rotulado?
Praticamente a mesma do modelo de ponta: 98,5% contra 99,0% em 1.357 decisões avaliadas, e cerca de cinco vezes mais rápido.
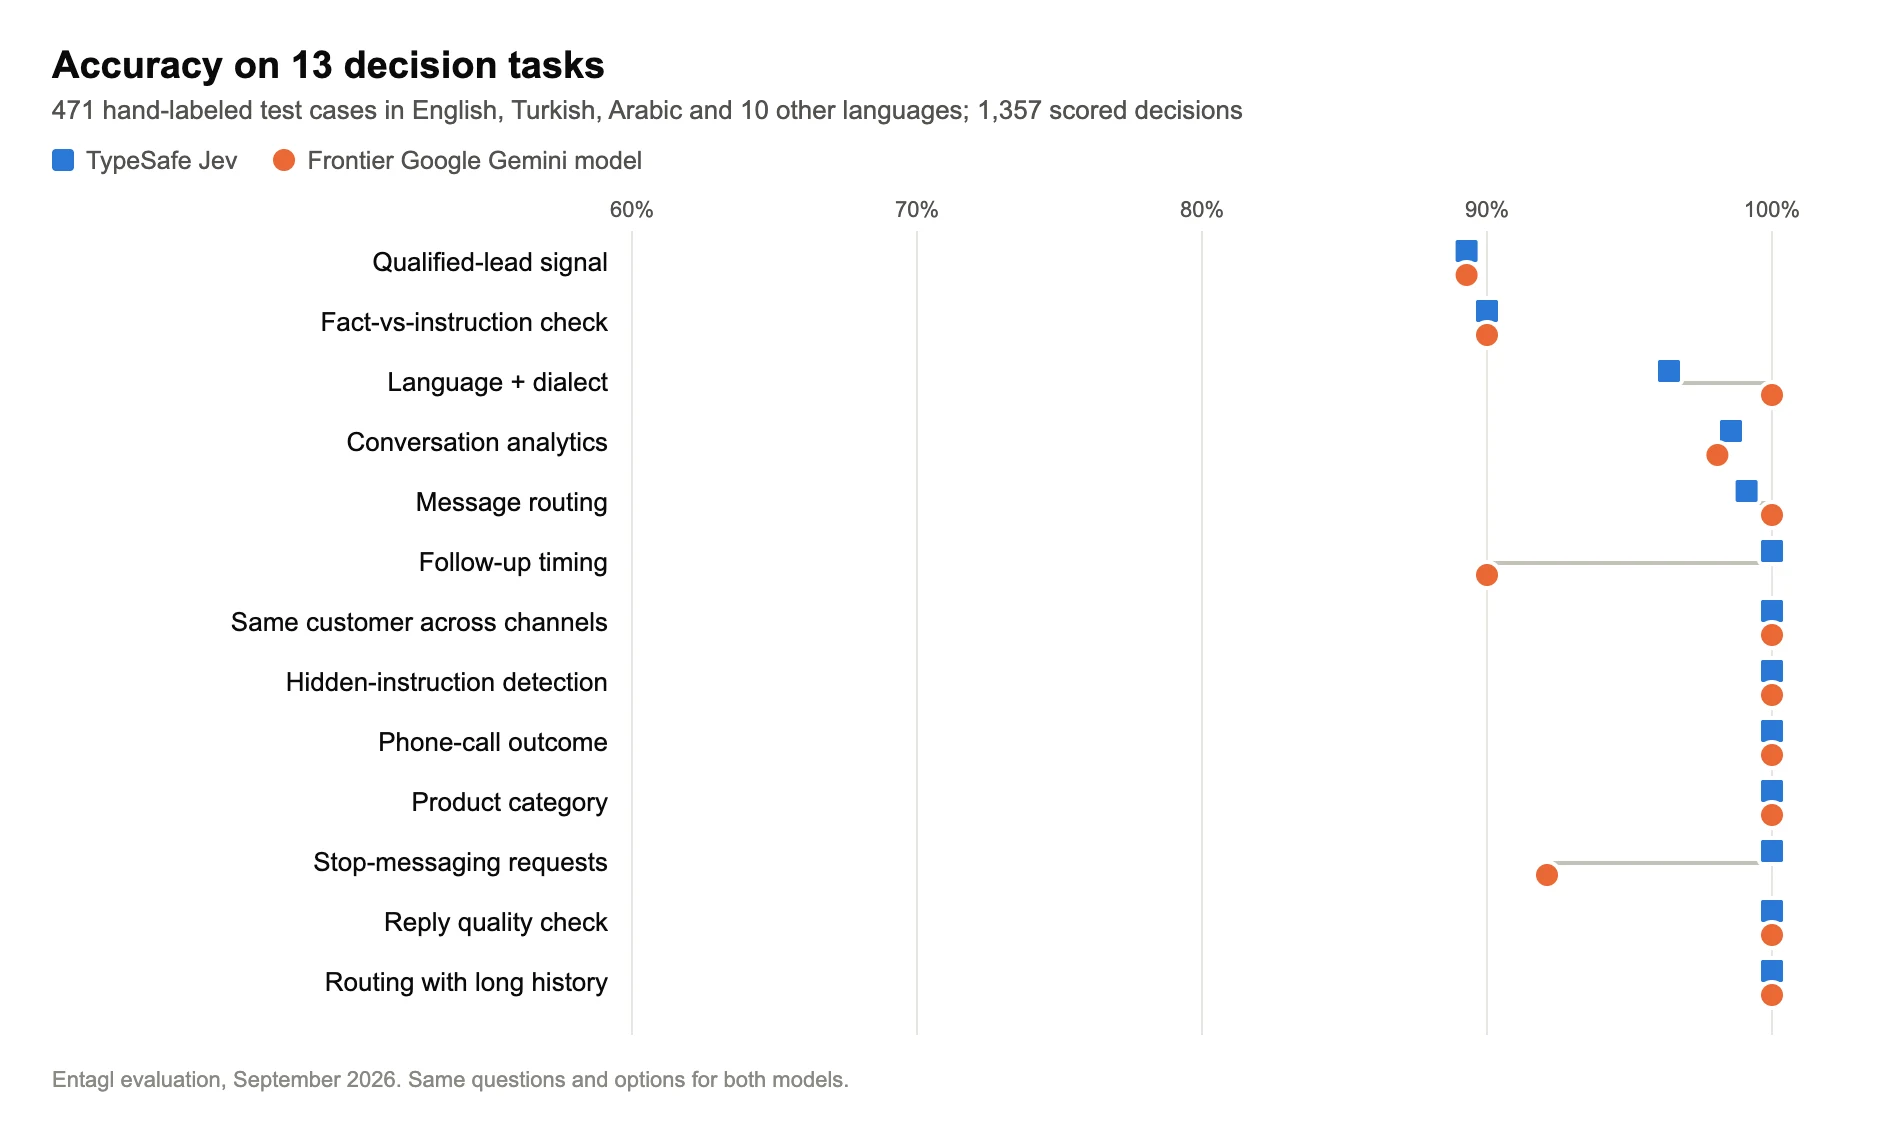
As diferenças são pequenas e vão para os dois lados. O Jev entendeu que "não tenho mais interesse" não é um pedido de descadastro; o Gemini marcou como se fosse. O Gemini também considerou que "nossa equipe vai te ligar" era mandar o cliente para o telefone, e julgou que "tá um pouco caro, quem sabe depois" não valia um follow-up, justamente o lead que você quer reativar.
O ponto fraco do Jev foram os dialetos árabes. Ele sempre soube que o texto estava em árabe, mas duas mensagens em árabe do Golfo foram lidas como egípcio ou levantino em todas as execuções (seis erros no total). E os dois modelos classificaram "Quanto custa? 😍" como lead qualificado, quando a nossa regra exigia preço mais prazo ou dados de contato. Ali o problema era a regra, não os modelos.
Dá para confiar no índice de confiança?
Neste teste, sim. É a coisa mais útil que o Jev oferece.
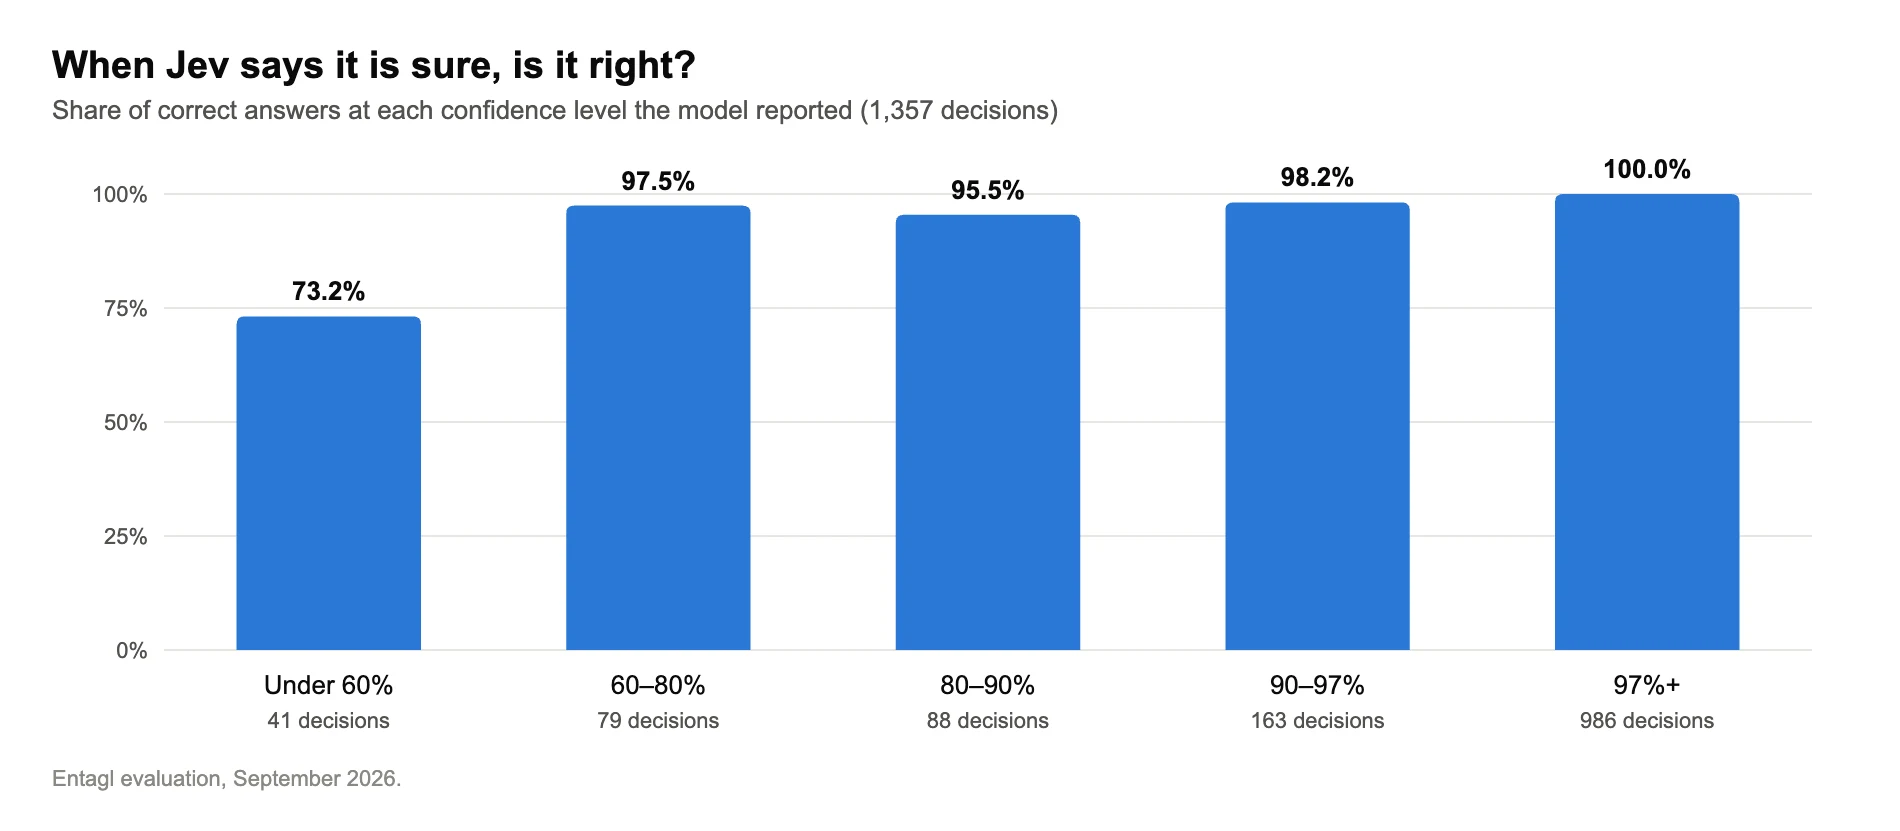
Defina uma regra simples, "use a resposta do Jev só quando ele tiver pelo menos 85% de certeza; caso contrário, pergunte ao modelo maior", e o Jev resolve 88% das decisões com 99,75% de acerto, enquanto 17 dos seus 20 erros são enviados para o modelo de reserva. Todos os erros de dialeto árabe vieram com confiança entre 0,36 e 0,40, então a regra pegou todos.
Um erro ainda passou com confiança alta. Uma agência de publicidade turca escreveu "gostaríamos de trabalhar com vocês". O Jev leu como candidatura a emprego, com 0,95, nas três execuções. No contexto não causou dano (o Jev também marcou a mensagem como proposta comercial, e essa decisão prevalece), mas fica o alerta: um índice de confiança é evidência, não autorização. Você continua precisando de verificações rotuladas e de acompanhar os resultados depois de ativar qualquer coisa.
O que aconteceu quando reproduzimos conversas reais?
A concordância bruta com as decisões originais foi de só 74–84%, mas a maior parte dessa diferença não era erro do Jev.
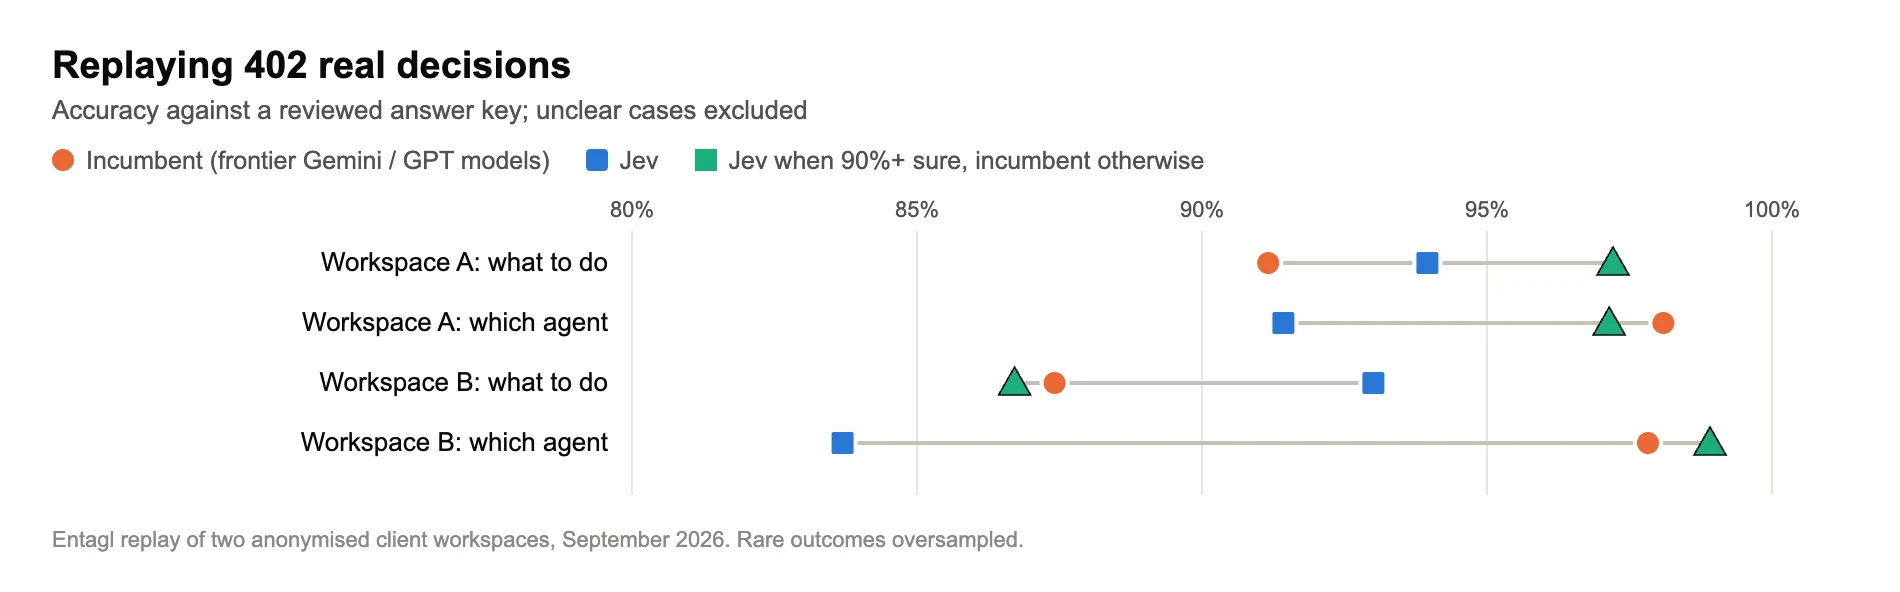
Avaliado contra o gabarito revisado:
| Decisão | Original (Gemini / GPT de ponta) | Jev | Jev com 90%+ de certeza, original nos demais casos |
|---|---|---|---|
| Workspace A: o que fazer com a mensagem | 91,2% | 94,0% | 97,2% |
| Workspace A: qual especialista responde | 98,1% | 91,4% | 97,1% |
| Workspace B: o que fazer com a mensagem | 87,4% | 93,0% | 86,7% |
| Workspace B: qual especialista responde | 97,8% | 83,7% | 98,9% |
Uma curiosidade: no Workspace B, o filtro por confiança piorou um pouco a decisão sobre a mensagem (86,7%), porque nas mensagens em que o Jev estava inseguro, voltar ao original significava usar justamente as respostas mais fracas do original.
Decidir o que fazer com uma mensagem (responder, ignorar, passar para um humano, enviar uma resposta pronta) favoreceu o Jev nos dois workspaces. Escolher o especialista, não, e o motivo é bem específico. A maioria dos erros foram mensagens de continuação como "Índia" ou "vou conversar amanhã" numa conversa que já estava com um especialista. As regras do cliente mandam manter esse especialista. O Jev via as últimas oito mensagens, mas ninguém dizia a ele quem era o dono da conversa, então ele chutava pelas palavras. A configuração original tinha esse contexto e o usava.
A reprodução também encontrou erros nas decisões originais, do tipo que uma checagem por amostragem deixa passar:
- Uma regra de palavra-chave disparando para as pessoas erradas. Uma resposta pronta de encaminhamento saía sempre que alguém usava a palavra "legal" ou "advogado". Numa amostra de 20, 15 eram perguntas comerciais comuns, como "quais documentos legais eu preciso para isso?". O Jev mandou essas mensagens para uma resposta de verdade.
- Transferências repetidas. Depois que o cliente já tinha informado nome e número uma vez, mensagens seguintes como "thanks" ou "obrigada" disparavam cada uma uma nova transferência para a equipe. 17 das 41 transferências que amostramos eram repetições assim.
- Duas regras que se contradiziam, então os dois modelos estavam chutando nas mesmas mensagens.
Já sinalizamos esses pontos para correção na origem. Regras de palavra-chave como a primeira são exatamente o que o nosso guia para evitar alucinações de IA recomenda evitar.
Onde o Jev deixa a desejar?
Sem rodeios:
- Nuances fora do inglês. A própria documentação da TypeSafe diz que o inglês é o principal idioma de treino e que os outros são "atendidos, mas não com a mesma qualidade". Foi o que vimos: 99,1% em inglês, 98,4% em turco, 96,5% em árabe. Seis dos nove erros em árabe foram confusões de dialeto; os outros três vieram de uma mensagem limítrofe do tipo "isto é uma reclamação?" e de um rótulo que nós mesmos discutiríamos.
- Contexto que ele não tem como deduzir. Quem é o dono da conversa, se os dados de contato já foram coletados: na reprodução real, o Jev perdia pontos sempre que a resposta dependia de um fato que não estava no texto enviado. A solução é calcular esses fatos no código e entregá-los prontos, não torcer para o modelo adivinhar.
- Texto pré-preenchido de anúncios. Muitas conversas de WhatsApp vindas de anúncios de clique para mensagem começam com uma frase-modelo como "Gostaria de saber mais sobre os seus serviços". O Jev se apoiou nessa frase e deixou passar vários candidatos a emprego e pedidos de doação como leads comerciais, um deles com 0,92 de confiança. Remova o texto-modelo antes.
- Coisas para as quais ele nunca foi feito. A TypeSafe lista as suas próprias "arestas irregulares": aritmética, contagem, comparação de datas, entradas longas cheias de detalhes irrelevantes e textos escritos para manipulá-lo. Deixe contas e datas no código.
- Ele é novíssimo. Lançado em setembro de 2026, com limites de uso que o fornecedor diz que podem mudar. Qualquer coisa construída sobre ele precisa de um plano B.
Onde usaríamos um modelo de decisão como o Jev?
Em qualquer lugar onde um LLM precisa escolher de uma lista e ninguém lê a saída:
- Roteamento e triagem inicial, com um filtro de confiança e um modelo maior por trás.
- Análise diária de conversas (categoria, sentimento, "perguntou o preço") em todas as conversas, não numa amostra.
- Verificações de segurança sempre ligadas: pedidos para parar de receber mensagens em qualquer idioma, ou textos tentando dar instruções ao assistente (veja o nosso guia sobre prompt injection).
- Resultados de ligações como dados, extraídos da transcrição.
Agrupe também as suas perguntas: no próprio teste da TypeSafe com um documento longo, fazer 13 perguntas numa única chamada em vez de 13 chamadas saiu 12,2 vezes mais barato e 10 vezes mais rápido, com as mesmas respostas.
E onde não usaríamos: para escrever respostas, para qualquer coisa numérica, para qualquer caso em que uma resposta errada dada com confiança silencie um cliente real. Bloquear uma mensagem de vez deveria exigir confiança muito alta ou uma segunda opinião.
Como avaliar um modelo de decisão por conta própria?
O que funcionou para nós:
- Rotule antes de rodar. "Concorda com o modelo atual" não é o mesmo que "está correto". A nossa reprodução mostrou que o modelo em uso errava com frequência suficiente para fazer diferença.
- Separe por idioma. Uma média de 98% pode esconder 96% justamente no idioma que os seus clientes usam.
- Monte o gráfico de precisão por confiança e depois reproduza o histórico real. Um modelo barato sem um filtro confiável é um risco, e os nossos casos escritos chegaram perto de 100% para os dois modelos; foi no tráfego real que apareceram as diferenças, e os bugs do próprio modelo em uso.
- Rode em sombra antes de trocar. Coloque o novo modelo para rodar em silêncio ao lado do antigo e troque tarefa por tarefa, nunca tudo de uma vez.
Isso se liga a um ponto mais amplo que já defendemos: não apostar o seu produto num único modelo de IA. O modelo certo para "decidir" muitas vezes não é o certo para "escrever", e modelos menores e mais baratos já dão conta de boa parte da primeira tarefa, mais do que a maioria das equipes imagina.
FAQ
O TypeSafe Jev substitui o GPT ou o Gemini?
Não. Ele substitui um tipo de chamada: escolher entre opções que você define, dar uma nota numa escala ou responder sim/não. Ele não escreve texto, não usa ferramentas e não lê imagens, então um agente que fala com clientes continua precisando de um modelo de linguagem para a resposta.
Qual é a precisão do TypeSafe Jev comparado aos LLMs de ponta?
No nosso teste de setembro de 2026 com 1.357 decisões rotuladas, ele marcou 98,5%, contra 99,0% de um modelo Google Gemini de ponta. No histórico real de conversas, foi melhor em decidir o que fazer com uma mensagem e pior em escolher o especialista certo no meio da conversa.
O TypeSafe Jev funciona em árabe e turco?
Sim, com uma ressalva. O turco ficou perto do inglês no nosso teste (98,4% contra 99,1%). O árabe ficou em 96,5%. A maioria dos erros foi confusão de dialeto (Golfo lido como egípcio ou levantino), nunca o idioma errado, e esses erros vieram com índices de confiança baixos.
Dá para confiar no índice de confiança do Jev?
Nos nossos dados ele acompanhou bem a precisão: 100% de acerto com 97% de confiança ou mais, 73% abaixo de 60%. Ainda houve um erro confiante (0,95), então use o índice para decidir quando recorrer ao modelo maior e continue acompanhando os resultados reais.
Ele é mais barato e mais rápido que um LLM?
Nas nossas chamadas de teste, custou cerca de 25 vezes menos e respondeu com mediana de 329 ms contra 1.598 ms, principalmente porque o Jev cobra só os tokens de entrada e devolve uma resposta curta e tipada em vez de texto gerado.
Quer uma IA que sabe quando não tem certeza?
Testamos modelos assim para que os agentes que atendem os seus clientes acertem as decisões baratas e rápidas e passem as difíceis para algo maior. Para ver como isso funciona nas suas próprias DMs, agende uma demonstração de 30 minutos ou veja como os nossos agentes de IA para DMs de Instagram e WhatsApp já cuidam disso hoje.
Fontes e método: avaliação da Entagl, setembro de 2026. Rodada 1: 283 casos de teste rotulados à mão (189 padrão, mais 94 casos difíceis executados três vezes: 471 execuções), 1.357 decisões avaliadas, TypeSafe Jev (jev-1.13.0) contra um modelo Google Gemini de ponta com entradas idênticas; o custo compara os tokens cobrados em chamadas idênticas pelo preço de tabela de cada fornecedor em setembro de 2026 (o Jev cobra só os tokens de entrada). Rodada 2: 402 decisões reais de roteamento de dois clientes anonimizados ao longo de 21 dias, com dados pessoais mascarados antes do processamento; as divergências foram revisadas contra as regras escritas de cada cliente, casos pouco claros foram excluídos e resultados raros foram sobreamostrados, então os percentuais não representam uma média de produção. Um revisor. Dados do fornecedor: post de lançamento da TypeSafe, documentação dos modelos da TypeSafe, limitações conhecidas do Jev 1.13, guia de perguntas em paralelo da TypeSafe. Base sobre calibração: Guo et al., ICML 2017.