AI News · industry
TypeSafe Jev contro Gemini su 1.759 decisioni: 5x più veloce, 25x più economico, 98,5% di accuratezza
Abbiamo messo alla prova il nuovo modello di sole decisioni di TypeSafe su 1.357 decisioni etichettate in 13 lingue e su 402 chat reali con i clienti. Ha quasi eguagliato un LLM di frontiera con una frazione del tempo e del costo, poi ci ha mostrato con precisione dove si rompe.
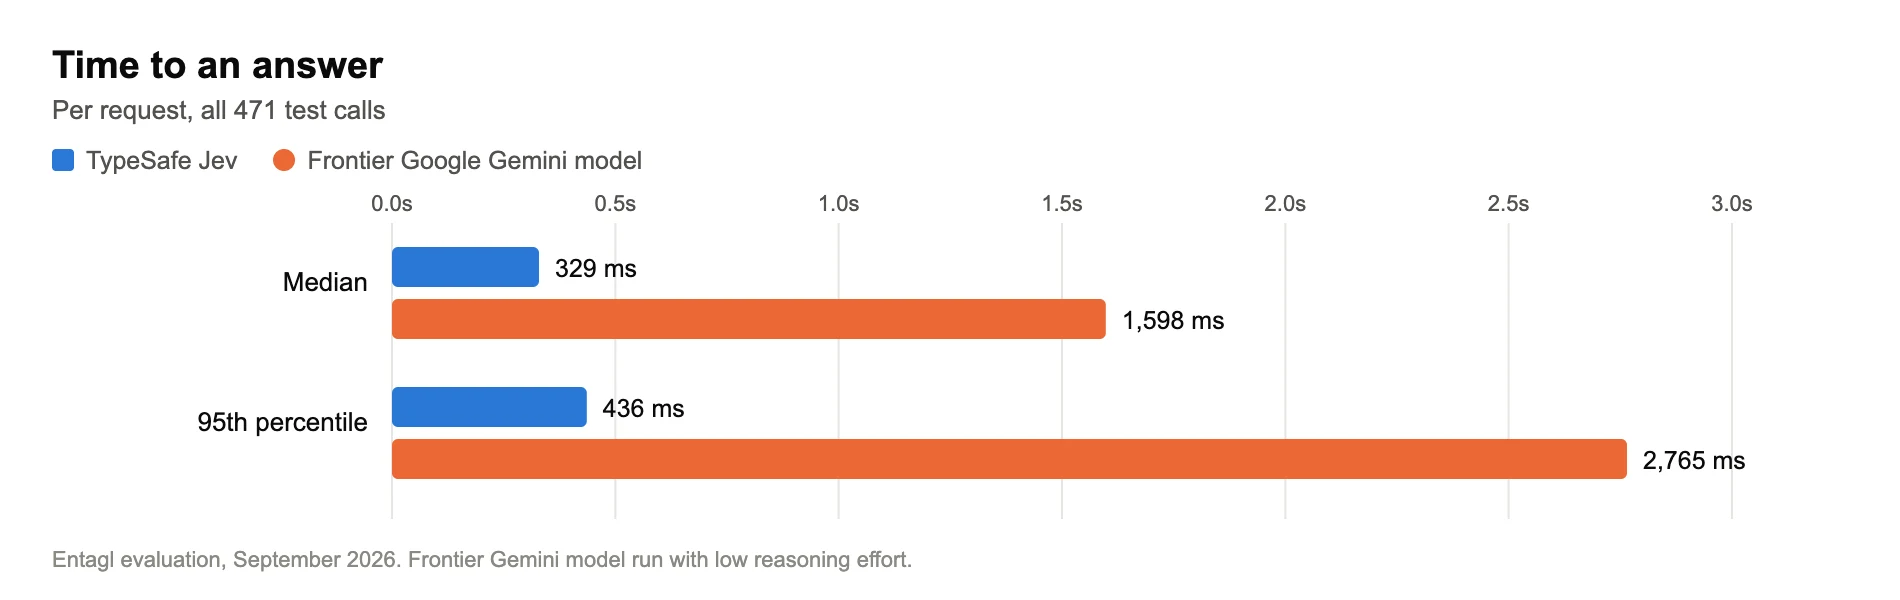
Abbiamo affidato a TypeSafe Jev, il modello di sole decisioni lanciato da TypeSafe il 15 settembre, 1.759 decisioni: 1.357 decisioni di test etichettate a mano in 13 lingue e 402 decisioni di instradamento reali prese da chat dal vivo con i clienti. Messo a confronto con un modello Google Gemini di frontiera, è risultato 5 volte più veloce (mediana di 329 ms contro 1.598 ms), 25 volte più economico e accurato quasi allo stesso livello (98,5% contro 99,0%). Quando si dichiarava sicuro al 97% o più, aveva ragione 986 volte su 986.
Poi abbiamo riprodotto traffico reale dei clienti, e lì ha ceduto in modi che nessun set di test lasciava prevedere. Qui trovate tutto: i numeri, i grafici, i punti ciechi e dove lo useremmo oppure no.
Che cos'è TypeSafe Jev e in cosa si differenzia da un LLM?
TypeSafe ha annunciato Jev il 15 settembre 2026 come il suo primo modello "System One", nome preso in prestito dal Sistema 1 di Daniel Kahneman, quello del pensiero rapido e intuitivo. Non gli si chiede di scrivere testo. Gli si passano i fatti (un messaggio, una breve cronologia, un elenco di opzioni) e delle domande tipizzate, e lui restituisce uno di tre tipi di risposta:
| Tipo di domanda | Cosa chiedete | Cosa ottenete |
|---|---|---|
| Sì/no | "Questo messaggio ci chiede di non contattarlo più?" | Una probabilità, ad esempio 0,97 |
| Scelta singola | "Quale di questi quattro team deve rispondere?" | La scelta, una probabilità per ogni opzione e un punteggio di confidenza |
| Punteggio | "Quanto è frustrato questo cliente, su una scala a 5 livelli?" | Una posizione sulla scala più la dispersione |
Non sa scrivere risposte, chiamare strumenti o leggere immagini. TypeSafe lo addestra con quello che chiama apprendimento per rinforzo per decisioni calibrate. L'obiettivo è che "sicuro al 90%" significhi davvero avere ragione circa 9 volte su 10, un aspetto in cui i normali modelli linguistici se la cavano male. Un noto studio del 2017 ha rilevato che le reti neurali moderne tendono a essere troppo sicure di sé (Guo et al., "On Calibration of Modern Neural Networks," ICML 2017). Anche il prezzo è insolito: TypeSafe fa pagare solo i token in input; l'output è gratuito.
Un modello decisionale specializzato ed economico può prendersi i passaggi di "decisione" di un LLM di frontiera senza aumentare gli errori? Ecco i nostri dati.
Come l'abbiamo testato?
Due round, con le stesse domande per ogni modello.
Round 1: un set di test etichettato. Abbiamo scritto 283 casi realistici su 13 compiti decisionali, etichettando la risposta corretta di ciascuno prima di eseguire qualsiasi cosa: 189 casi standard e 94 più difficili. Quelli difficili sono stati eseguiti tre volte per verificare che le risposte si ripetessero, per un totale di 471 esecuzioni e 1.357 decisioni valutate. Le lingue: inglese, turco, quattro varietà di arabo, arabo in caratteri latini e altre 10. Tra i compiti c'erano l'instradamento di un messaggio allo specialista giusto, l'individuazione di testo di prompt injection, la lettura della trascrizione di una telefonata per capirne l'esito e la segnalazione di una risposta che cita un prezzo mai fissato dall'azienda. Sia Jev sia un modello Google Gemini di frontiera (con basso sforzo di ragionamento) hanno ricevuto fatti, domande e opzioni identici.
Round 2: la riproduzione dello storico reale. Abbiamo preso 402 decisioni di instradamento reali che il nostro prodotto aveva già preso per due workspace di clienti nell'arco di 21 giorni, abbiamo fatto passare le stesse conversazioni da Jev e abbiamo confrontato i risultati. Il Workspace A è uno studio di servizi professionali in Medio Oriente, soprattutto in arabo su WhatsApp. Il Workspace B è un servizio di assistenza sanitaria, soprattutto in inglese e portoghese via web chat. Le decisioni originali provenivano da modelli di frontiera Google Gemini e OpenAI GPT. Nomi, numeri di telefono, email e link sono stati mascherati prima che qualsiasi testo uscisse dai nostri sistemi. Dove Jev e la decisione originale non coincidevano, abbiamo letto la conversazione e stabilito quale risposta rispettava le regole scritte del cliente. I casi che le regole non risolvevano sono stati esclusi.
Quanto è stato accurato Jev sul test etichettato?
Accurato quasi quanto il modello di frontiera: 98,5% contro 99,0% su 1.357 decisioni valutate, e circa cinque volte più veloce.
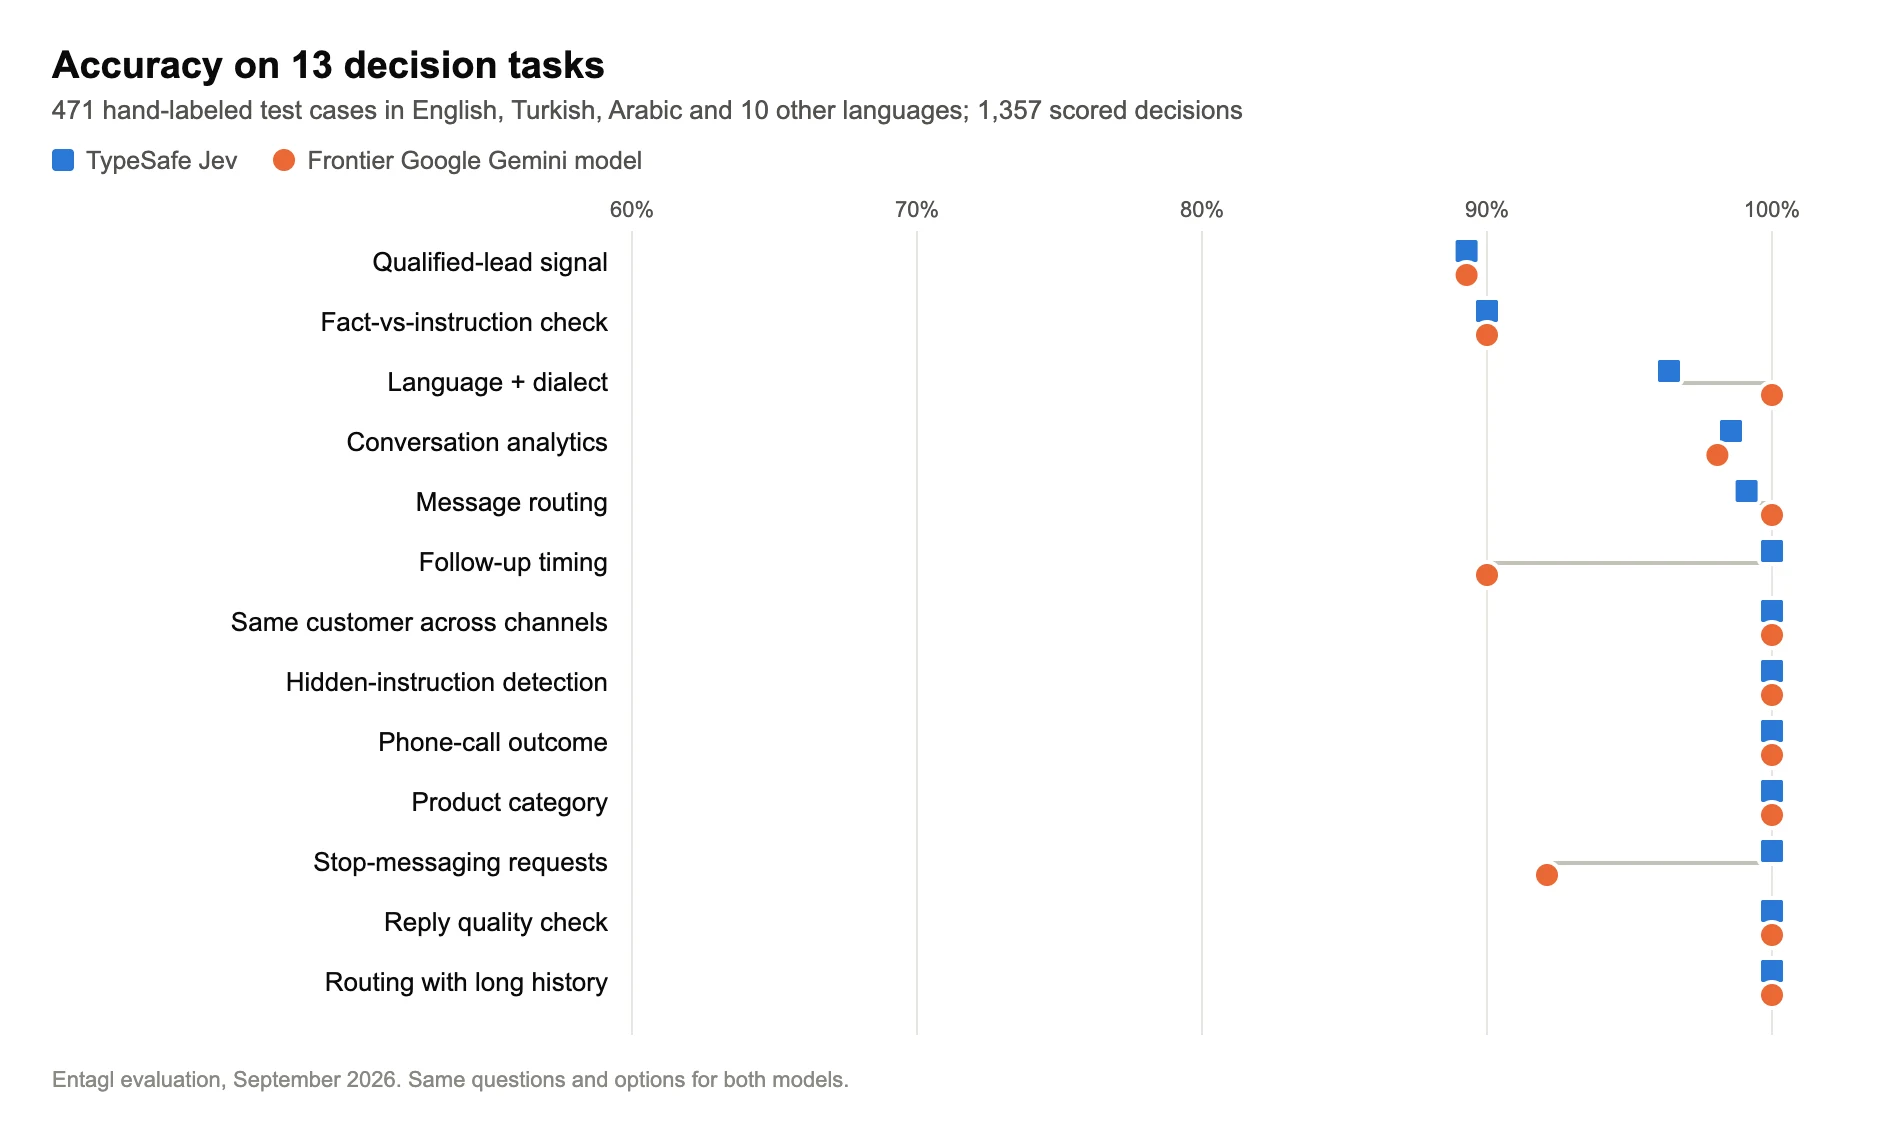
Le differenze sono piccole e vanno in entrambe le direzioni. Jev ha capito che "non mi interessa più" non è una richiesta di disiscrizione; Gemini invece l'ha segnalata come tale. Gemini ha anche interpretato "il nostro team la chiamerà" come un invio del cliente al telefono, e ha giudicato "un po' caro, magari più avanti" non meritevole di follow-up, quando è proprio il tipo di contatto che conviene sollecitare.
Il punto debole di Jev sono stati i dialetti arabi. Ha sempre riconosciuto che il testo era in arabo, ma due messaggi in arabo del Golfo sono stati letti come egiziano o levantino in ogni esecuzione (sei errori in totale). Ed entrambi i modelli hanno classificato "Quanto costa? 😍" come lead qualificato, mentre la nostra regola richiedeva prezzo più tempistiche o dati di contatto. Lì il problema era la regola, non i modelli.
Ci si può fidare del punteggio di confidenza?
Su questo test, sì. È la cosa più utile che Jev offre.
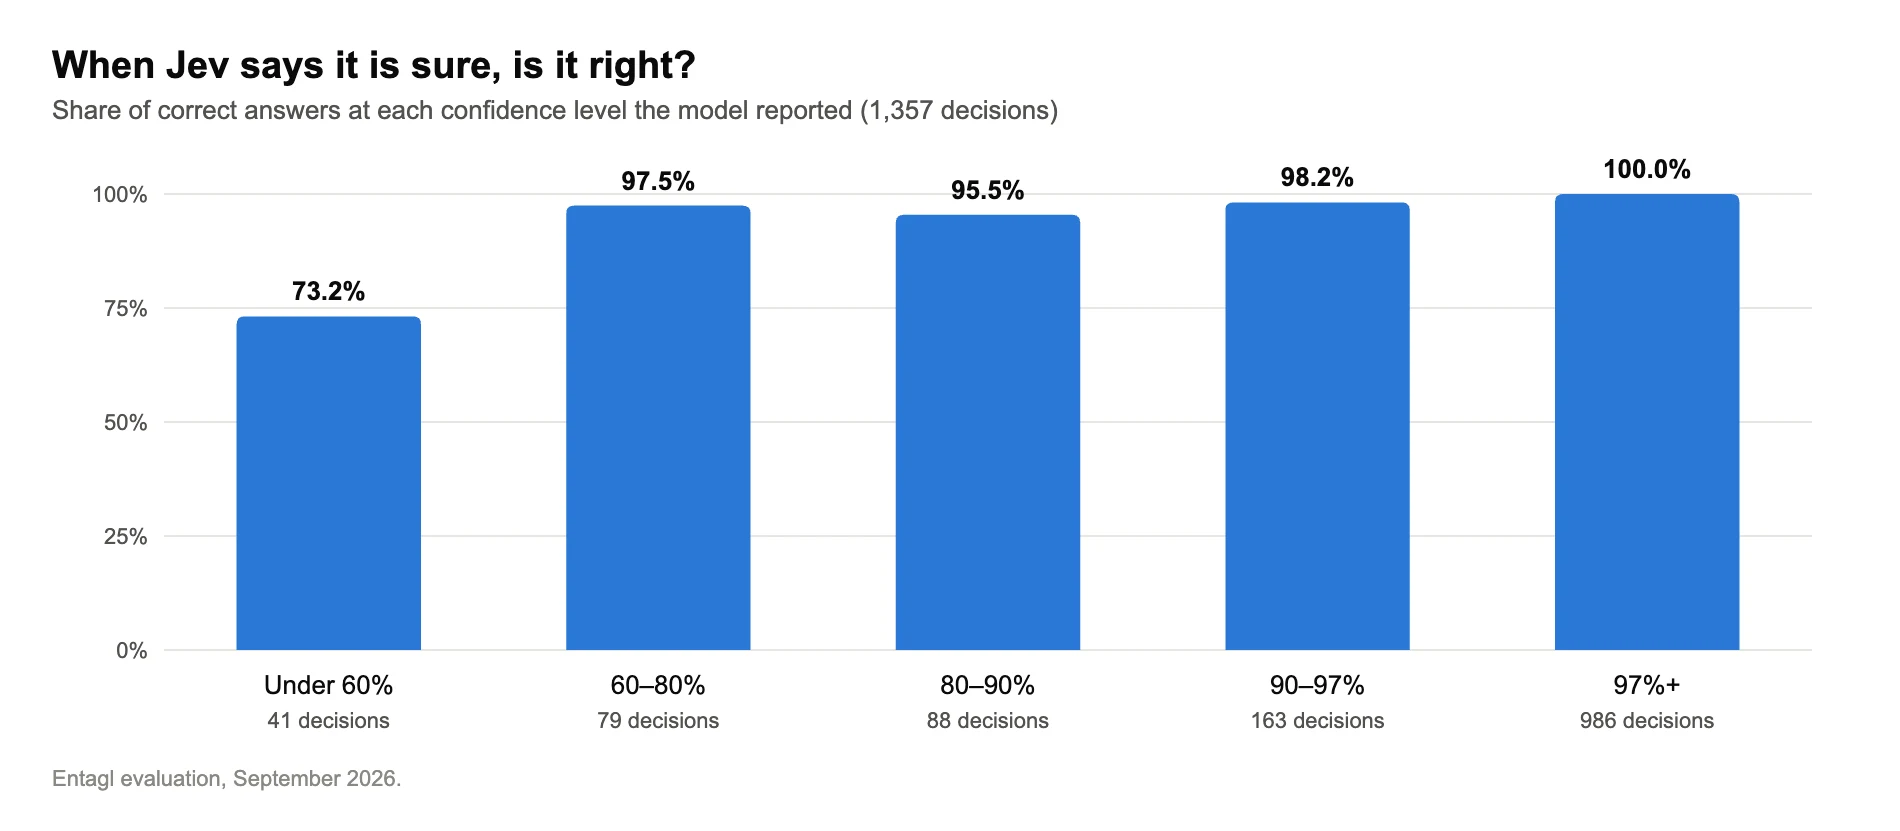
Basta una regola semplice, "usa la risposta di Jev solo quando è sicuro almeno all'85%, altrimenti chiedi al modello più grande", e Jev gestisce l'88% delle decisioni con un'accuratezza del 99,75%, mentre 17 dei suoi 20 errori finiscono al modello di riserva. Ogni errore sui dialetti arabi aveva una confidenza tra 0,36 e 0,40, quindi la regola li ha intercettati tutti.
Un errore è comunque passato con alta confidenza. Un'agenzia pubblicitaria turca ha scritto "vorremmo lavorare con voi". Jev l'ha letta come una candidatura di lavoro, a 0,95, in tutte e tre le esecuzioni. Nel contesto non ha fatto danni (Jev l'aveva anche segnalata come proposta commerciale, e quella decisione prevale), ma è un avvertimento giusto: un punteggio di confidenza è un indizio, non un via libera. Servono comunque verifiche etichettate e un monitoraggio dei risultati dopo aver attivato qualunque cosa.
Cosa è successo riproducendo conversazioni reali?
La concordanza grezza con le decisioni originali si è fermata al 74–84%, ma gran parte di quel divario non dipendeva da errori di Jev.
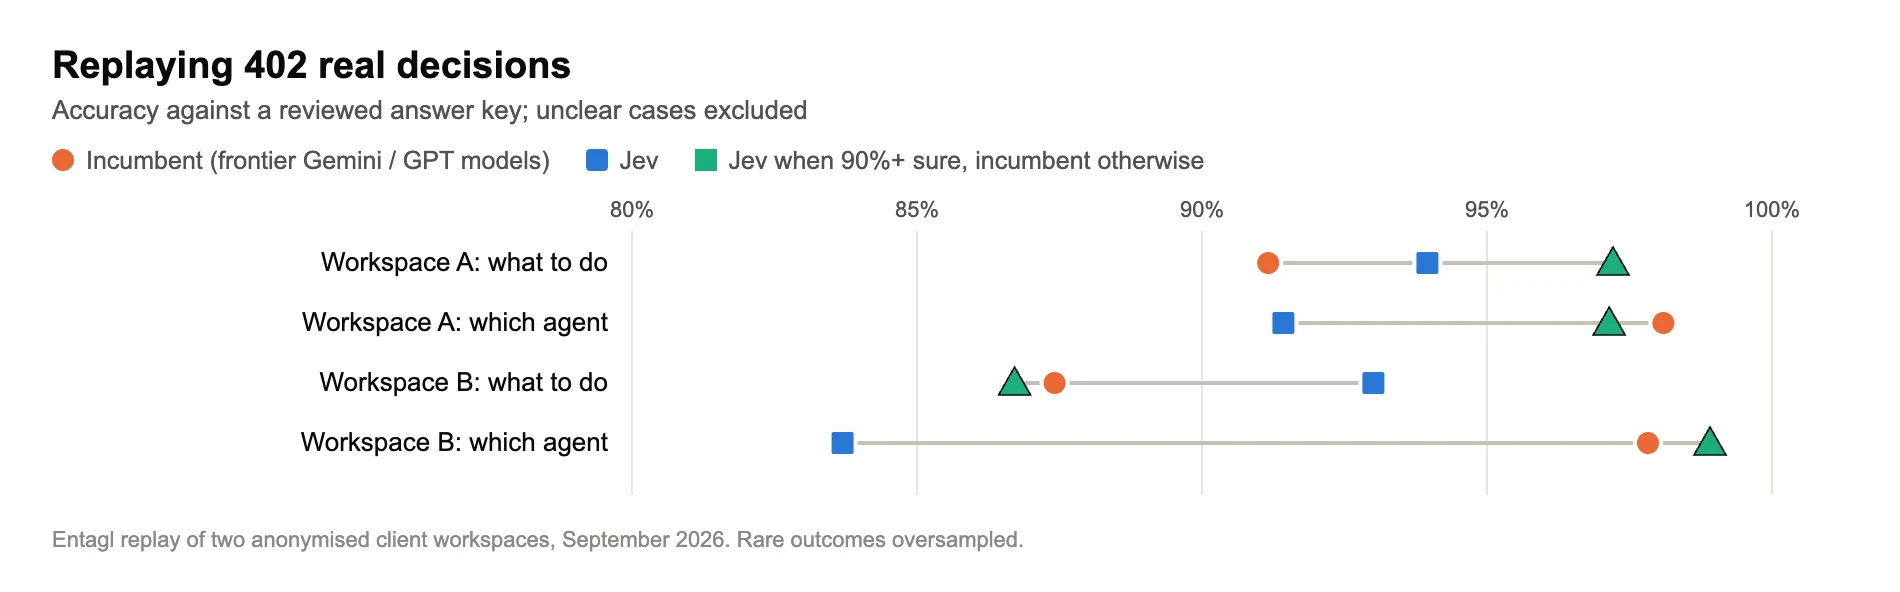
Valutati rispetto alla chiave di risposte rivista:
| Decisione | Originale (Gemini / GPT di frontiera) | Jev | Jev se sicuro al 90%+, altrimenti l'originale |
|---|---|---|---|
| Workspace A: cosa fare con il messaggio | 91,2% | 94,0% | 97,2% |
| Workspace A: quale specialista risponde | 98,1% | 91,4% | 97,1% |
| Workspace B: cosa fare con il messaggio | 87,4% | 93,0% | 86,7% |
| Workspace B: quale specialista risponde | 97,8% | 83,7% | 98,9% |
Una stranezza: nel Workspace B il filtro sulla confidenza ha peggiorato leggermente la decisione sul messaggio (86,7%), perché proprio sui messaggi in cui Jev era incerto ripiegare sull'originale significava usare le risposte più deboli dell'originale.
Decidere cosa fare con un messaggio (rispondere, ignorarlo, passarlo a una persona, inviare una risposta predefinita) ha premiato Jev in entrambi i workspace. La scelta dello specialista no, e il motivo è preciso. La maggior parte degli errori riguardava messaggi di seguito come "India" o "ne parlo domani" in una conversazione già in corso con uno specialista. Le regole del cliente dicono di restare con quello specialista. Jev vedeva gli ultimi otto messaggi ma nessuno gli diceva a chi appartenesse la chat, quindi ha tirato a indovinare in base alle parole. La configurazione originale aveva quel contesto e lo usava.
La riproduzione ha scovato anche errori nelle decisioni originali, di quelli che un controllo a campione non vede:
- Una regola a parole chiave che scattava sulle persone sbagliate. Una risposta predefinita di rinvio partiva ogni volta che qualcuno usava la parola "legale" o "avvocato". In un campione di 20, 15 erano normali domande di lavoro come "quali documenti legali mi servono per questo?". Jev le ha instradate verso una risposta vera.
- Passaggi a una persona ripetuti. Dopo che un cliente aveva già lasciato nome e numero, i messaggi successivi come "grazie" o "obrigada" facevano scattare ogni volta un nuovo passaggio allo staff. 17 dei 41 passaggi che abbiamo campionato erano ripetizioni di questo tipo.
- Due regole in contraddizione tra loro, per cui entrambi i modelli tiravano a indovinare sugli stessi messaggi.
Li abbiamo segnalati per correggerli alla fonte. Regole a parole chiave come la prima sono esattamente ciò da cui mette in guardia la nostra guida per fermare le allucinazioni degli agenti AI.
Dove Jev non è all'altezza?
Senza giri di parole:
- Le sfumature delle lingue diverse dall'inglese. La documentazione stessa di TypeSafe dice che l'inglese è la sua lingua di addestramento principale e che le altre lingue sono "gestite, ma non altrettanto bene". Lo abbiamo visto: 99,1% in inglese, 98,4% in turco, 96,5% in arabo. Sei dei nove errori in arabo erano confusioni tra dialetti; gli altri tre venivano da un messaggio borderline del tipo "è un reclamo?" e da un'etichetta su cui avremmo da discutere anche noi.
- Il contesto mancante che non può dedurre. Chi gestisce la conversazione, se i dati di contatto erano già stati raccolti: nella riproduzione reale Jev perdeva punti ogni volta che la risposta dipendeva da un fatto assente dal testo che gli inviavamo. La soluzione è calcolare quei fatti nel codice e passarglieli, non sperare che il modello indovini.
- Il testo precompilato degli annunci. Molte chat WhatsApp che nascono da annunci click-to-message si aprono con una frase modello come "Vorrei saperne di più sui vostri servizi". Jev si è appoggiato a quella frase e ha fatto passare come lead commerciali diverse persone in cerca di lavoro e richieste di beneficenza, una con confidenza 0,92. Eliminate prima la frase modello.
- Ciò per cui non è mai stato pensato. TypeSafe elenca i propri "jagged edges": aritmetica, conteggi, confronti tra date, input lunghi pieni di dettagli irrilevanti e testo scritto per manipolarlo. Tenete calcoli e date nel codice.
- È nuovissimo. Lanciato a settembre 2026, con limiti di utilizzo che secondo il fornitore potrebbero cambiare. Qualsiasi cosa costruita su di esso ha bisogno di un piano di riserva.
Dove useremmo un modello decisionale come Jev?
Ovunque si chieda a un LLM di scegliere da un elenco e nessuno legga l'output:
- Instradamento e screening di primo livello, con una soglia di confidenza e un modello più grande alle spalle.
- Analisi quotidiana delle conversazioni (categoria, sentiment, "ha chiesto il prezzo") su ogni conversazione, non su un campione.
- Controlli di sicurezza sempre attivi: richieste di interrompere i messaggi in qualsiasi lingua, o testo che cerca di dare istruzioni all'assistente (vedi la nostra guida alla prompt injection).
- Esiti delle chiamate come dati, letti dalla trascrizione.
Raggruppate anche le domande: il test di TypeSafe su un unico documento lungo ha rilevato che porre 13 domande in una sola chiamata invece che in 13 chiamate era 12,2 volte più economico e 10 volte più veloce, con le stesse risposte.
E dove non lo useremmo: per scrivere risposte, per qualunque cosa numerica, per qualunque caso in cui una risposta sbagliata ma sicura di sé zittisca un cliente vero. Bloccare del tutto un messaggio dovrebbe richiedere una confidenza molto alta o un secondo parere.
Come valutare da soli un modello decisionale?
Ecco cosa ha funzionato per noi:
- Etichettate prima di eseguire. "Concorda con il modello attuale" non equivale a "corretto". La nostra riproduzione ha mostrato che il modello in uso sbagliava abbastanza spesso da contare.
- Separate i risultati per lingua. Una media del 98% può nascondere un 96% proprio nella lingua che usano i vostri clienti.
- Tracciate l'accuratezza per livello di confidenza, poi riproducete lo storico reale. Un modello economico senza una soglia affidabile è un rischio, e i nostri casi scritti arrivavano vicino al 100% per entrambi i modelli; è nel traffico reale che sono emerse le differenze, e anche i bug del modello in uso.
- Fatelo girare in ombra prima di passare. Eseguite il nuovo modello in silenzio accanto al vecchio e cambiate compito per compito, mai tutto insieme.
Tutto questo si lega a un punto più ampio che abbiamo già sostenuto: non scommettere il proprio prodotto su un solo modello AI. Il modello giusto per "decidere" spesso non è quello giusto per "scrivere", e oggi modelli più piccoli ed economici coprono una parte del primo lavoro più ampia di quanto molti team immaginino.
Domande frequenti
TypeSafe Jev sostituisce GPT o Gemini?
No. Sostituisce un solo tipo di chiamata: scegliere tra opzioni che definite voi, assegnare un punteggio su una scala o rispondere sì/no. Non sa scrivere testo, usare strumenti o leggere immagini, quindi un agente che parla con i clienti ha ancora bisogno di un modello linguistico per la risposta.
Quanto è accurato TypeSafe Jev rispetto agli LLM di frontiera?
Nel nostro test di settembre 2026 su 1.357 decisioni etichettate ha ottenuto il 98,5%, contro il 99,0% di un modello Google Gemini di frontiera. Sullo storico reale delle conversazioni è andato meglio nel decidere cosa fare con un messaggio e peggio nello scegliere lo specialista giusto a conversazione in corso.
TypeSafe Jev funziona in arabo e in turco?
Sì, con una riserva. Nel nostro test il turco si è avvicinato all'inglese (98,4% contro 99,1%). L'arabo si è fermato al 96,5%. La maggior parte degli errori erano confusioni tra dialetti (arabo del Golfo letto come egiziano o levantino), mai la lingua sbagliata, e sono arrivati con punteggi di confidenza bassi.
Ci si può affidare al punteggio di confidenza di Jev?
Nei nostri dati ha seguito bene l'accuratezza: 100% di risposte corrette con confidenza del 97% o superiore, 73% sotto il 60%. Un errore sicuro di sé (0,95) c'è stato comunque, quindi usate il punteggio per decidere quando ripiegare su un altro modello e continuate a verificare i risultati reali.
Costa meno ed è più veloce di un LLM?
Sulle nostre chiamate di test è costato circa 25 volte meno e ha risposto in una mediana di 329 ms contro 1.598 ms, soprattutto perché Jev fattura solo i token in input e restituisce una breve risposta tipizzata invece di testo generato.
Volete un'AI che sa quando non è sicura?
Testiamo modelli come questo perché gli agenti che rispondono ai vostri clienti prendano bene le decisioni rapide ed economiche e passino quelle difficili a qualcosa di più grande. Per vedere come funziona sui vostri DM, prenotate una demo di 30 minuti, oppure scoprite come se la cavano già oggi i nostri agenti AI per i DM di Instagram e WhatsApp.
Fonti e metodo: valutazione Entagl, settembre 2026. Round 1: 283 casi di test etichettati a mano (189 standard, più 94 casi difficili eseguiti tre volte: 471 esecuzioni), 1.357 decisioni valutate, TypeSafe Jev (jev-1.13.0) contro un modello Google Gemini di frontiera con input identici; il costo confronta i token fatturati per chiamate identiche al prezzo di listino di ciascun fornitore a settembre 2026 (Jev fattura solo i token in input). Round 2: 402 decisioni di instradamento reali da due workspace di clienti anonimizzati nell'arco di 21 giorni, con i dati personali mascherati prima dell'elaborazione; le divergenze sono state riviste rispetto alle regole scritte di ciascun cliente, i casi poco chiari esclusi e gli esiti rari sovracampionati, quindi le percentuali non sono una media di produzione. Un solo revisore. Fatti sul fornitore: post di lancio di TypeSafe, documentazione dei modelli TypeSafe, limiti noti di Jev 1.13, cookbook TypeSafe sulle domande in parallelo. Contesto sulla calibrazione: Guo et al., ICML 2017.