AI News · industry
TypeSafe Jev face à Gemini sur 1 759 décisions : 5x plus rapide, 25x moins cher, 98,5 % de précision
Nous avons testé le nouveau modèle de décision de TypeSafe sur 1 357 décisions annotées dans 13 langues et 402 vraies conversations clients. Il a presque égalé un LLM de pointe pour une fraction du temps et du coût, puis nous a montré précisément où il cède.
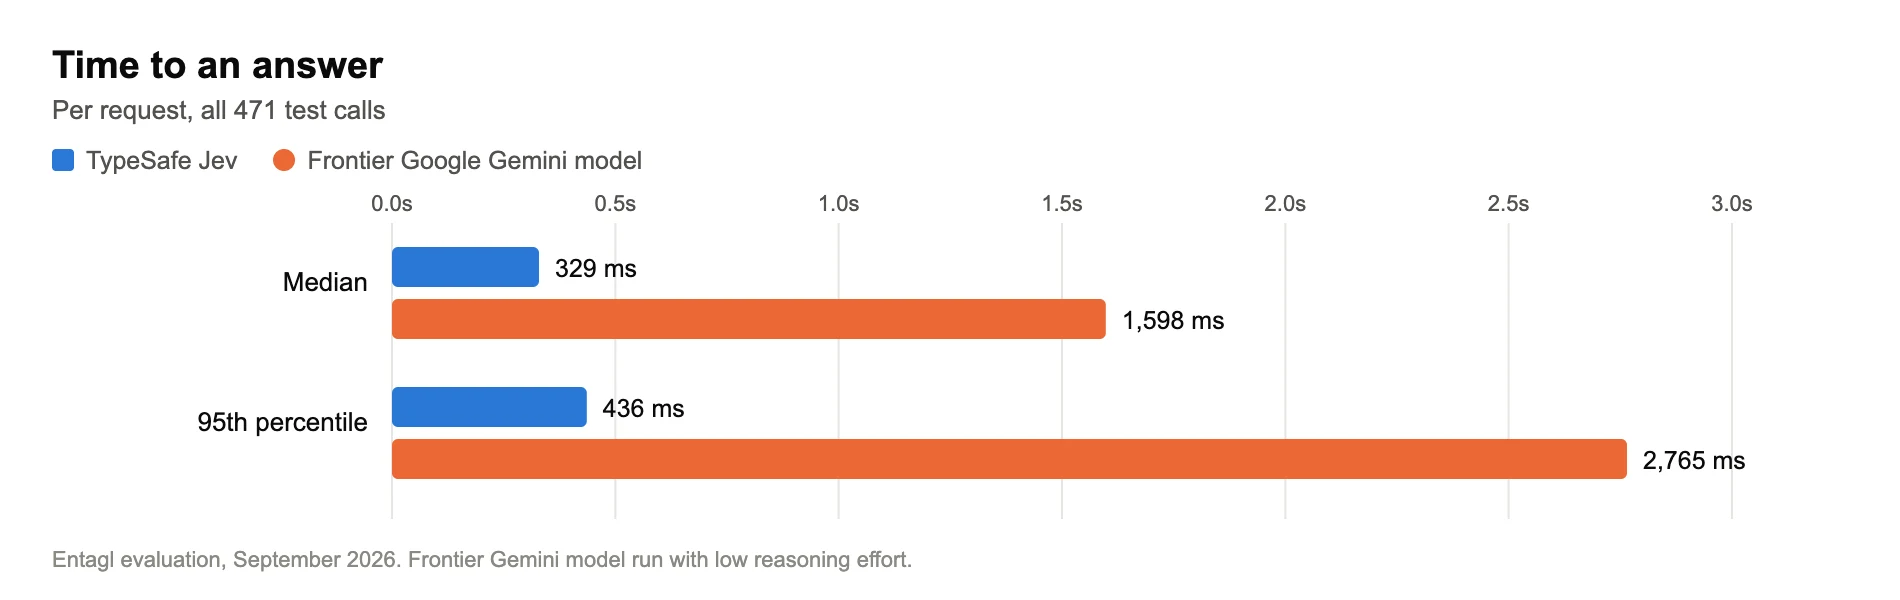
Nous avons confié 1 759 décisions à TypeSafe Jev, le modèle dédié à la décision lancé par TypeSafe le 15 septembre : 1 357 décisions de test annotées à la main dans 13 langues, et 402 décisions d'aiguillage réelles tirées de conversations clients en production. Face à un modèle Google Gemini de pointe, il s'est montré 5x plus rapide (329 ms en médiane contre 1 598 ms), 25x moins cher, et presque aussi précis (98,5 % contre 99,0 %). Lorsqu'il se disait sûr à 97 % ou plus, il avait raison 986 fois sur 986.
Puis nous avons rejoué du vrai trafic client, et il a cédé là où aucun jeu de test ne l'avait laissé prévoir. Voici tout : les chiffres, les graphiques, les angles morts, et les cas où nous l'utiliserions ou non.
Qu'est-ce que TypeSafe Jev, et en quoi diffère-t-il d'un LLM ?
TypeSafe a présenté Jev le 15 septembre 2026 comme son premier modèle « System One », un nom emprunté au Système 1 de Daniel Kahneman, cette pensée rapide et intuitive. Vous ne lui demandez pas de rédiger. Vous lui transmettez les faits (un message, un court historique, une liste d'options) et des questions typées, et il renvoie l'un de trois types de réponse :
| Type de question | Ce que vous demandez | Ce que vous obtenez |
|---|---|---|
| Oui/non | « Ce message nous demande-t-il de ne plus le contacter ? » | Une probabilité, par exemple 0,97 |
| Choix unique | « Laquelle de ces quatre équipes doit répondre ? » | Le choix retenu, une probabilité pour chaque option et un score de confiance |
| Score | « Sur une échelle de 5 niveaux, à quel point ce client est-il agacé ? » | Une position sur l'échelle et la dispersion |
Il ne sait ni rédiger de réponses, ni appeler d'outils, ni lire d'images. TypeSafe l'entraîne avec ce qu'il appelle un apprentissage par renforcement pour des décisions calibrées. L'objectif : que « sûr à 90 % » signifie vraiment juste environ 9 fois sur 10, ce que les modèles de langage classiques font mal. Une étude de référence de 2017 a montré que les réseaux de neurones modernes ont tendance à être trop sûrs d'eux (Guo et al., « On Calibration of Modern Neural Networks », ICML 2017). La tarification sort aussi de l'ordinaire : TypeSafe ne facture que les tokens en entrée ; la sortie est gratuite.
Un modèle de décision étroit et bon marché peut-il reprendre les étapes « décider » d'un LLM de pointe sans commettre plus d'erreurs ? Voici nos données.
Comment l'avons-nous testé ?
Deux phases, avec les mêmes questions pour chaque modèle.
Phase 1 : un jeu de test annoté. Nous avons rédigé 283 cas réalistes couvrant 13 tâches de décision, et fixé la bonne réponse de chacun avant toute exécution : 189 cas standard et 94 plus difficiles. Les cas difficiles ont tourné trois fois pour vérifier que les réponses se répètent, soit 471 exécutions et 1 357 décisions notées. Côté langues : anglais, turc, quatre variétés d'arabe, arabe en caractères latins, et 10 autres. Parmi les tâches : aiguiller un message vers le bon spécialiste, repérer un texte d'injection de prompt, lire la transcription d'un appel téléphonique pour en déduire l'issue, et signaler une réponse qui cite un prix jamais fixé par l'entreprise. Jev et un modèle Google Gemini de pointe (avec un effort de raisonnement faible) ont reçu exactement les mêmes faits, questions et options.
Phase 2 : rejouer l'historique réel. Nous avons repris 402 décisions d'aiguillage réelles déjà prises par notre produit pour deux espaces de travail clients sur 21 jours, repassé les mêmes conversations dans Jev, puis comparé. L'espace A est un cabinet de services professionnels au Moyen-Orient, surtout en arabe sur WhatsApp. L'espace B est un service d'assistance dans la santé, surtout en anglais et en portugais sur chat web. Leurs décisions d'origine provenaient de modèles de pointe Google Gemini et OpenAI GPT. Noms, numéros de téléphone, e-mails et liens ont été masqués avant que le moindre texte ne quitte nos systèmes. Lorsque Jev et la décision d'origine divergeaient, nous avons lu la conversation et jugé quelle réponse respectait les règles écrites du client. Les cas que ces règles ne tranchaient pas ont été écartés.
Quelle précision pour Jev sur le jeu annoté ?
À peu près celle du modèle de pointe : 98,5 % contre 99,0 % sur 1 357 décisions notées, pour une vitesse environ cinq fois supérieure.
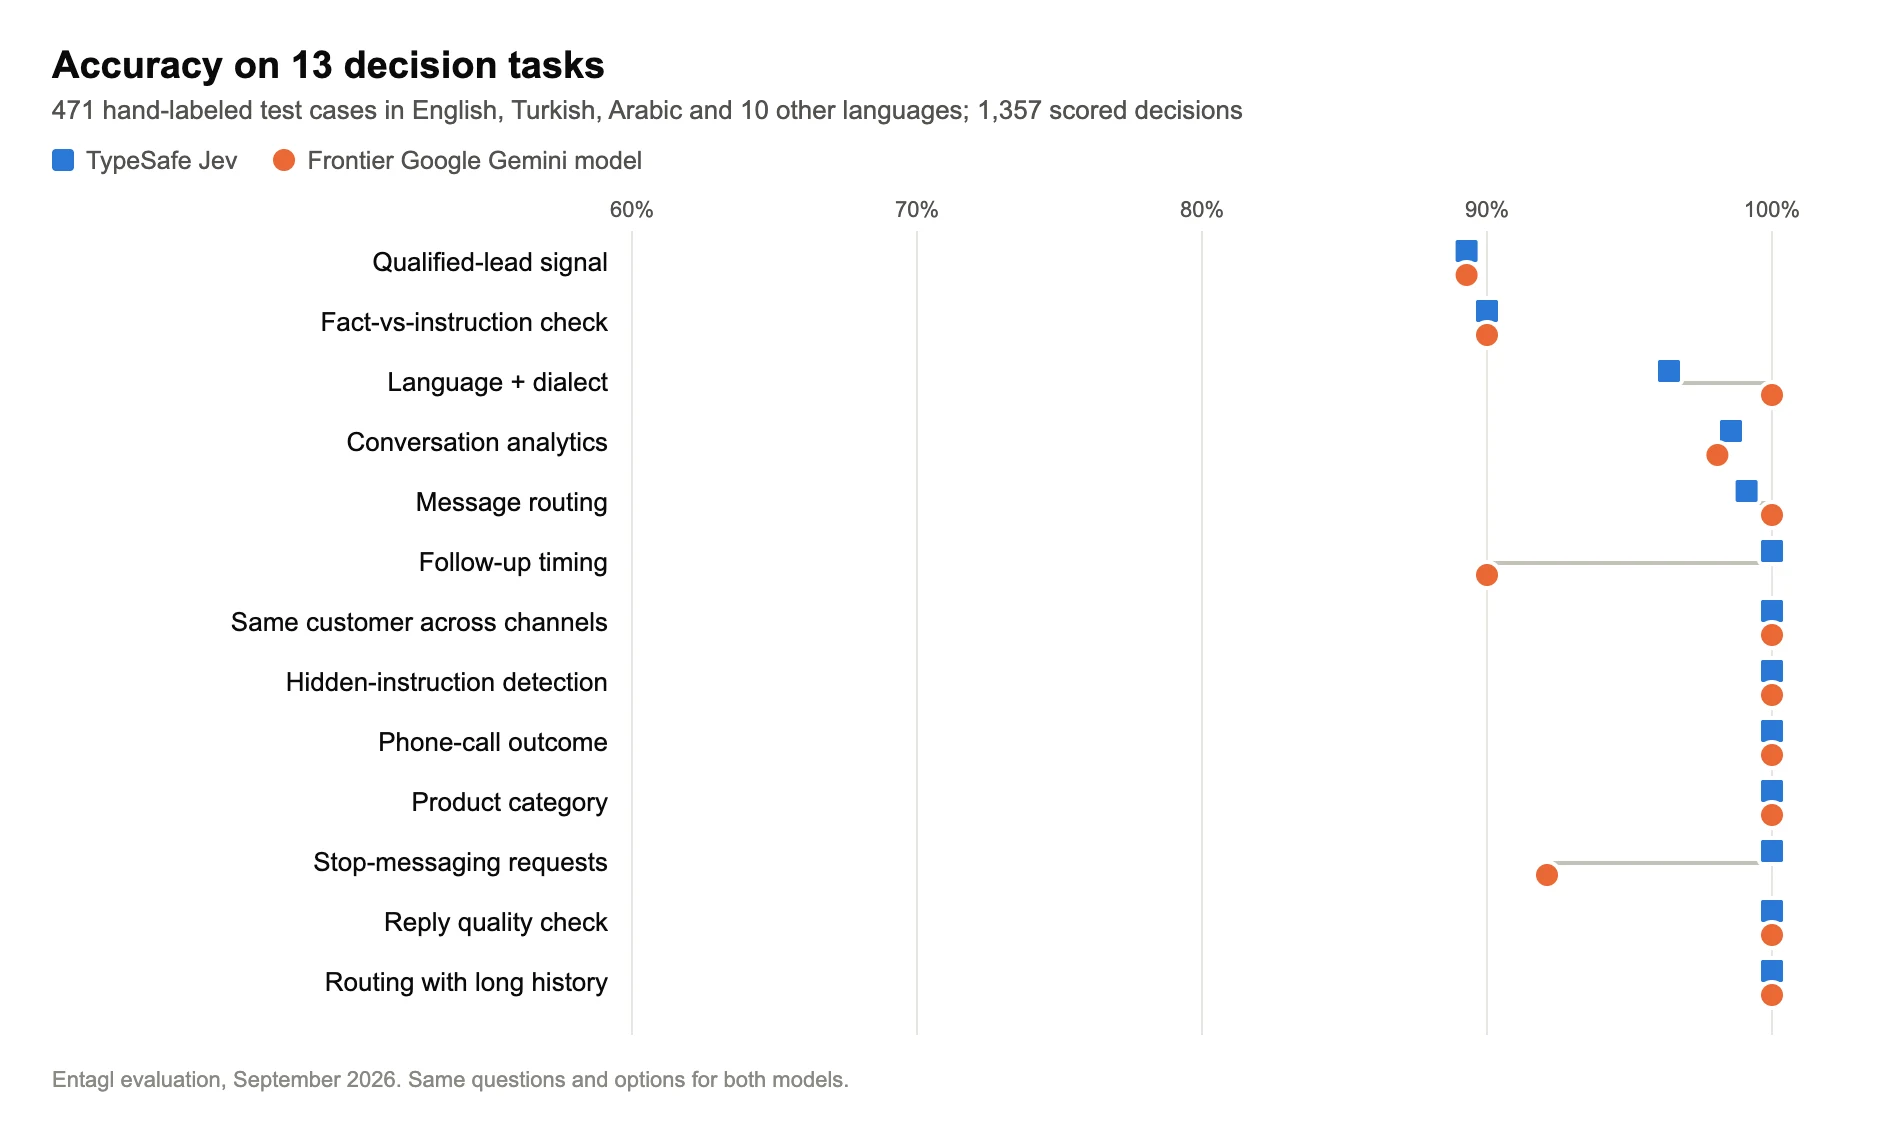
Les écarts sont faibles et vont dans les deux sens. Jev a compris que « ça ne m'intéresse plus » n'est pas une demande de désabonnement ; Gemini l'a signalé comme tel. Gemini a aussi considéré « notre équipe va vous appeler » comme un renvoi du client vers le téléphone, et jugé que « un peu cher, peut-être plus tard » ne méritait pas de relance, alors que c'est précisément le prospect qu'il faut relancer.
Le point faible de Jev, ce sont les dialectes arabes. Il a toujours reconnu que le texte était en arabe, mais deux messages en arabe du Golfe ont été lus comme égyptiens ou levantins à chaque exécution (six erreurs au total). Et les deux modèles ont qualifié « How much? 😍 » de prospect qualifié, alors que notre règle exigeait un prix plus un délai ou des coordonnées. Là, c'était la règle qui posait problème, pas les modèles.
Peut-on se fier au score de confiance ?
Sur ce test, oui. C'est même l'atout le plus utile de Jev.
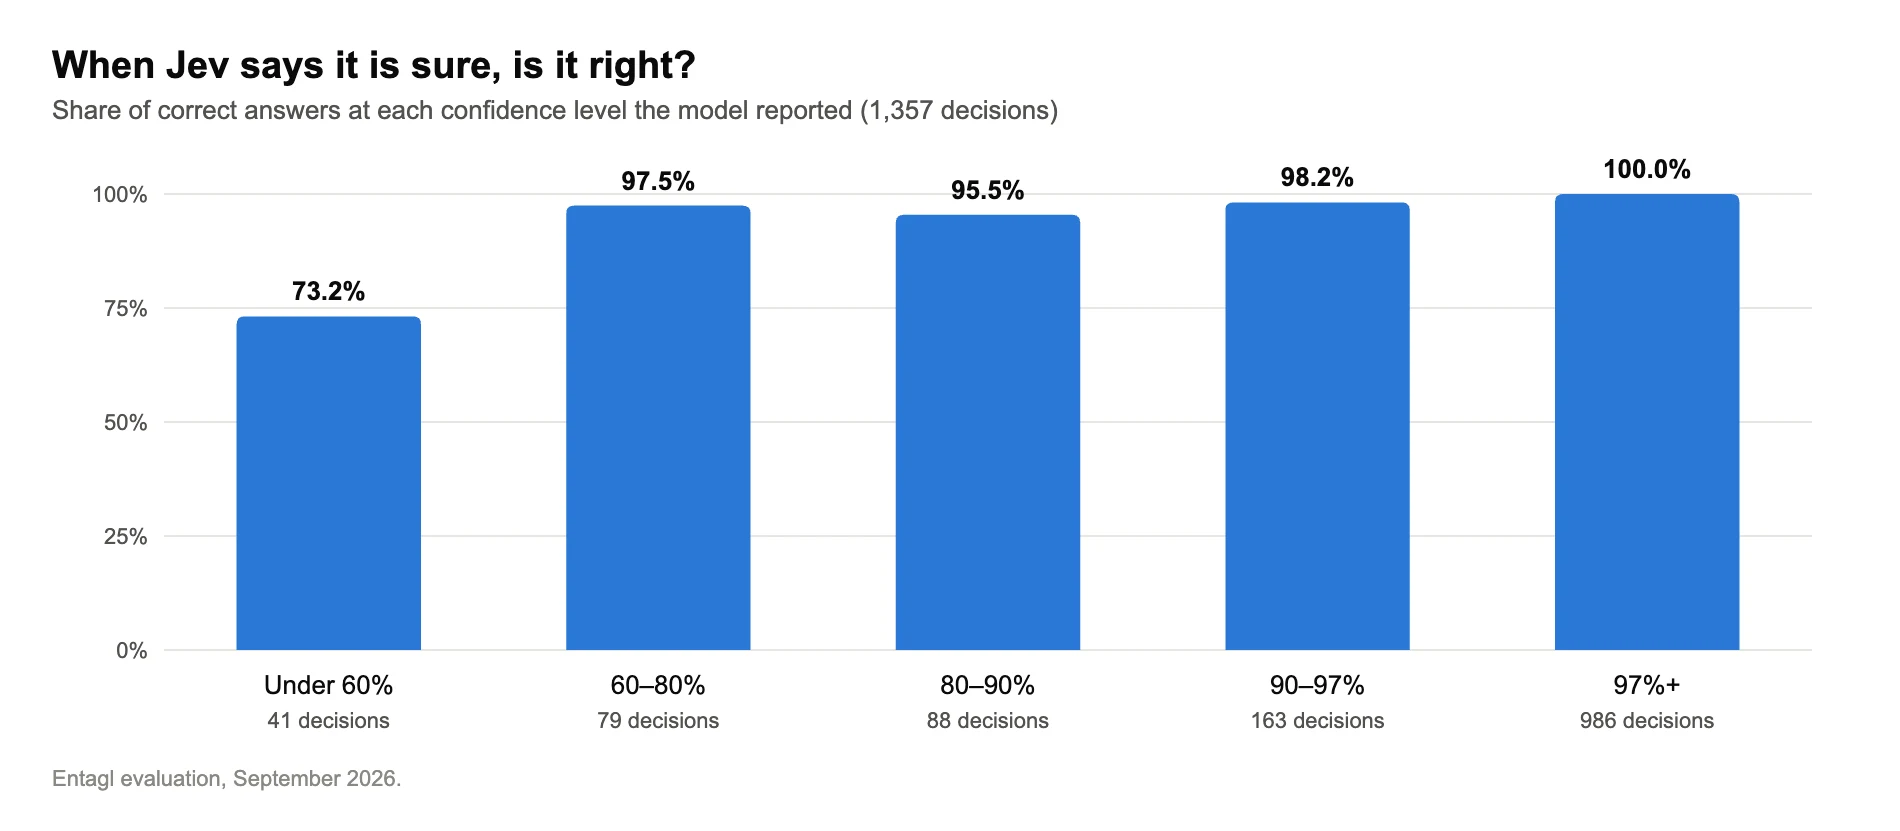
Posez une règle simple, « n'utiliser la réponse de Jev que s'il est sûr à au moins 85 %, sinon interroger le modèle plus puissant », et Jev traite 88 % des décisions avec 99,75 % de précision, tandis que 17 de ses 20 erreurs sont renvoyées au modèle de secours. Chaque erreur de dialecte arabe s'accompagnait d'une confiance de 0,36 à 0,40 : la règle les a toutes interceptées.
Une erreur est tout de même passée avec une confiance élevée. Une agence publicitaire turque a écrit « nous aimerions travailler avec vous ». Jev y a vu une candidature spontanée, à 0,95, lors des trois exécutions. Sans conséquence dans ce contexte (Jev l'a aussi repéré comme une prospection commerciale, et c'est cette décision qui l'emporte), mais l'avertissement est légitime : un score de confiance est un indice, pas une autorisation. Il vous faut toujours des contrôles annotés et un suivi des résultats après toute mise en service.
Que s'est-il passé en rejouant de vraies conversations ?
L'accord brut avec les décisions d'origine n'atteignait que 74–84 %, mais l'essentiel de cet écart ne venait pas d'erreurs de Jev.
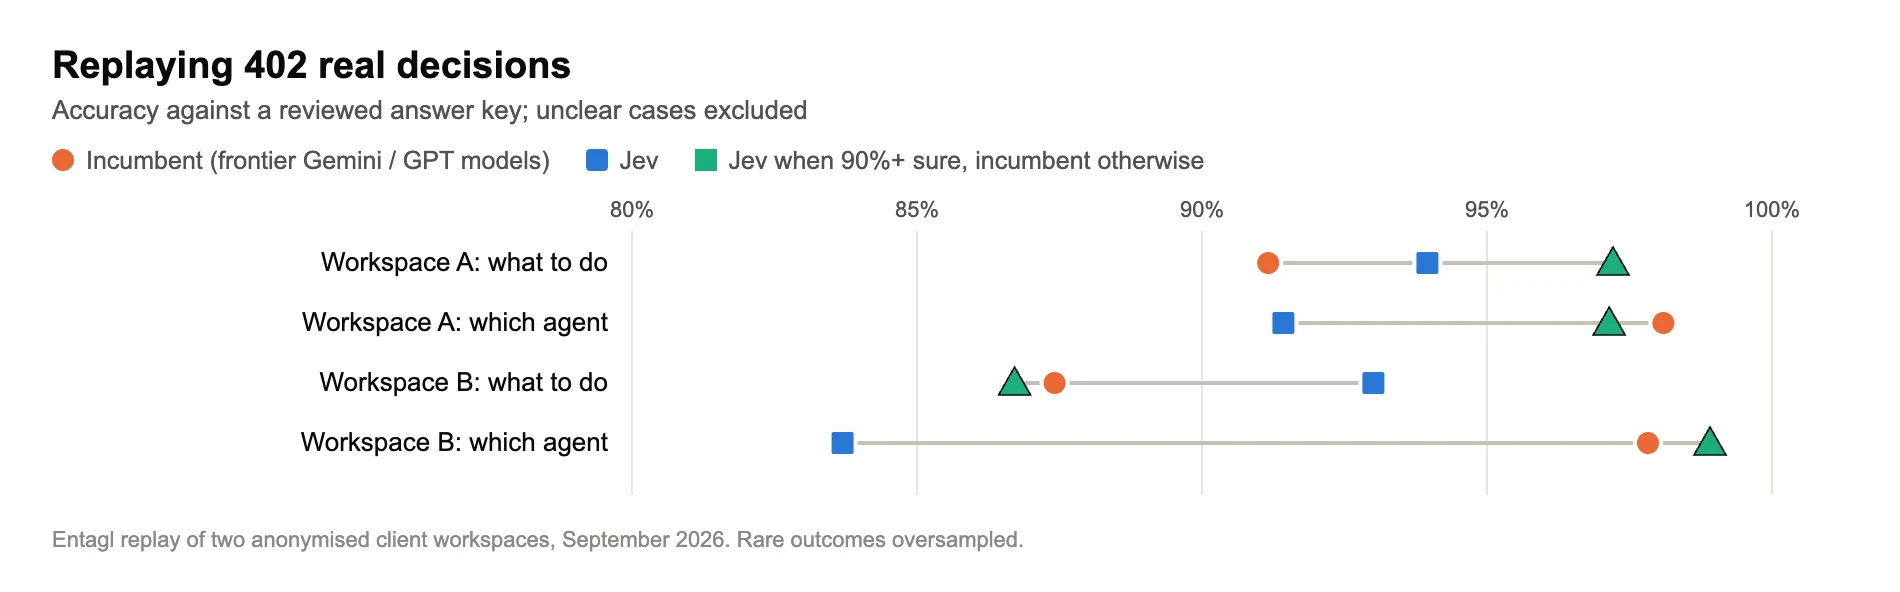
Résultats face à la grille de réponses vérifiée :
| Décision | Origine (Gemini / GPT de pointe) | Jev | Jev si sûr à 90 % et plus, origine sinon |
|---|---|---|---|
| Espace A : que faire du message | 91,2 % | 94,0 % | 97,2 % |
| Espace A : quel spécialiste répond | 98,1 % | 91,4 % | 97,1 % |
| Espace B : que faire du message | 87,4 % | 93,0 % | 86,7 % |
| Espace B : quel spécialiste répond | 97,8 % | 83,7 % | 98,9 % |
Une bizarrerie : dans l'espace B, ce filtrage a légèrement dégradé la décision sur le message (86,7 %). Sur les messages où Jev hésitait, revenir à l'origine revenait à reprendre ses réponses les plus faibles.
Décider quoi faire d'un message (répondre, ignorer, transférer à un humain, envoyer une réponse préenregistrée) a tourné à l'avantage de Jev dans les deux espaces. Choisir le spécialiste, non, et la raison est précise. La plupart des erreurs portaient sur des relances comme « India » ou « I will discuss tomorrow », au sein d'une conversation déjà suivie par un spécialiste. Les règles du client imposent de rester avec ce spécialiste. Jev voyait les huit derniers messages, mais personne ne lui avait dit à qui appartenait la conversation : il a donc deviné à partir des mots. La configuration d'origine disposait de ce contexte et s'en servait.
Le rejeu a aussi mis au jour des erreurs dans les décisions d'origine, du genre qu'un contrôle ponctuel laisse passer :
- Une règle par mot-clé qui se déclenchait sur les mauvaises personnes. Une réponse préenregistrée de réorientation partait dès qu'un client employait le mot « legal » ou « lawyer ». Sur un échantillon de 20, 15 étaient de simples questions d'affaires, comme « de quels documents juridiques ai-je besoin pour ça ? ». Jev les a orientées vers une vraie réponse.
- Des transferts en double. Une fois que le client avait donné son nom et son numéro, les messages suivants comme « thanks » ou « obrigada » déclenchaient chacun un nouveau transfert vers l'équipe. Sur les 41 transferts échantillonnés, 17 étaient des doublons de ce type.
- Deux règles qui se contredisaient, si bien que les deux modèles devinaient sur les mêmes messages.
Nous les avons signalées pour correction à la source. Les règles par mot-clé comme la première sont exactement ce contre quoi met en garde notre guide pour empêcher les agents IA d'halluciner.
Où Jev montre-t-il ses limites ?
Sans détour :
- Les nuances hors anglais. La documentation de TypeSafe elle-même indique que l'anglais est sa langue d'entraînement principale et que les autres langues sont « prises en charge, mais pas aussi bien ». Nous l'avons constaté : 99,1 % en anglais, 98,4 % en turc, 96,5 % en arabe. Six des neuf erreurs en arabe étaient des confusions de dialecte ; les trois autres venaient d'un message limite (« est-ce une réclamation ? ») et d'une étiquette que nous-mêmes pourrions discuter.
- Le contexte manquant qu'il ne peut pas deviner. Qui gère la conversation, si les coordonnées ont déjà été recueillies : lors du rejeu réel, Jev a perdu des points chaque fois que la réponse dépendait d'un fait absent du texte transmis. La solution consiste à calculer ces faits dans le code et à les lui fournir, pas à espérer qu'il les devine.
- Le texte publicitaire prérempli. Beaucoup de conversations WhatsApp issues de publicités « click-to-message » commencent par une phrase type comme « J'aimerais en savoir plus sur vos services ». Jev s'est appuyé sur cette phrase et a laissé passer comme prospects commerciaux plusieurs vrais demandeurs d'emploi et demandes caritatives, dont une à 0,92 de confiance. Retirez d'abord ce modèle de texte.
- Ce pour quoi il n'a jamais été conçu. TypeSafe liste ses propres « jagged edges » : l'arithmétique, le comptage, la comparaison de dates, les longues entrées remplies de détails hors sujet, et les textes rédigés pour le manipuler. Gardez les calculs et les dates dans le code.
- Il est tout récent. Lancé en septembre 2026, avec des limites de débit que l'éditeur dit susceptibles d'évoluer. Tout ce qui repose dessus doit prévoir une solution de repli.
Où utiliserions-nous un modèle de décision comme Jev ?
Partout où l'on demande à un LLM de choisir dans une liste et où personne ne relit le résultat :
- Le premier aiguillage et le tri initial, avec un seuil de confiance et un modèle plus puissant en renfort.
- L'analyse quotidienne des conversations (catégorie, sentiment, « a demandé le prix ») sur chaque conversation, pas sur un échantillon.
- Des contrôles de sécurité permanents : demandes d'arrêt des messages dans toutes les langues, ou texte qui tente de donner des instructions à l'assistant (voir notre guide sur l'injection de prompt).
- L'issue des appels sous forme de données, extraite de la transcription.
Regroupez aussi vos questions : le propre test de TypeSafe sur un long document a montré que poser 13 questions en un seul appel plutôt qu'en 13 appels était 12,2 fois moins cher et 10 fois plus rapide, avec les mêmes réponses.
Et là où nous ne l'utiliserions pas : rédiger des réponses, tout ce qui touche aux chiffres, tout cas où une réponse fausse mais assurée réduirait au silence un vrai client. Bloquer purement et simplement un message devrait exiger une confiance très élevée ou un second avis.
Comment évaluer vous-même un modèle de décision ?
Ce qui a fonctionné pour nous :
- Annotez avant d'exécuter. « D'accord avec le modèle actuel » ne veut pas dire « correct ». Notre rejeu a montré que le modèle en place se trompait assez souvent pour que cela compte.
- Ventilez par langue. Une moyenne de 98 % peut masquer 96 % dans une langue que vos clients utilisent réellement.
- Tracez la précision selon la confiance, puis rejouez l'historique réel. Un modèle bon marché sans seuil fiable est un risque, et nos cas rédigés plafonnaient près de 100 % pour les deux modèles ; c'est sur le trafic réel que les différences sont apparues, avec les propres bugs du modèle en place.
- Testez en parallèle avant de basculer. Faites tourner le nouveau modèle en silence à côté de l'ancien, et basculez tâche par tâche, jamais tout d'un coup.
Cela rejoint un point plus large que nous avons déjà défendu : ne pas miser votre produit sur un seul modèle d'IA. Le bon modèle pour « décider » n'est souvent pas le bon pour « rédiger », et des modèles plus petits et moins chers assurent désormais une plus grande part du premier travail que la plupart des équipes ne l'imaginent.
FAQ
TypeSafe Jev remplace-t-il GPT ou Gemini ?
Non. Il remplace un seul type d'appel : choisir parmi des options que vous définissez, noter sur une échelle ou répondre par oui ou non. Il ne sait ni rédiger de texte, ni utiliser d'outils, ni lire d'images : un agent en contact avec les clients a donc toujours besoin d'un modèle de langage pour la réponse.
Quelle est la précision de TypeSafe Jev par rapport aux LLM de pointe ?
Lors de notre test de septembre 2026 sur 1 357 décisions annotées, il a obtenu 98,5 %, contre 99,0 % pour un modèle Google Gemini de pointe. Sur l'historique réel des conversations, il s'est montré meilleur pour décider quoi faire d'un message, et moins bon pour choisir le bon spécialiste en cours de conversation.
TypeSafe Jev fonctionne-t-il en arabe et en turc ?
Oui, avec une réserve. Le turc était proche de l'anglais dans notre test (98,4 % contre 99,1 %). L'arabe atteignait 96,5 %. La plupart des erreurs étaient des confusions de dialecte (arabe du Golfe lu comme égyptien ou levantin), jamais une erreur de langue, et elles s'accompagnaient de scores de confiance bas.
Peut-on se fier au score de confiance de Jev ?
Dans nos données, il suivait bien la précision : 100 % de réponses justes à 97 % de confiance ou plus, 73 % sous 60 %. Une erreur assurée (0,95) s'est tout de même produite : servez-vous du score pour décider quand basculer vers le modèle de secours, et continuez à vérifier les résultats réels.
Est-il moins cher et plus rapide qu'un LLM ?
Sur nos appels de test, il coûtait environ 25 fois moins et répondait en 329 ms en médiane contre 1 598 ms, surtout parce que Jev ne facture que les tokens en entrée et renvoie une réponse typée courte plutôt que du texte généré.
Vous voulez une IA qui sait quand elle n'est pas sûre ?
Nous testons ce type de modèle pour que les agents qui répondent à vos clients prennent correctement les décisions simples et rapides, et confient les cas difficiles à un modèle plus puissant. Pour voir ce que cela donne sur vos propres DM, réservez une démo de 30 minutes, ou découvrez comment nos agents IA pour les DM Instagram et WhatsApp s'en chargent déjà aujourd'hui.
Sources et méthode : évaluation Entagl, septembre 2026. Phase 1 : 283 cas de test annotés à la main (189 standard, plus 94 cas difficiles exécutés trois fois, soit 471 exécutions), 1 357 décisions notées, TypeSafe Jev (jev-1.13.0) face à un modèle Google Gemini de pointe avec des entrées identiques ; le coût compare les tokens facturés pour des appels identiques au tarif public de chaque fournisseur en septembre 2026 (Jev ne facture que les tokens en entrée). Phase 2 : 402 décisions d'aiguillage réelles issues de deux espaces de travail clients anonymisés sur 21 jours, données personnelles masquées avant traitement ; désaccords examinés au regard des règles écrites de chaque client, cas ambigus exclus, issues rares surreprésentées : les pourcentages ne reflètent donc pas une moyenne de production. Un seul évaluateur. Données fournisseur : article de lancement de TypeSafe, documentation des modèles TypeSafe, limites connues de Jev 1.13, cookbook TypeSafe sur les questions parallèles. Contexte sur la calibration : Guo et al., ICML 2017.