AI News · industry
TypeSafe Jev frente a Gemini en 1,759 decisiones: 5x más rápido, 25x más barato y 98.5% de acierto
Pusimos a prueba el nuevo modelo de solo decisiones de TypeSafe con 1,357 decisiones etiquetadas en 13 idiomas y 402 chats reales de clientes. Casi igualó a un LLM de frontera con una fracción del tiempo y del coste, y después nos enseñó exactamente dónde se rompe.
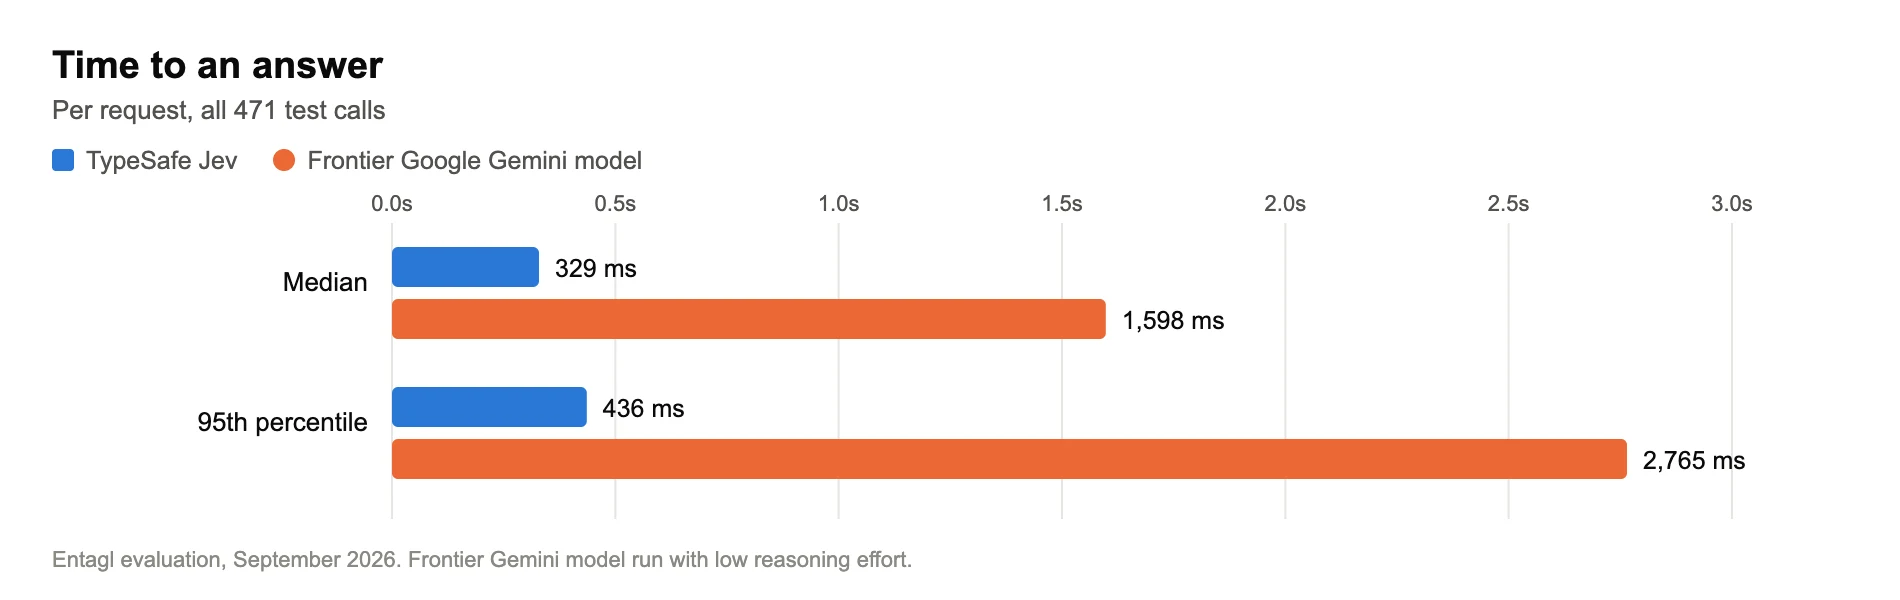
Le dimos a TypeSafe Jev, el modelo de solo decisiones que TypeSafe lanzó el 15 de septiembre, 1,759 decisiones que tomar: 1,357 decisiones de prueba etiquetadas a mano en 13 idiomas y 402 decisiones reales de enrutamiento sacadas de chats en vivo con clientes. Frente a un modelo Google Gemini de frontera fue 5x más rápido (una mediana de 329 ms contra 1,598 ms), 25x más barato y prácticamente igual de preciso (98.5% frente a 99.0%). Cuando decía estar seguro al 97% o más, acertó 986 veces de 986.
Luego reprodujimos tráfico real de clientes, y falló de maneras que ningún conjunto de prueba había anticipado. Aquí lo tienes todo: las cifras, los gráficos, los puntos ciegos y dónde lo usaríamos y dónde no.
Qué es TypeSafe Jev y en qué se diferencia de un LLM
TypeSafe anunció Jev el 15 de septiembre de 2026 como su primer modelo "System One", un nombre tomado del pensamiento rápido e intuitivo del Sistema 1 de Daniel Kahneman. No le pides texto redactado. Le envías los hechos (un mensaje, un historial breve, una lista de opciones) y preguntas tipadas, y te devuelve uno de tres tipos de respuesta:
| Tipo de pregunta | Qué preguntas | Qué recibes |
|---|---|---|
| Sí/no | "¿Este mensaje nos pide que dejemos de contactarle?" | Una probabilidad, p. ej. 0.97 |
| Elegir una opción | "¿Cuál de estos cuatro equipos debe responder?" | La opción elegida, una probabilidad para cada alternativa y una puntuación de confianza |
| Puntuación | "¿Qué tan frustrado está este cliente, en una escala de 5 niveles?" | Una posición en la escala más la dispersión |
No puede redactar respuestas, llamar a herramientas ni leer imágenes. TypeSafe lo entrena con lo que llama aprendizaje por refuerzo para decisiones calibradas. La idea es que "seguro al 90%" signifique de verdad acertar unas 9 de cada 10 veces, algo que a los modelos de lenguaje habituales se les da mal. Un estudio muy citado de 2017 concluyó que las redes neuronales modernas tienden a pecar de exceso de confianza (Guo et al., "On Calibration of Modern Neural Networks," ICML 2017). El precio también es poco habitual: TypeSafe cobra solo los tokens de entrada; la salida es gratis.
¿Puede un modelo de decisión estrecho y barato asumir los pasos de "decidir" que hoy hace un LLM de frontera sin cometer más errores? Estos son nuestros datos.
Cómo lo probamos
Dos rondas, con las mismas preguntas para cada modelo.
Ronda 1: un conjunto de prueba etiquetado. Redactamos 283 casos realistas repartidos en 13 tareas de decisión y etiquetamos la respuesta correcta de cada uno antes de ejecutar nada: 189 casos estándar y 94 más difíciles. Los difíciles se ejecutaron tres veces para comprobar que las respuestas se repiten, lo que da 471 ejecuciones de casos y 1,357 decisiones puntuadas. Idiomas: inglés, turco, cuatro variedades de árabe, árabe escrito en caracteres latinos y 10 más. Entre las tareas había enrutar un mensaje al especialista adecuado, detectar texto de inyección de prompts, leer la transcripción de una llamada para saber cómo terminó y marcar una respuesta que cita un precio que el negocio nunca fijó. Tanto Jev como un modelo Google Gemini de frontera (con esfuerzo de razonamiento bajo) recibieron exactamente los mismos hechos, preguntas y opciones.
Ronda 2: reproducir historial real. Tomamos 402 decisiones reales de enrutamiento que nuestro producto ya había tomado para dos espacios de trabajo de clientes durante 21 días, volvimos a pasar esas mismas conversaciones por Jev y comparamos. El espacio de trabajo A es una firma de servicios profesionales en Oriente Medio, sobre todo en árabe por WhatsApp. El espacio de trabajo B es un servicio de atención sanitaria, sobre todo en inglés y portugués por chat web. Sus decisiones originales venían de modelos de frontera Google Gemini y OpenAI GPT. Nombres, teléfonos, correos y enlaces se enmascararon antes de que ningún texto saliera de nuestros sistemas. Cuando Jev y la decisión original no coincidían, leímos la conversación y juzgamos qué respuesta se ajustaba a las reglas escritas del propio cliente. Los casos que esas reglas no resolvían quedaron fuera.
Qué precisión tuvo Jev en la prueba etiquetada
Casi la misma que el modelo de frontera: 98.5% frente a 99.0% sobre 1,357 decisiones puntuadas, y unas cinco veces más rápido.
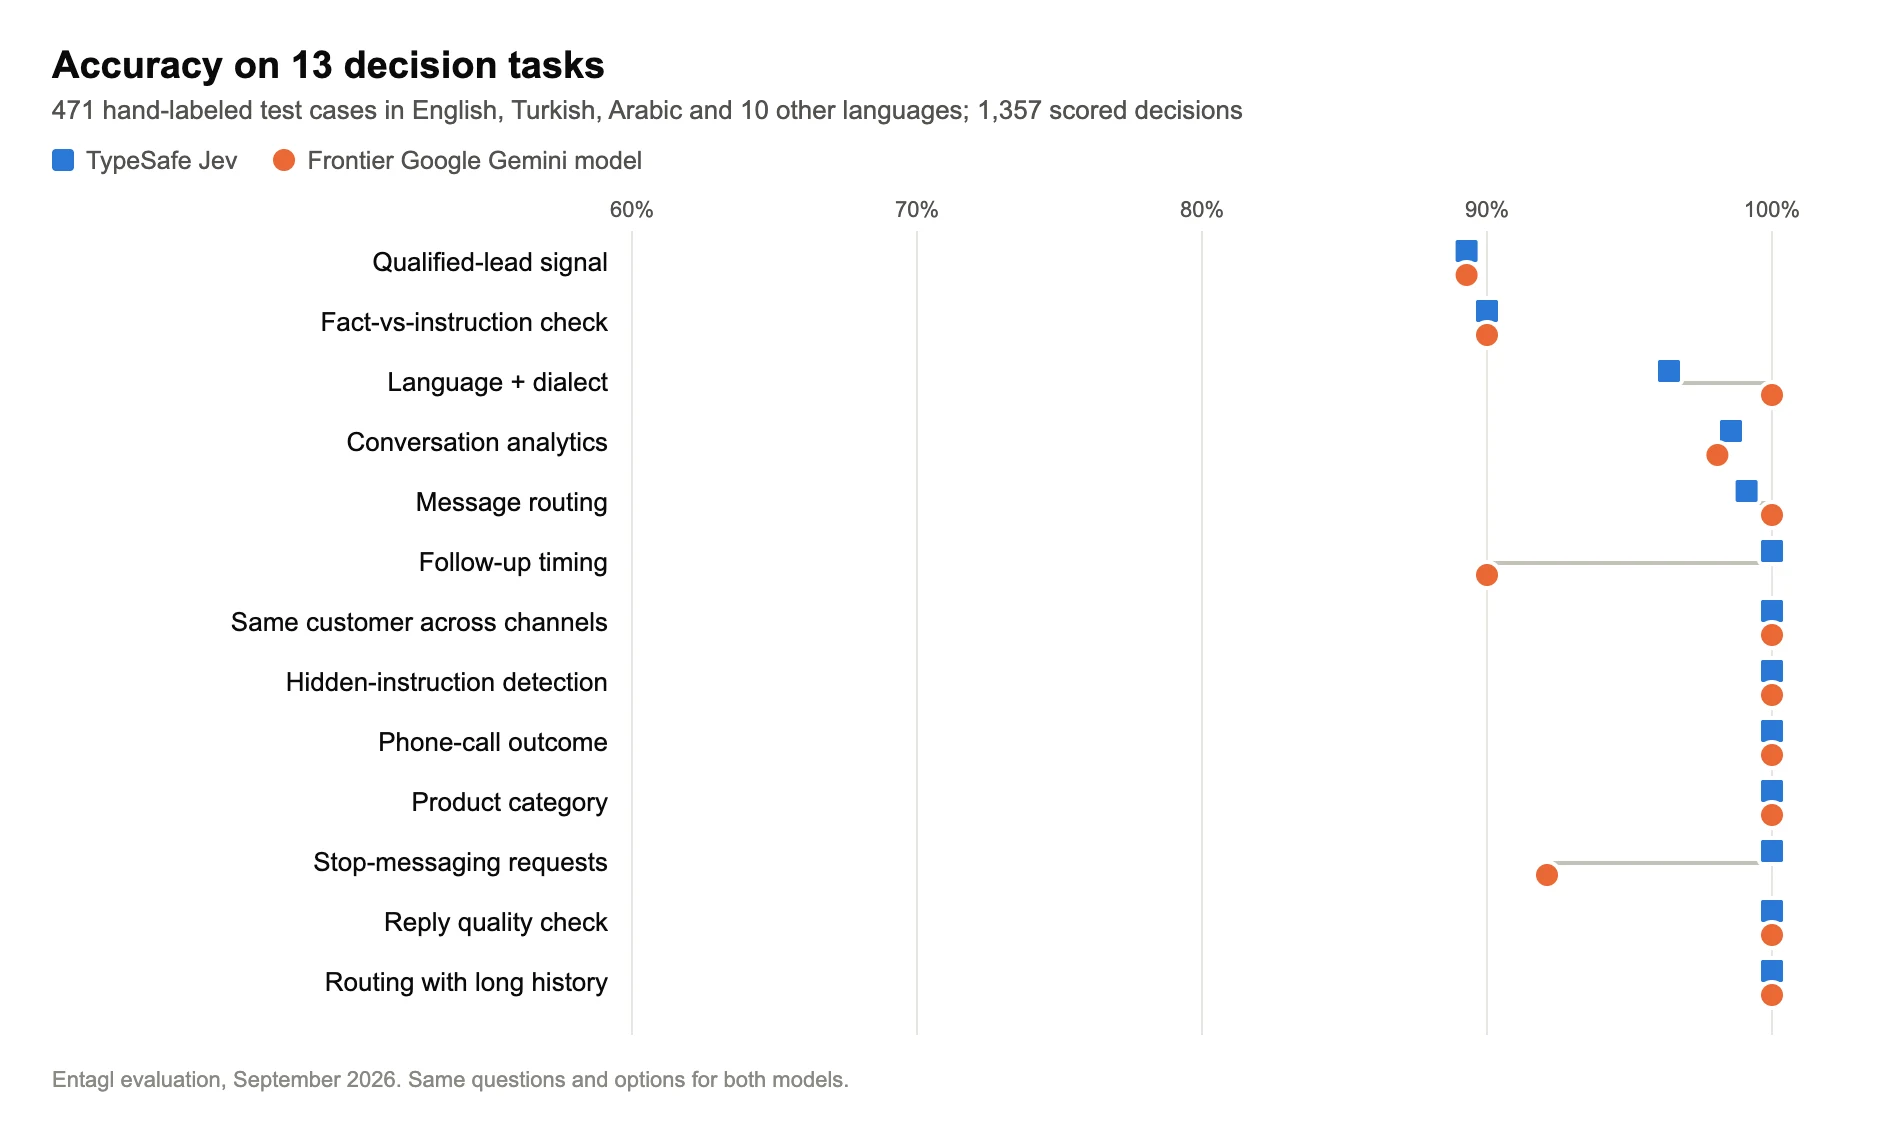
Las diferencias son pequeñas y van en ambas direcciones. Jev entendió que "ya no me interesa" no es una solicitud de baja; Gemini lo marcó como tal. Gemini también interpretó "nuestro equipo te llamará" como enviar al cliente al teléfono, y consideró que "un poco caro, quizá más adelante" no merecía seguimiento, cuando es justo el contacto al que quieres dar un empujón.
El punto débil de Jev fueron los dialectos árabes. Siempre supo que el texto estaba en árabe, pero dos mensajes en árabe del Golfo se leyeron como egipcio o levantino en todas las ejecuciones (seis fallos en total). Y ambos modelos calificaron "¿Cuánto cuesta? 😍" como un contacto cualificado, cuando nuestra regla exigía precio más plazo o datos de contacto. Ahí el problema era la regla, no los modelos.
¿Te puedes fiar de la puntuación de confianza?
En esta prueba, sí. Es lo más útil que ofrece Jev.
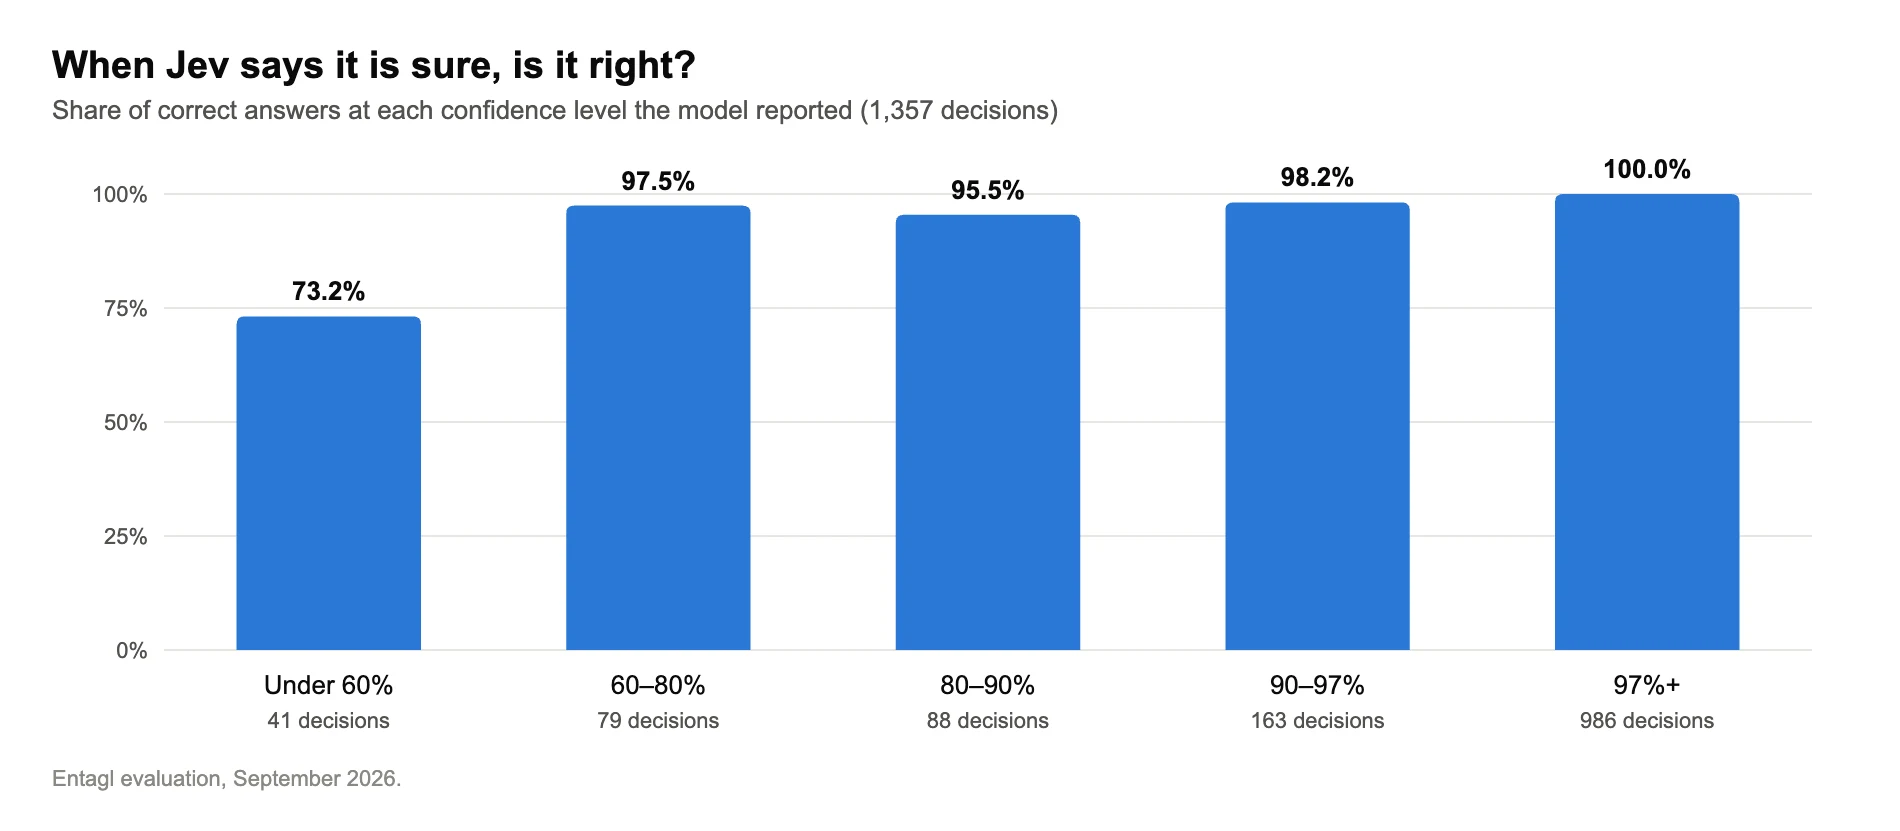
Fija una regla sencilla, "usa la respuesta de Jev solo cuando esté seguro al menos al 85%; si no, pregunta al modelo grande", y Jev se encarga del 88% de las decisiones con un 99.75% de precisión, mientras 17 de sus 20 errores pasan al modelo de respaldo. Todos los fallos de dialecto árabe llegaron con una confianza de entre 0.36 y 0.40, así que la regla los atrapó.
Aun así, se coló un error con confianza alta. Una agencia de publicidad turca escribió "nos gustaría trabajar con ustedes". Jev lo leyó como una candidatura de empleo, con 0.95, en las tres ejecuciones. En ese contexto no causó daño (Jev también lo marcó como propuesta comercial, y esa decisión prevalece), pero sirve de aviso: una puntuación de confianza es una prueba, no un permiso. Sigues necesitando comprobaciones etiquetadas y seguimiento de resultados después de activar cualquier cosa.
Qué pasó al reproducir conversaciones reales
La coincidencia bruta con las decisiones originales fue solo del 74–84%, pero la mayor parte de esa diferencia no se debía a que Jev se equivocara.
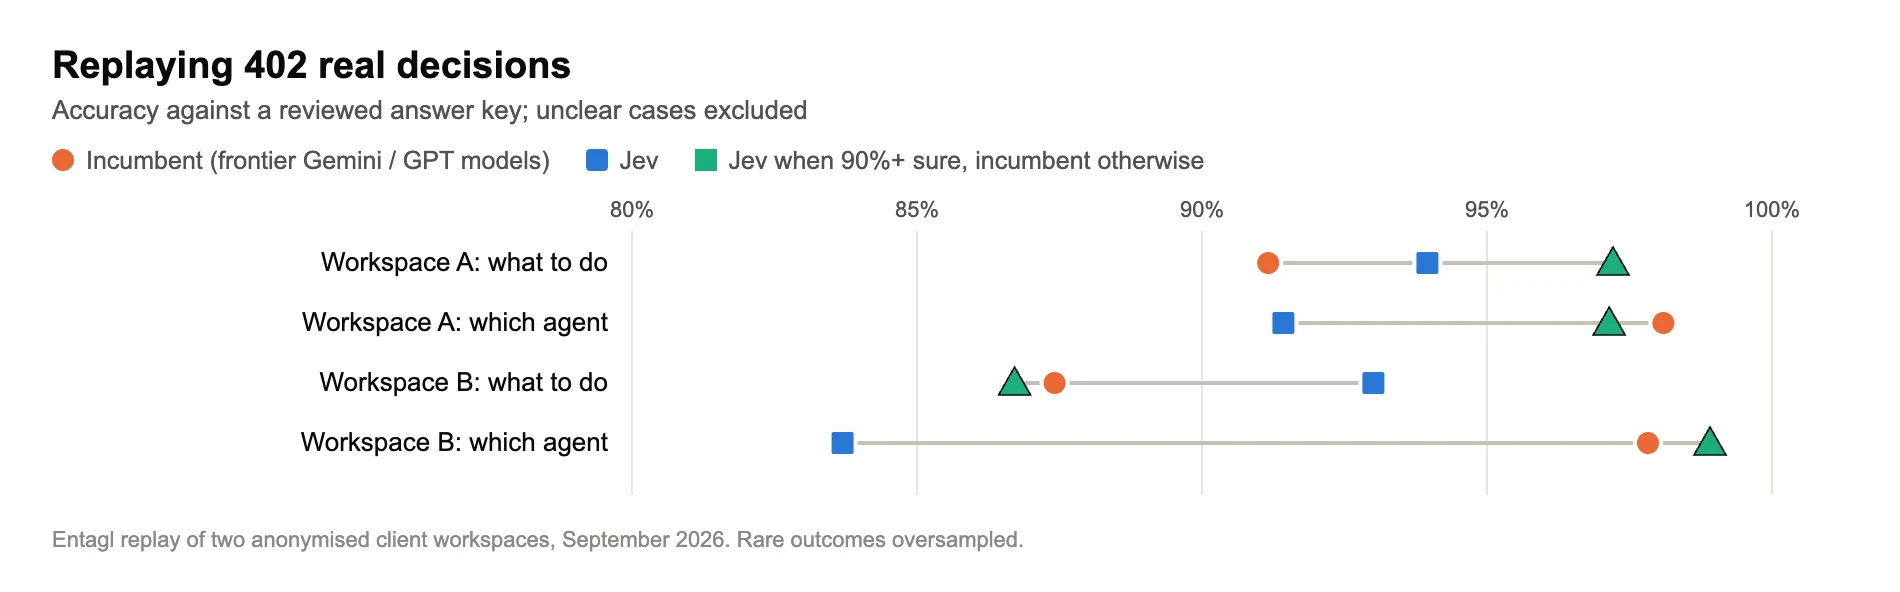
Puntuado frente a la clave de respuestas revisada:
| Decisión | Original (Gemini / GPT de frontera) | Jev | Jev cuando está seguro al 90%+, original en el resto |
|---|---|---|---|
| Espacio A: qué hacer con el mensaje | 91.2% | 94.0% | 97.2% |
| Espacio A: qué especialista responde | 98.1% | 91.4% | 97.1% |
| Espacio B: qué hacer con el mensaje | 87.4% | 93.0% | 86.7% |
| Espacio B: qué especialista responde | 97.8% | 83.7% | 98.9% |
Una rareza: en el espacio de trabajo B, aplicar el umbral empeoró ligeramente la decisión sobre el mensaje (86.7%), porque en los mensajes donde Jev dudaba, recurrir al original implicaba usar precisamente las peores respuestas del original.
Decidir qué hacer con un mensaje (responder, ignorar, derivar a una persona, enviar una respuesta predefinida) salió a favor de Jev en ambos espacios de trabajo. Elegir al especialista, no, y el motivo es muy concreto. La mayoría de los fallos eran mensajes de continuación como "India" o "lo hablo mañana" dentro de una conversación que ya llevaba un especialista. Las reglas del cliente dicen que hay que seguir con ese especialista. Jev veía los últimos ocho mensajes, pero nadie le decía quién llevaba el chat, así que lo deducía por las palabras. La configuración original sí tenía ese contexto y lo usaba.
La reproducción también destapó errores en las decisiones originales, de los que un muestreo puntual no detecta:
- Una regla por palabra clave que saltaba con las personas equivocadas. Se enviaba una respuesta predefinida de derivación cada vez que alguien usaba la palabra "legal" o "abogado". En una muestra de 20, 15 eran preguntas de negocio normales, como "¿qué documentos legales necesito para esto?". Jev las envió a una respuesta de verdad.
- Derivaciones repetidas. Después de que un cliente ya hubiera dado su nombre y su número una vez, mensajes posteriores como "gracias" u "obrigada" disparaban cada uno una nueva derivación al equipo. 17 de las 41 derivaciones que revisamos eran repeticiones de ese tipo.
- Dos reglas que se contradecían, de modo que ambos modelos adivinaban con los mismos mensajes.
Ya los hemos señalado para corregirlos en origen. Las reglas por palabra clave como la primera son exactamente de lo que advierte nuestra guía para evitar que los agentes de IA alucinen.
Dónde se queda corto Jev
Sin rodeos:
- Los matices fuera del inglés. La propia documentación de TypeSafe dice que el inglés es su idioma principal de entrenamiento y que los demás idiomas se "gestionan, aunque no igual de bien". Lo comprobamos: 99.1% en inglés, 98.4% en turco, 96.5% en árabe. Seis de los nueve fallos en árabe fueron confusiones de dialecto; los otros tres vinieron de un mensaje dudoso de tipo "¿esto es una queja?" y de una etiqueta que nosotros mismos discutiríamos.
- El contexto que falta y no puede deducir. Quién lleva la conversación, si ya se recogieron los datos de contacto: en la reproducción real, Jev perdía puntos cada vez que la respuesta dependía de un dato que no estaba en el texto que le enviamos. La solución es calcular esos datos en código y pasárselos, no esperar a que el modelo los adivine.
- El texto prerrellenado de los anuncios. Muchos chats de WhatsApp que llegan desde anuncios de clic para enviar mensaje empiezan con una línea de plantilla como "Me gustaría saber más sobre sus servicios". Jev se apoyó en esa línea y dejó pasar como contactos comerciales a varias personas que en realidad buscaban empleo o pedían ayuda benéfica, una de ellas con 0.92 de confianza. Elimina la plantilla primero.
- Lo que nunca se diseñó para hacer. TypeSafe enumera sus propios "bordes irregulares": aritmética, conteo, comparación de fechas, entradas largas llenas de detalles irrelevantes y texto escrito para manipularlo. Deja las cuentas y las fechas en el código.
- Es completamente nuevo. Lanzado en septiembre de 2026, con límites de uso que el proveedor dice que pueden cambiar. Cualquier cosa construida sobre él necesita un plan alternativo.
Dónde usaríamos un modelo de decisión como Jev
En cualquier sitio donde a un LLM se le pida elegir de una lista y nadie lea el resultado:
- Enrutamiento y filtrado de primera pasada, con un umbral de confianza y un modelo más grande detrás.
- Analítica diaria de conversaciones (categoría, sentimiento, "preguntó el precio") sobre todas las conversaciones, no sobre una muestra.
- Controles de seguridad siempre activos: solicitudes de dejar de recibir mensajes en cualquier idioma, o texto que intenta dar instrucciones al asistente (consulta nuestra guía sobre inyección de prompts).
- Resultados de llamadas convertidos en datos, leídos a partir de la transcripción.
Agrupa también tus preguntas: la propia prueba de TypeSafe con un documento largo mostró que hacer 13 preguntas en una sola llamada en lugar de 13 llamadas era 12.2 veces más barato y 10 veces más rápido, con las mismas respuestas.
Y dónde no lo usaríamos: redactar respuestas, cualquier cosa numérica, cualquier caso en que una respuesta errónea dada con seguridad silencie a un cliente real. Bloquear un mensaje directamente debería exigir una confianza muy alta o una segunda opinión.
Cómo evaluar tú mismo un modelo de decisión
Lo que nos funcionó:
- Etiqueta antes de ejecutar. "Coincide con el modelo actual" no es lo mismo que "es correcto". Nuestra reproducción demostró que el modelo en uso se equivocaba con la suficiente frecuencia como para importar.
- Separa por idioma. Una media del 98% puede esconder un 96% en un idioma que tus clientes usan de verdad.
- Grafica la precisión por nivel de confianza y después reproduce historial real. Un modelo barato sin un umbral fiable es un riesgo, y nuestros casos redactados rozaron el 100% con ambos modelos; fue en el tráfico real donde aparecieron las diferencias, y también los fallos del propio modelo en uso.
- Pruébalo en la sombra antes de cambiar. Ejecuta el nuevo modelo en silencio junto al antiguo y cambia tarea por tarea, nunca todo a la vez.
Esto encaja con una idea más amplia que ya hemos defendido sobre no apostar tu producto a un único modelo de IA: el modelo adecuado para "decidir" a menudo no es el adecuado para "redactar", y los modelos más pequeños y baratos ya resuelven una parte del primer trabajo mayor de lo que la mayoría de los equipos cree.
FAQ
¿TypeSafe Jev sustituye a GPT o a Gemini?
No. Sustituye un tipo de llamada: elegir entre opciones que tú defines, puntuar en una escala o responder sí/no. No puede redactar texto, usar herramientas ni leer imágenes, así que un agente de cara al cliente sigue necesitando un modelo de lenguaje para la respuesta.
¿Qué precisión tiene TypeSafe Jev comparado con los LLM de frontera?
En nuestra prueba de septiembre de 2026, con 1,357 decisiones etiquetadas, obtuvo un 98.5%, frente al 99.0% de un modelo Google Gemini de frontera. Con historial real de conversaciones lo hizo mejor al decidir qué hacer con un mensaje y peor al elegir el especialista adecuado a mitad de conversación.
¿Funciona TypeSafe Jev en árabe y en turco?
Sí, con un matiz. El turco quedó cerca del inglés en nuestra prueba (98.4% frente a 99.1%). El árabe se quedó en el 96.5%. La mayoría de los fallos fueron confusiones de dialecto (árabe del Golfo leído como egipcio o levantino), nunca de idioma, y llegaron con puntuaciones de confianza bajas.
¿Te puedes fiar de la puntuación de confianza de Jev?
En nuestros datos siguió bien a la precisión: 100% de aciertos con un 97% de confianza o más, 73% por debajo del 60%. Aun así hubo un error con confianza alta (0.95), así que usa la puntuación para decidir cuándo recurrir al respaldo y sigue revisando los resultados reales.
¿Es más barato y más rápido que un LLM?
En nuestras llamadas de prueba costó unas 25 veces menos y respondió con una mediana de 329 ms frente a 1,598 ms, sobre todo porque Jev solo factura los tokens de entrada y devuelve una respuesta tipada breve en lugar de texto generado.
¿Quieres una IA que sepa cuándo no está segura?
Probamos modelos como este para que los agentes que atienden a tus clientes acierten en las decisiones baratas y rápidas y pasen las difíciles a algo más grande. Para ver cómo funciona con tus propios mensajes directos, reserva una demo de 30 minutos, o descubre cómo lo resuelven hoy nuestros agentes de IA para los DM de Instagram y WhatsApp.
Fuentes y método: evaluación de Entagl, septiembre de 2026. Ronda 1: 283 casos de prueba etiquetados a mano (189 estándar, más 94 casos difíciles ejecutados tres veces: 471 ejecuciones de casos), 1,357 decisiones puntuadas, TypeSafe Jev (jev-1.13.0) frente a un modelo Google Gemini de frontera con entradas idénticas; el coste compara los tokens facturados en llamadas idénticas según el precio de lista de cada proveedor en septiembre de 2026 (Jev solo factura los tokens de entrada). Ronda 2: 402 decisiones reales de enrutamiento de dos espacios de trabajo de clientes anonimizados durante 21 días, con los datos personales enmascarados antes del procesamiento; los desacuerdos se revisaron según las reglas escritas de cada cliente, se excluyeron los casos dudosos y se sobremuestrearon los resultados poco frecuentes, por lo que los porcentajes no son una media de producción. Un único revisor. Datos del proveedor: anuncio de lanzamiento de TypeSafe, documentación de modelos de TypeSafe, limitaciones conocidas de Jev 1.13, guía de preguntas en paralelo de TypeSafe. Contexto sobre calibración: Guo et al., ICML 2017.