AI News · industry
TypeSafe Jev απέναντι στο Gemini σε 1.759 αποφάσεις: 5x ταχύτερο, 25x φθηνότερο, 98,5% ακρίβεια
Δοκιμάσαμε το νέο μοντέλο αποφάσεων της TypeSafe σε 1.357 αποφάσεις με προκαθορισμένη σωστή απάντηση, σε 13 γλώσσες, και σε 402 πραγματικές συνομιλίες πελατών. Έφτασε σχεδόν ένα frontier LLM με κλάσμα του χρόνου και του κόστους, και μετά μας έδειξε ακριβώς πού σπάει.
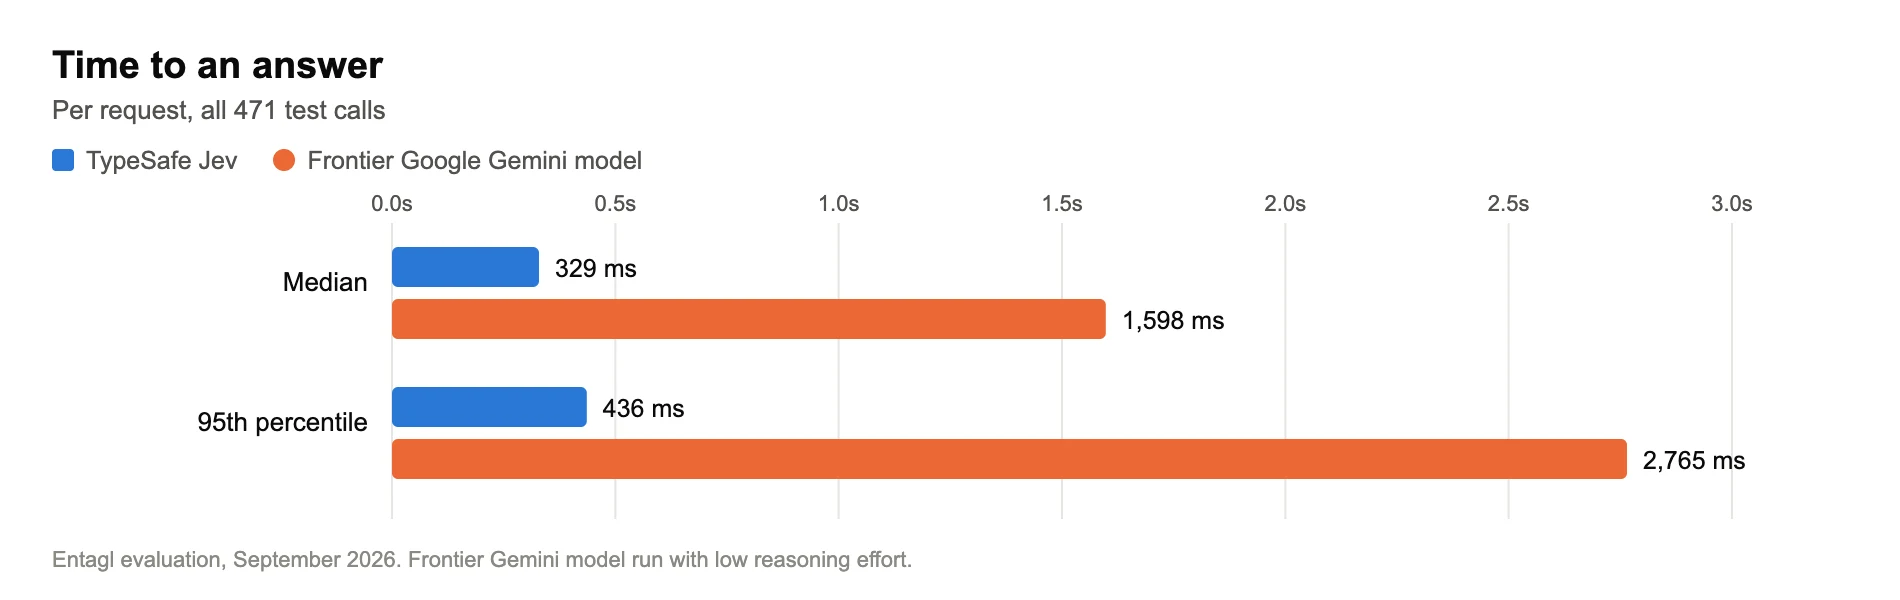
Δώσαμε στο TypeSafe Jev, το μοντέλο που κάνει μόνο αποφάσεις και που η TypeSafe παρουσίασε στις 15 Σεπτεμβρίου, 1.759 αποφάσεις να πάρει: 1.357 δοκιμαστικές αποφάσεις σε 13 γλώσσες, με τη σωστή απάντηση ορισμένη με το χέρι, και 402 πραγματικές αποφάσεις δρομολόγησης από ζωντανές συνομιλίες πελατών. Απέναντι σε ένα frontier μοντέλο Google Gemini ήταν 5x ταχύτερο (διάμεσος 329 ms έναντι 1.598 ms), 25x φθηνότερο και σχεδόν εξίσου ακριβές (98,5% έναντι 99,0%). Όποτε δήλωνε βεβαιότητα 97% ή περισσότερο, είχε δίκιο 986 φορές στις 986.
Μετά ξαναπαίξαμε πραγματική κίνηση πελατών, και εκεί έσπασε με τρόπους που κανένα test set δεν είχε προβλέψει. Ακολουθούν όλα: τα νούμερα, τα γραφήματα, τα τυφλά σημεία, και πού θα το χρησιμοποιούσαμε και πού όχι.
Τι είναι το TypeSafe Jev και σε τι διαφέρει από ένα LLM;
Η TypeSafe ανακοίνωσε το Jev στις 15 Σεπτεμβρίου 2026 ως το πρώτο της μοντέλο «System One», όνομα δανεισμένο από τη γρήγορη, διαισθητική σκέψη System 1 του Daniel Kahneman. Δεν του ζητάτε κείμενο. Του στέλνετε τα δεδομένα (ένα μήνυμα, ένα σύντομο ιστορικό, μια λίστα επιλογών) και ερωτήσεις με συγκεκριμένο τύπο, και σας επιστρέφει έναν από τρεις τύπους απάντησης:
| Τύπος ερώτησης | Τι ρωτάτε | Τι παίρνετε πίσω |
|---|---|---|
| Ναι/όχι | «Μας ζητά αυτό το μήνυμα να σταματήσουμε να επικοινωνούμε;» | Μια πιθανότητα, π.χ. 0,97 |
| Επιλογή ενός | «Ποια από αυτές τις τέσσερις ομάδες πρέπει να απαντήσει;» | Την επιλογή, μια πιθανότητα για κάθε εναλλακτική και έναν δείκτη βεβαιότητας |
| Βαθμολογία | «Πόσο εκνευρισμένος είναι ο πελάτης, σε κλίμακα 5 βαθμίδων;» | Μια θέση στην κλίμακα μαζί με τη διασπορά |
Δεν γράφει απαντήσεις, δεν καλεί εργαλεία και δεν διαβάζει εικόνες. Η TypeSafe το εκπαιδεύει με αυτό που αποκαλεί reinforcement learning για βαθμονομημένες αποφάσεις. Ο στόχος είναι το «90% σίγουρο» να σημαίνει πραγματικά σωστό περίπου 9 φορές στις 10, κάτι στο οποίο τα συνηθισμένα γλωσσικά μοντέλα τα πάνε άσχημα. Μια γνωστή μελέτη του 2017 έδειξε ότι τα σύγχρονα νευρωνικά δίκτυα τείνουν να είναι υπερβολικά σίγουρα για τον εαυτό τους (Guo et al., «On Calibration of Modern Neural Networks», ICML 2017). Ασυνήθιστη είναι και η τιμολόγηση: η TypeSafe χρεώνει μόνο τα input tokens, το output είναι δωρεάν.
Μπορεί ένα στενό, φθηνό μοντέλο αποφάσεων να αναλάβει τα βήματα «αποφασίζω» από ένα frontier LLM χωρίς να αυξηθούν τα λάθη; Να τα δεδομένα μας.
Πώς το δοκιμάσαμε;
Δύο γύροι, ίδιες ερωτήσεις για κάθε μοντέλο.
Γύρος 1: ένα test set με προκαθορισμένες απαντήσεις. Γράψαμε 283 ρεαλιστικές περιπτώσεις σε 13 εργασίες απόφασης και ορίσαμε τη σωστή απάντηση για καθεμία πριν τρέξουμε οτιδήποτε: 189 τυπικές περιπτώσεις και 94 δυσκολότερες. Οι δύσκολες έτρεξαν τρεις φορές, για να ελέγξουμε ότι οι απαντήσεις επαναλαμβάνονται, άρα 471 εκτελέσεις και 1.357 βαθμολογημένες αποφάσεις. Γλώσσες: Αγγλικά, Τουρκικά, τέσσερις παραλλαγές των Αραβικών, Αραβικά γραμμένα με λατινικούς χαρακτήρες και άλλες 10. Οι εργασίες περιλάμβαναν τη δρομολόγηση ενός μηνύματος στον σωστό ειδικό, τον εντοπισμό κειμένου prompt injection, την ανάγνωση της απομαγνητοφώνησης ενός τηλεφωνήματος για να βγει το αποτέλεσμά του, και τον εντοπισμό μιας απάντησης που αναφέρει τιμή την οποία η επιχείρηση δεν όρισε ποτέ. Το Jev και ένα frontier μοντέλο Google Gemini (με χαμηλό reasoning effort) πήραν ακριβώς τα ίδια δεδομένα, τις ίδιες ερωτήσεις και τις ίδιες επιλογές.
Γύρος 2: αναπαραγωγή πραγματικού ιστορικού. Πήραμε 402 πραγματικές αποφάσεις δρομολόγησης που είχε ήδη πάρει το προϊόν μας για δύο workspaces πελατών μέσα σε 21 ημέρες, περάσαμε τις ίδιες συνομιλίες ξανά από το Jev και συγκρίναμε. Το Workspace A είναι μια εταιρεία επαγγελματικών υπηρεσιών στη Μέση Ανατολή, κυρίως Αραβικά στο WhatsApp. Το Workspace B είναι μια υπηρεσία υποστήριξης στον χώρο της υγείας, κυρίως Αγγλικά και Πορτογαλικά στο web chat. Οι αρχικές τους αποφάσεις προέρχονταν από frontier μοντέλα Google Gemini και OpenAI GPT. Ονόματα, αριθμοί τηλεφώνου, emails και links καλύφθηκαν πριν βγει οποιοδήποτε κείμενο από τα συστήματά μας. Όπου το Jev διαφωνούσε με την αρχική απόφαση, διαβάσαμε τη συνομιλία και κρίναμε ποια απάντηση συμφωνούσε με τους γραπτούς κανόνες του ίδιου του πελάτη. Όσες περιπτώσεις δεν ξεκαθάριζαν οι κανόνες, τις αφήσαμε έξω.
Πόσο ακριβές ήταν το Jev στο test με τις προκαθορισμένες απαντήσεις;
Περίπου όσο και το frontier μοντέλο: 98,5% έναντι 99,0% σε 1.357 βαθμολογημένες αποφάσεις, και περίπου πέντε φορές ταχύτερο.
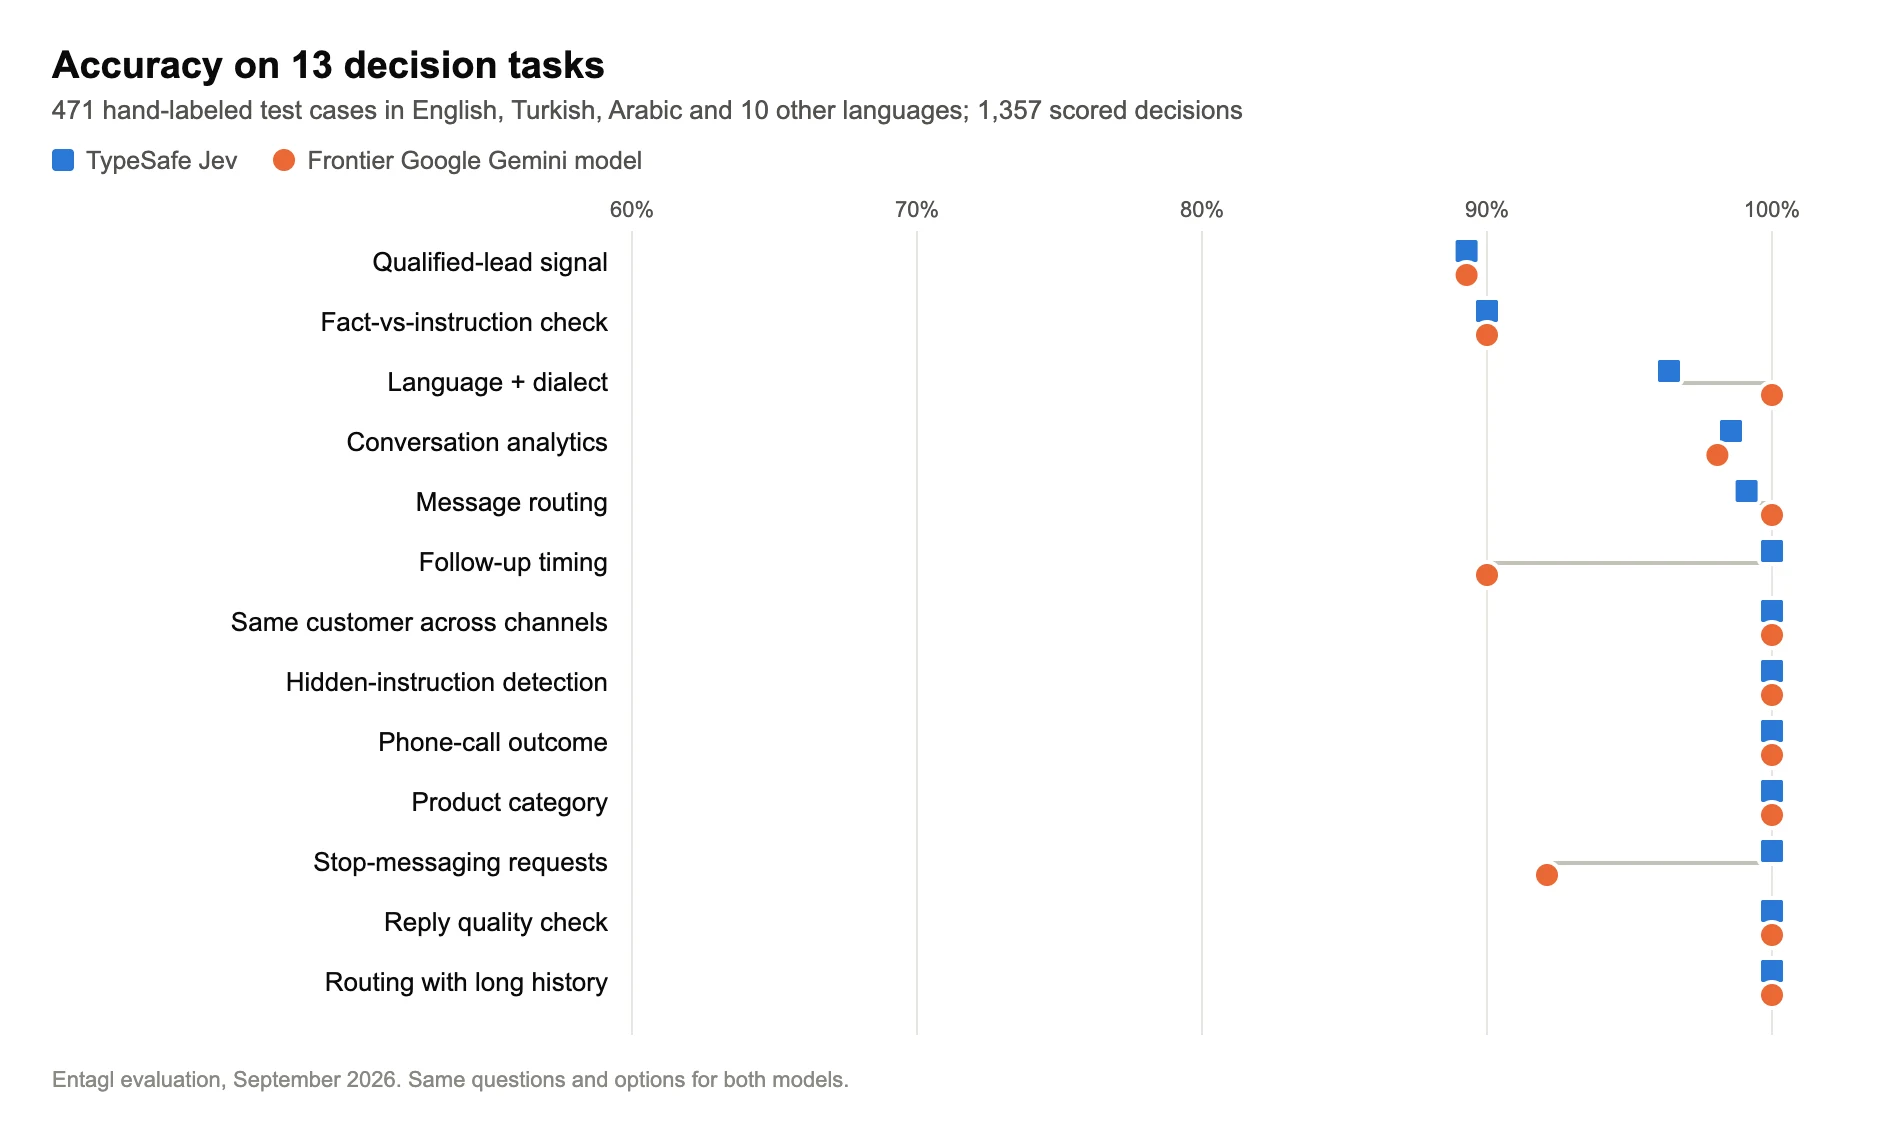
Οι διαφορές είναι μικρές και πάνε και προς τις δύο κατευθύνσεις. Το Jev κατάλαβε ότι το «Δεν με ενδιαφέρει πια» δεν είναι αίτημα διαγραφής· το Gemini το σημείωσε ως τέτοιο. Το Gemini επίσης μέτρησε το «η ομάδα μας θα σας καλέσει» ως παραπομπή του πελάτη στο τηλέφωνο, και έκρινε ότι το «λίγο ακριβό, ίσως αργότερα» δεν αξίζει follow-up, ενώ αυτό ακριβώς είναι το lead που θέλετε να ξανασπρώξετε.
Το αδύναμο σημείο του Jev ήταν οι αραβικές διάλεκτοι. Πάντα καταλάβαινε ότι το κείμενο ήταν αραβικό, αλλά δύο μηνύματα στα Αραβικά του Κόλπου διαβάστηκαν ως αιγυπτιακά ή λεβαντίνικα σε κάθε εκτέλεση (έξι αστοχίες συνολικά). Και τα δύο μοντέλα χαρακτήρισαν το «Πόσο κάνει; 😍» ως qualified lead, ενώ ο κανόνας μας απαιτούσε τιμή μαζί με χρονοδιάγραμμα ή στοιχεία επικοινωνίας. Εκεί το πρόβλημα ήταν ο κανόνας, όχι τα μοντέλα.
Μπορείτε να εμπιστευτείτε τον δείκτη βεβαιότητας;
Σε αυτό το test, ναι. Είναι το πιο χρήσιμο πράγμα που προσφέρει το Jev.
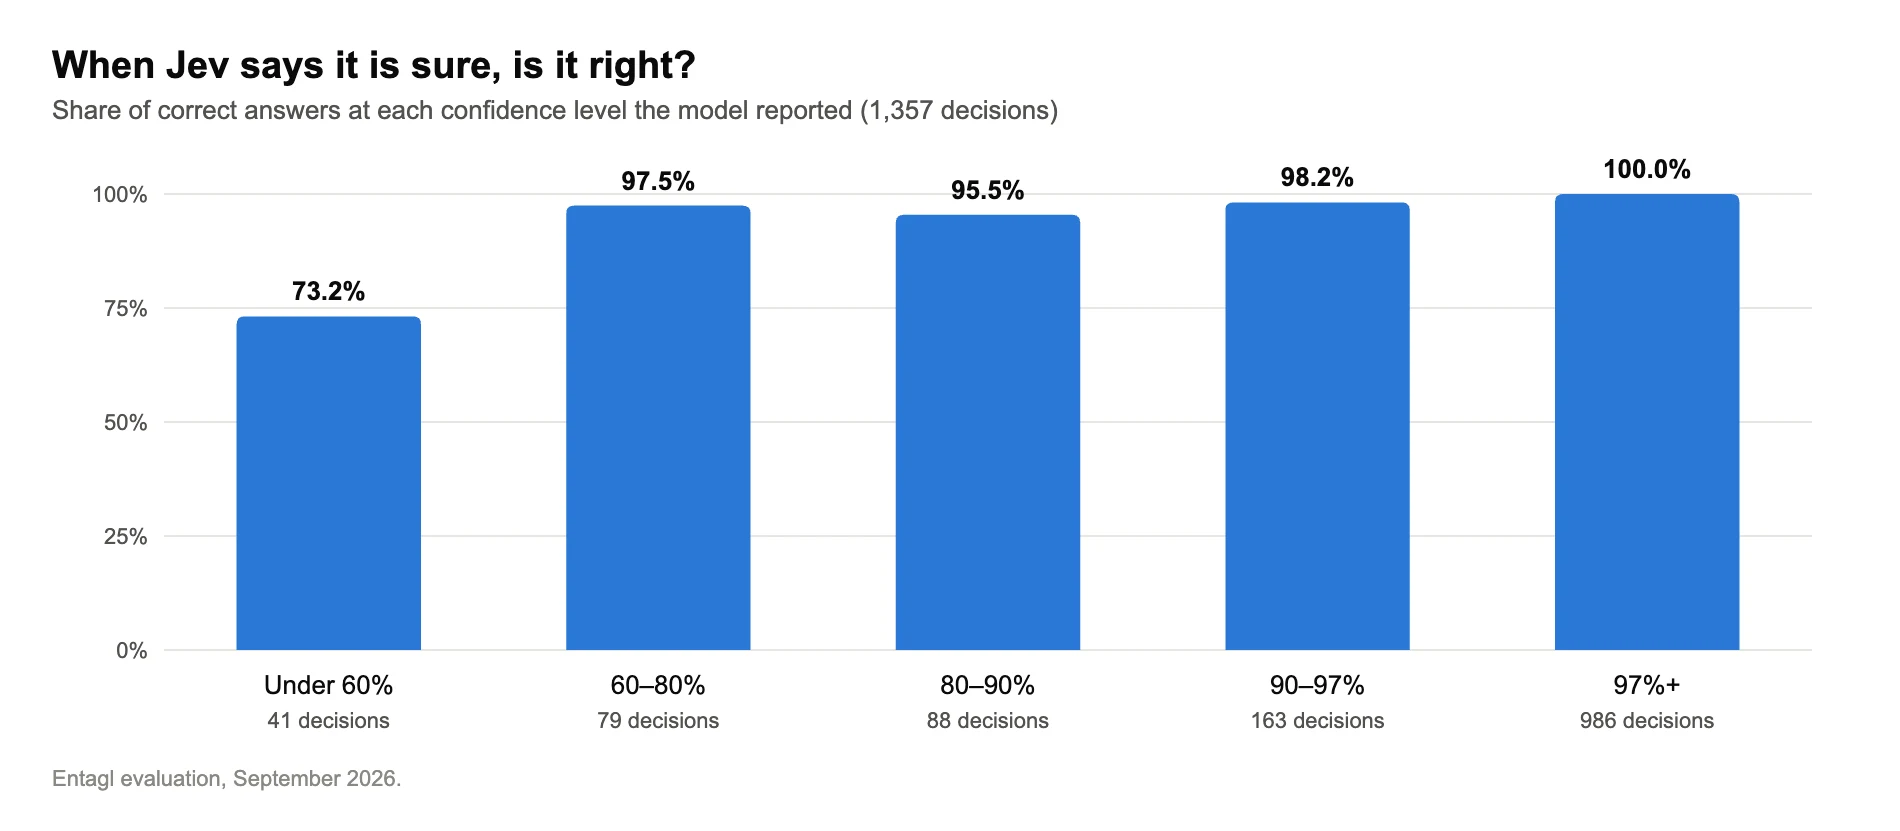
Βάλτε έναν απλό κανόνα, «χρησιμοποίησε την απάντηση του Jev μόνο όταν είναι τουλάχιστον 85% σίγουρο, αλλιώς ρώτα το μεγαλύτερο μοντέλο», και το Jev χειρίζεται το 88% των αποφάσεων με ακρίβεια 99,75%, ενώ 17 από τα 20 λάθη του περνούν στο εφεδρικό μοντέλο. Κάθε αστοχία σε αραβική διάλεκτο είχε βεβαιότητα από 0,36 έως 0,40, οπότε ο κανόνας τις έπιασε.
Ένα λάθος πέρασε παρ' όλα αυτά με υψηλή βεβαιότητα. Ένα τουρκικό διαφημιστικό γραφείο έγραψε «θα θέλαμε να συνεργαστούμε μαζί σας». Το Jev το διάβασε ως αίτηση για δουλειά, με 0,95, και στις τρεις εκτελέσεις. Στο συγκεκριμένο πλαίσιο δεν έκανε ζημιά (το Jev το σημείωσε επίσης ως εμπορική προσέγγιση, και αυτή η απόφαση υπερισχύει), είναι όμως μια δίκαιη προειδοποίηση: ο δείκτης βεβαιότητας είναι ένδειξη, όχι άδεια. Χρειάζεστε ακόμη ελέγχους με γνωστές σωστές απαντήσεις και παρακολούθηση των αποτελεσμάτων αφού ενεργοποιήσετε οτιδήποτε.
Τι έγινε όταν ξαναπαίξαμε πραγματικές συνομιλίες;
Η ωμή συμφωνία με τις αρχικές αποφάσεις ήταν μόλις 74–84%, αλλά το μεγαλύτερο μέρος αυτής της απόστασης δεν οφειλόταν σε λάθη του Jev.
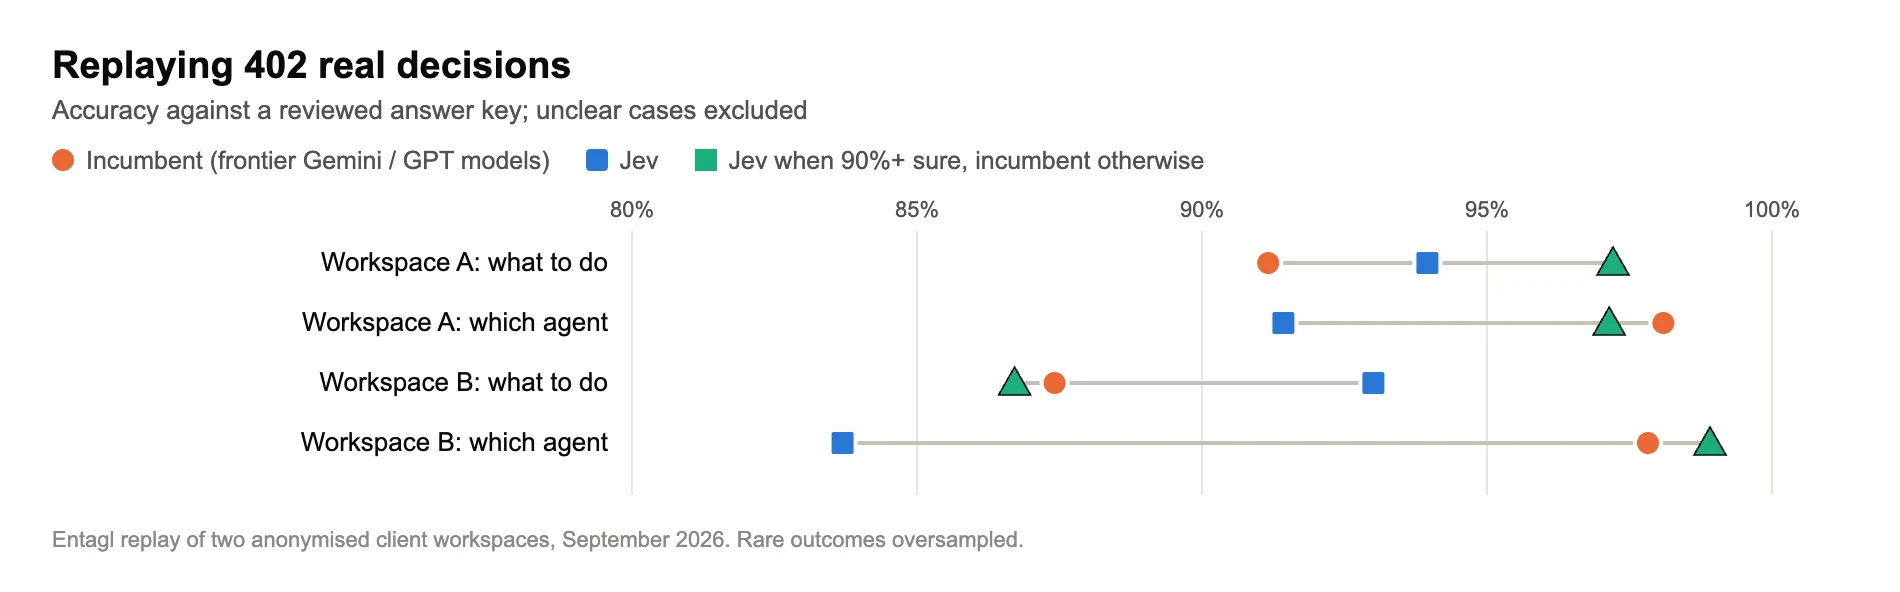
Βαθμολογημένα έναντι του ελεγμένου κλειδιού απαντήσεων:
| Απόφαση | Αρχική (frontier Gemini / GPT) | Jev | Jev όταν είναι 90%+ σίγουρο, αλλιώς η αρχική |
|---|---|---|---|
| Workspace A: τι γίνεται με το μήνυμα | 91,2% | 94,0% | 97,2% |
| Workspace A: ποιος ειδικός απαντά | 98,1% | 91,4% | 97,1% |
| Workspace B: τι γίνεται με το μήνυμα | 87,4% | 93,0% | 86,7% |
| Workspace B: ποιος ειδικός απαντά | 97,8% | 83,7% | 98,9% |
Μια παραξενιά: στο Workspace B, το κατώφλι βεβαιότητας έκανε την απόφαση για το μήνυμα ελαφρώς χειρότερη (86,7%), επειδή στα μηνύματα όπου το Jev δεν ήταν σίγουρο, η επιστροφή στην αρχική απόφαση σήμαινε να χρησιμοποιηθούν οι πιο αδύναμες απαντήσεις της αρχικής.
Η απόφαση για το τι θα γίνει με ένα μήνυμα (απάντηση, αγνόηση, παράδοση σε άνθρωπο, έτοιμη απάντηση) κρίθηκε υπέρ του Jev και στα δύο workspaces. Η επιλογή του ειδικού όχι, και ο λόγος είναι πολύ συγκεκριμένος. Οι περισσότερες αστοχίες ήταν συνέχειες όπως «India» ή «θα το συζητήσω αύριο», μέσα σε μια συνομιλία που ήδη εξελισσόταν με έναν ειδικό. Οι κανόνες του πελάτη λένε να μείνει η συνομιλία σε αυτόν τον ειδικό. Το Jev έβλεπε τα τελευταία οκτώ μηνύματα, αλλά κανείς δεν του είχε πει σε ποιον ανήκε η συνομιλία, οπότε μάντευε από τις λέξεις. Η αρχική ρύθμιση είχε αυτή την πληροφορία και τη χρησιμοποιούσε.
Η αναπαραγωγή εντόπισε επίσης λάθη στις αρχικές αποφάσεις, από εκείνα που ένας δειγματοληπτικός έλεγχος δεν πιάνει:
- Ένας κανόνας λέξης-κλειδιού που ενεργοποιούνταν για λάθος ανθρώπους. Μια έτοιμη απάντηση παραπομπής έφευγε κάθε φορά που κάποιος έγραφε τη λέξη «legal» ή «lawyer». Σε δείγμα 20 μηνυμάτων, τα 15 ήταν συνηθισμένες επαγγελματικές ερωτήσεις, όπως «τι νομικά έγγραφα χρειάζομαι γι' αυτό;». Το Jev τα έστειλε σε πραγματική απάντηση.
- Επαναλαμβανόμενες παραδόσεις σε άνθρωπο. Αφού ο πελάτης είχε δώσει μία φορά το όνομα και το τηλέφωνό του, τα επόμενα μηνύματα, όπως «thanks» ή «obrigada», πυροδοτούσαν το καθένα μια καινούρια παράδοση στο προσωπικό. 17 από τις 41 παραδόσεις του δείγματός μας ήταν τέτοιες επαναλήψεις.
- Δύο κανόνες που αντέφασκαν μεταξύ τους, με αποτέλεσμα και τα δύο μοντέλα να μαντεύουν στα ίδια μηνύματα.
Τα έχουμε σημειώσει για διόρθωση στην πηγή. Κανόνες λέξεων-κλειδιών σαν τον πρώτο είναι ακριβώς αυτό για το οποίο προειδοποιεί ο οδηγός μας για το πώς σταματάτε τις παραισθήσεις των AI agents.
Πού υστερεί το Jev;
Χωρίς περιστροφές:
- Αποχρώσεις εκτός Αγγλικών. Η ίδια η τεκμηρίωση της TypeSafe αναφέρει ότι τα Αγγλικά είναι η κύρια γλώσσα εκπαίδευσης και ότι οι άλλες γλώσσες υποστηρίζονται «αλλά όχι εξίσου καλά». Το είδαμε: 99,1% στα Αγγλικά, 98,4% στα Τουρκικά, 96,5% στα Αραβικά. Έξι από τις εννέα αστοχίες στα Αραβικά ήταν μπερδέματα διαλέκτων· οι άλλες τρεις προήλθαν από ένα οριακό μήνυμα τύπου «είναι αυτό παράπονο;» και από μια ετικέτα για την οποία θα διαφωνούσαμε κι εμείς οι ίδιοι.
- Πλαίσιο που λείπει και δεν μπορεί να το συμπεράνει. Σε ποιον ανήκει η συνομιλία, αν τα στοιχεία επικοινωνίας έχουν ήδη συλλεχθεί: στην αναπαραγωγή πραγματικών συνομιλιών, το Jev έχανε πόντους κάθε φορά που η απάντηση εξαρτιόταν από κάτι που δεν υπήρχε στο κείμενο που του στείλαμε. Η λύση είναι να υπολογίζετε αυτά τα δεδομένα σε κώδικα και να του τα δίνετε έτοιμα, όχι να ελπίζετε ότι το μοντέλο θα μαντέψει.
- Προσυμπληρωμένο κείμενο διαφημίσεων. Πολλά chat στο WhatsApp που ξεκινούν από διαφημίσεις click-to-message ανοίγουν με μια έτοιμη φράση όπως «Θα ήθελα να μάθω περισσότερα για τις υπηρεσίες σας». Το Jev στηρίχτηκε σε αυτή τη φράση και άφησε αρκετούς πραγματικούς υποψήφιους για δουλειά και αιτήματα φιλανθρωπικών οργανώσεων να περάσουν ως επαγγελματικά leads, ένα από αυτά με βεβαιότητα 0,92. Αφαιρέστε πρώτα το έτοιμο κείμενο.
- Πράγματα για τα οποία δεν φτιάχτηκε ποτέ. Η TypeSafe καταγράφει τις δικές της «jagged edges»: αριθμητική, μέτρηση, σύγκριση ημερομηνιών, μεγάλα inputs γεμάτα άσχετες λεπτομέρειες, και κείμενο γραμμένο για να το χειραγωγήσει. Κρατήστε τα μαθηματικά και τις ημερομηνίες στον κώδικα.
- Είναι ολοκαίνουργιο. Κυκλοφόρησε τον Σεπτέμβριο του 2026, με rate limits που ο κατασκευαστής λέει ότι μπορεί να αλλάξουν. Ό,τι χτιστεί πάνω του χρειάζεται εναλλακτική λύση.
Πού θα χρησιμοποιούσαμε ένα μοντέλο αποφάσεων σαν το Jev;
Όπου ένα LLM καλείται να διαλέξει από μια λίστα και κανείς δεν διαβάζει το αποτέλεσμα:
- Πρώτη δρομολόγηση και φιλτράρισμα, με κατώφλι βεβαιότητας και ένα μεγαλύτερο μοντέλο από πίσω.
- Καθημερινά analytics συνομιλιών (κατηγορία, συναίσθημα, «ρώτησε την τιμή») σε κάθε συνομιλία, όχι σε δείγμα.
- Έλεγχοι ασφαλείας που τρέχουν συνέχεια: αιτήματα διακοπής μηνυμάτων σε οποιαδήποτε γλώσσα, ή κείμενο που προσπαθεί να δώσει εντολές στον βοηθό (δείτε τον οδηγό μας για το prompt injection).
- Αποτελέσματα κλήσεων ως δεδομένα, βγαλμένα από την απομαγνητοφώνηση.
Ομαδοποιήστε και τις ερωτήσεις σας: στη δική της δοκιμή σε ένα μεγάλο έγγραφο, η TypeSafe βρήκε ότι 13 ερωτήσεις σε μία κλήση, αντί για 13 κλήσεις, ήταν 12,2 φορές φθηνότερες και 10 φορές ταχύτερες, με τις ίδιες απαντήσεις.
Και πού δεν θα το χρησιμοποιούσαμε: για τη σύνταξη απαντήσεων, για οτιδήποτε αριθμητικό, για οτιδήποτε όπου μια λάθος απάντηση δοσμένη με σιγουριά φιμώνει έναν πραγματικό πελάτη. Ο πλήρης αποκλεισμός ενός μηνύματος πρέπει να απαιτεί πολύ υψηλή βεβαιότητα ή δεύτερη γνώμη.
Πώς να αξιολογήσετε μόνοι σας ένα μοντέλο αποφάσεων;
Αυτό που δούλεψε για εμάς:
- Ορίστε τις σωστές απαντήσεις πριν τρέξετε. Το «συμφωνεί με το τωρινό μοντέλο» δεν ταυτίζεται με το «σωστό». Η αναπαραγωγή μας έδειξε ότι το υπάρχον μοντέλο έκανε λάθη αρκετά συχνά ώστε να μετράει.
- Χωρίστε ανά γλώσσα. Ένας μέσος όρος 98% μπορεί να κρύβει μια γλώσσα στο 96% που οι πελάτες σας χρησιμοποιούν πραγματικά.
- Κάντε γράφημα της ακρίβειας ανά βεβαιότητα και μετά ξαναπαίξτε πραγματικό ιστορικό. Ένα φθηνό μοντέλο χωρίς αξιόπιστο κατώφλι είναι βάρος, και οι γραμμένες περιπτώσεις μας έφτασαν κοντά στο 100% και για τα δύο μοντέλα· οι διαφορές, αλλά και τα bugs του υπάρχοντος μοντέλου, φάνηκαν στην πραγματική κίνηση.
- Τρέξτε το σε shadow πριν κάνετε την αλλαγή. Αφήστε το νέο μοντέλο να τρέχει σιωπηλά δίπλα στο παλιό και αλλάξτε ανά εργασία, ποτέ όλα μαζί.
Αυτό δένει με κάτι ευρύτερο που έχουμε υποστηρίξει, να μην ποντάρετε το προϊόν σας σε ένα μόνο AI μοντέλο: το σωστό μοντέλο για το «αποφασίζω» συχνά δεν είναι το σωστό για το «γράφω», και μικρότερα, φθηνότερα μοντέλα καλύπτουν πλέον μεγαλύτερο μέρος της πρώτης δουλειάς απ' όσο υποθέτουν οι περισσότερες ομάδες.
FAQ
Αντικαθιστά το TypeSafe Jev το GPT ή το Gemini;
Όχι. Αντικαθιστά ένα είδος κλήσης: την επιλογή ανάμεσα σε επιλογές που ορίζετε εσείς, τη βαθμολόγηση σε κλίμακα ή την απάντηση ναι/όχι. Δεν γράφει κείμενο, δεν χρησιμοποιεί εργαλεία και δεν διαβάζει εικόνες, οπότε ένας agent που μιλά με πελάτες χρειάζεται ακόμη γλωσσικό μοντέλο για την απάντηση.
Πόσο ακριβές είναι το TypeSafe Jev σε σύγκριση με τα frontier LLM;
Στη δοκιμή μας τον Σεπτέμβριο του 2026, σε 1.357 αποφάσεις με προκαθορισμένη σωστή απάντηση, πέτυχε 98,5%, έναντι 99,0% ενός frontier μοντέλου Google Gemini. Σε πραγματικό ιστορικό συνομιλιών τα πήγε καλύτερα στο τι θα γίνει με ένα μήνυμα και χειρότερα στην επιλογή του σωστού ειδικού μέσα σε μια συνομιλία που ήδη τρέχει.
Δουλεύει το TypeSafe Jev στα Αραβικά και στα Τουρκικά;
Ναι, με μια επιφύλαξη. Τα Τουρκικά ήταν κοντά στα Αγγλικά στη δοκιμή μας (98,4% έναντι 99,1%). Τα Αραβικά έφτασαν στο 96,5%. Οι περισσότερες αστοχίες ήταν μπερδέματα διαλέκτων (Αραβικά του Κόλπου που διαβάστηκαν ως αιγυπτιακά ή λεβαντίνικα), ποτέ λάθος γλώσσα, και συνοδεύονταν από χαμηλούς δείκτες βεβαιότητας.
Μπορείτε να βασιστείτε στον δείκτη βεβαιότητας του Jev;
Στα δεδομένα μας ακολουθούσε καλά την ακρίβεια: 100% σωστό με βεβαιότητα 97% ή υψηλότερη, 73% κάτω από 60%. Ένα λάθος με υψηλή βεβαιότητα (0,95) συνέβη παρ' όλα αυτά, οπότε χρησιμοποιήστε τον δείκτη για να αποφασίζετε πότε περνάτε στο εφεδρικό μοντέλο, και συνεχίστε να ελέγχετε τα πραγματικά αποτελέσματα.
Είναι φθηνότερο και ταχύτερο από ένα LLM;
Στις δοκιμαστικές μας κλήσεις κόστισε περίπου 25 φορές λιγότερο και απάντησε σε διάμεσο χρόνο 329 ms έναντι 1.598 ms, κυρίως επειδή το Jev χρεώνει μόνο τα input tokens και επιστρέφει μια σύντομη, δομημένη απάντηση αντί για παραγόμενο κείμενο.
Θέλετε AI που ξέρει πότε δεν είναι σίγουρο;
Δοκιμάζουμε μοντέλα σαν αυτό ώστε οι agents που απαντούν στους πελάτες σας να παίρνουν σωστά τις φθηνές, γρήγορες αποφάσεις και να δίνουν τις δύσκολες σε κάτι μεγαλύτερο. Για να δείτε πώς λειτουργεί αυτό στα δικά σας DM, κλείστε ένα demo 30 λεπτών, ή δείτε πώς το χειρίζονται σήμερα οι AI agents μας για DM σε Instagram και WhatsApp.
Πηγές και μέθοδος: αξιολόγηση της Entagl, Σεπτέμβριος 2026. Γύρος 1: 283 δοκιμαστικές περιπτώσεις με σωστή απάντηση ορισμένη με το χέρι (189 τυπικές, συν 94 δύσκολες που έτρεξαν τρεις φορές: 471 εκτελέσεις), 1.357 βαθμολογημένες αποφάσεις, TypeSafe Jev (jev-1.13.0) έναντι frontier μοντέλου Google Gemini με πανομοιότυπα inputs· το κόστος συγκρίνει τα χρεωμένα tokens για πανομοιότυπες κλήσεις με τον επίσημο τιμοκατάλογο κάθε παρόχου τον Σεπτέμβριο του 2026 (το Jev χρεώνει μόνο input tokens). Γύρος 2: 402 πραγματικές αποφάσεις δρομολόγησης από δύο ανωνυμοποιημένα workspaces πελατών μέσα σε 21 ημέρες, με τα προσωπικά δεδομένα καλυμμένα πριν από την επεξεργασία· οι διαφωνίες ελέγχθηκαν έναντι των γραπτών κανόνων κάθε πελάτη, οι ασαφείς περιπτώσεις εξαιρέθηκαν και τα σπάνια αποτελέσματα υπερ-αντιπροσωπεύτηκαν στο δείγμα, οπότε τα ποσοστά δεν αποτελούν μέσο όρο παραγωγής. Ένας αξιολογητής. Στοιχεία του παρόχου: ανακοίνωση κυκλοφορίας της TypeSafe, τεκμηρίωση μοντέλων της TypeSafe, γνωστοί περιορισμοί του Jev 1.13, cookbook της TypeSafe για παράλληλες ερωτήσεις. Υπόβαθρο για τη βαθμονόμηση: Guo et al., ICML 2017.