AI News · industry
TypeSafe Jev gegen Gemini bei 1.759 Entscheidungen: 5x schneller, 25x günstiger, 98,5 % korrekt
Wir haben das neue Entscheidungsmodell von TypeSafe an 1.357 gelabelten Entscheidungen in 13 Sprachen und an 402 echten Kundenchats getestet. Es kam fast an ein Frontier-LLM heran, brauchte dafür nur einen Bruchteil von Zeit und Kosten und zeigte uns dann genau, wo es an seine Grenzen stößt.
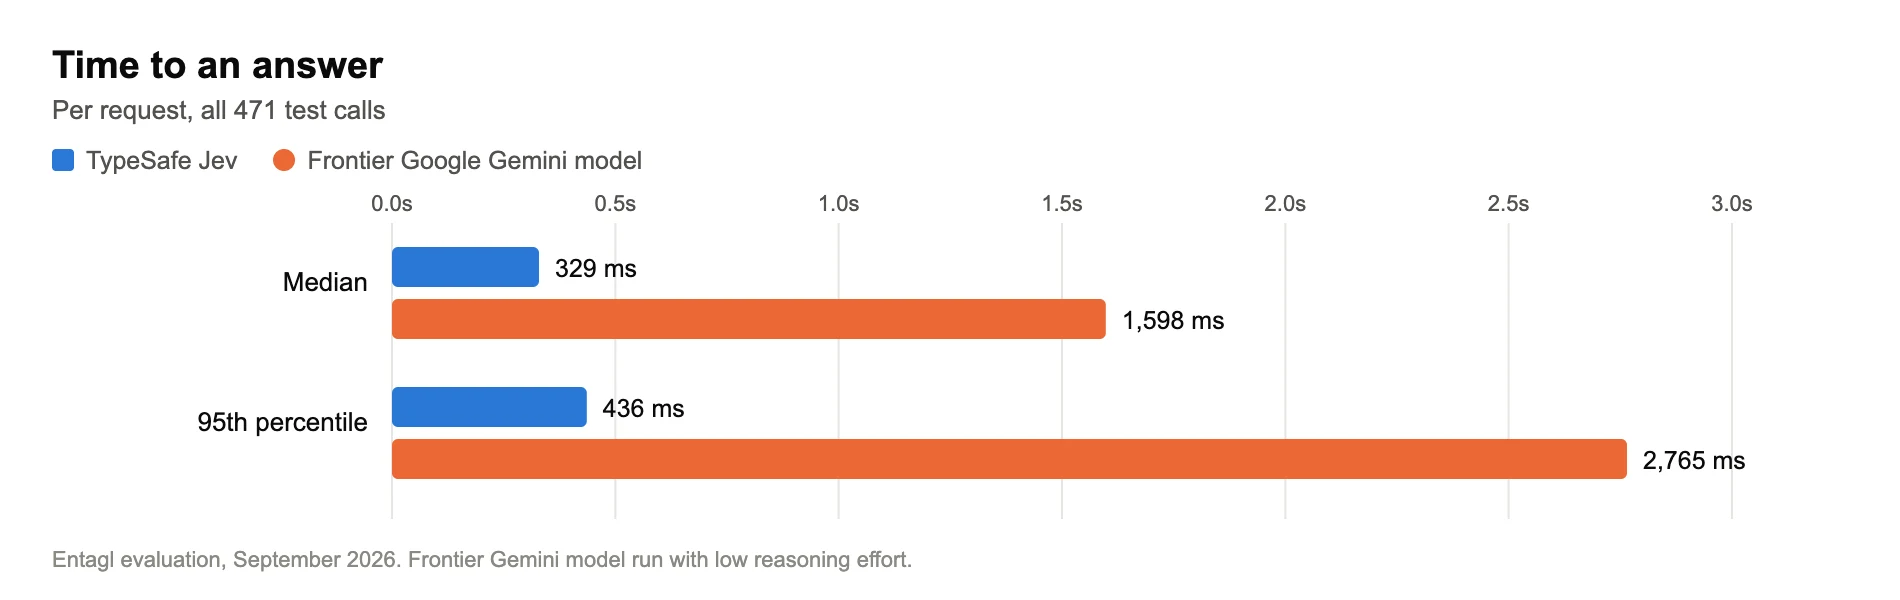
Wir haben TypeSafe Jev, dem reinen Entscheidungsmodell, das TypeSafe am 15. September vorgestellt hat, 1.759 Entscheidungen vorgelegt: 1.357 von Hand gelabelte Testentscheidungen in 13 Sprachen und 402 echte Routing-Entscheidungen aus laufenden Kundenchats. Im Vergleich mit einem Frontier-Modell von Google Gemini war Jev 5-mal schneller (Median 329 ms statt 1.598 ms), 25-mal günstiger und fast genauso treffsicher (98,5 % gegenüber 99,0 %). Wenn es sich zu 97 % oder mehr sicher war, lag es 986 von 986 Malen richtig.
Dann haben wir echten Kundenverkehr noch einmal durchlaufen lassen. Dabei versagte es auf eine Weise, die kein Testdatensatz vorhergesagt hatte. Hier finden Sie alles: die Zahlen, die Diagramme, die blinden Flecken und wo wir das Modell einsetzen würden und wo nicht.
Was ist TypeSafe Jev, und was unterscheidet es von einem LLM?
TypeSafe hat Jev am 15. September 2026 angekündigt, als erstes „System One“-Modell. Der Name ist an Daniel Kahnemans schnelles, intuitives System-1-Denken angelehnt. Sie bitten Jev nicht um Fließtext. Sie übergeben die Fakten (eine Nachricht, einen kurzen Verlauf, eine Liste von Optionen) und typisierte Fragen, und das Modell liefert eine von drei Antwortarten:
| Fragetyp | Was Sie fragen | Was zurückkommt |
|---|---|---|
| Ja/Nein | „Bittet uns diese Nachricht, keinen Kontakt mehr aufzunehmen?“ | Eine Wahrscheinlichkeit, z. B. 0,97 |
| Eine Option wählen | „Welches dieser vier Teams soll antworten?“ | Die Auswahl, eine Wahrscheinlichkeit für jede Option und ein Konfidenzwert |
| Bewertung | „Wie frustriert ist dieser Kunde auf einer 5-stufigen Skala?“ | Eine Position auf der Skala plus die Streuung |
Antworten formulieren, Tools aufrufen oder Bilder lesen kann Jev nicht. TypeSafe trainiert das Modell mit einem Verfahren, das das Unternehmen Reinforcement Learning für kalibrierte Entscheidungen nennt. Das Ziel: „90 % sicher“ soll tatsächlich bedeuten, dass das Modell in etwa 9 von 10 Fällen richtig liegt. Genau darin sind gewöhnliche Sprachmodelle schwach. Eine vielzitierte Studie aus dem Jahr 2017 zeigte, dass moderne neuronale Netze meist zu selbstsicher sind (Guo et al., „On Calibration of Modern Neural Networks“, ICML 2017). Auch das Preismodell ist ungewöhnlich: TypeSafe berechnet nur Input-Tokens, der Output ist kostenlos.
Kann ein spezialisiertes, günstiges Entscheidungsmodell die „Entscheiden“-Schritte von einem Frontier-LLM übernehmen, ohne dass mehr Fehler passieren? Hier sind unsere Daten.
Wie haben wir getestet?
In zwei Runden, mit denselben Fragen für jedes Modell.
Runde 1: ein gelabelter Testdatensatz. Wir haben 283 realistische Fälle für 13 Entscheidungsaufgaben geschrieben und für jeden Fall die richtige Antwort festgelegt, bevor irgendetwas lief: 189 Standardfälle und 94 schwierigere. Die schwierigen Fälle liefen jeweils dreimal, um zu prüfen, ob die Antworten stabil bleiben. Das ergab 471 Testläufe und 1.357 bewertete Entscheidungen. Die Sprachen: Englisch, Türkisch, vier arabische Varietäten, Arabisch in lateinischer Schrift und 10 weitere. Zu den Aufgaben gehörten das Weiterleiten einer Nachricht an den richtigen Spezialisten, das Erkennen von Prompt-Injection-Text, das Auswerten eines Telefonat-Transkripts auf sein Ergebnis und das Markieren einer Antwort, die einen Preis nennt, den das Unternehmen nie festgelegt hat. Jev und ein Frontier-Modell von Google Gemini (mit niedrigem Reasoning-Aufwand) erhielten identische Fakten, Fragen und Optionen.
Runde 2: echte Historie erneut abspielen. Wir haben 402 echte Routing-Entscheidungen genommen, die unser Produkt über 21 Tage für zwei Kunden-Workspaces bereits getroffen hatte, dieselben Unterhaltungen erneut durch Jev geschickt und die Ergebnisse verglichen. Workspace A ist ein Dienstleistungsunternehmen für professionelle Beratung im Nahen Osten, überwiegend auf Arabisch über WhatsApp. Workspace B ist ein Support-Dienst im Gesundheitswesen, überwiegend auf Englisch und Portugiesisch im Web-Chat. Die ursprünglichen Entscheidungen stammten von Frontier-Modellen von Google Gemini und OpenAI GPT. Namen, Telefonnummern, E-Mail-Adressen und Links wurden maskiert, bevor Text unsere Systeme verließ. Wo Jev und die ursprüngliche Entscheidung voneinander abwichen, haben wir die Unterhaltung gelesen und beurteilt, welche Antwort den schriftlich festgelegten Regeln des Kunden entsprach. Fälle, die sich mit diesen Regeln nicht eindeutig klären ließen, blieben außen vor.
Wie genau war Jev beim gelabelten Test?
Etwa so genau wie das Frontier-Modell: 98,5 % gegenüber 99,0 % bei 1.357 bewerteten Entscheidungen, und dabei rund fünfmal schneller.
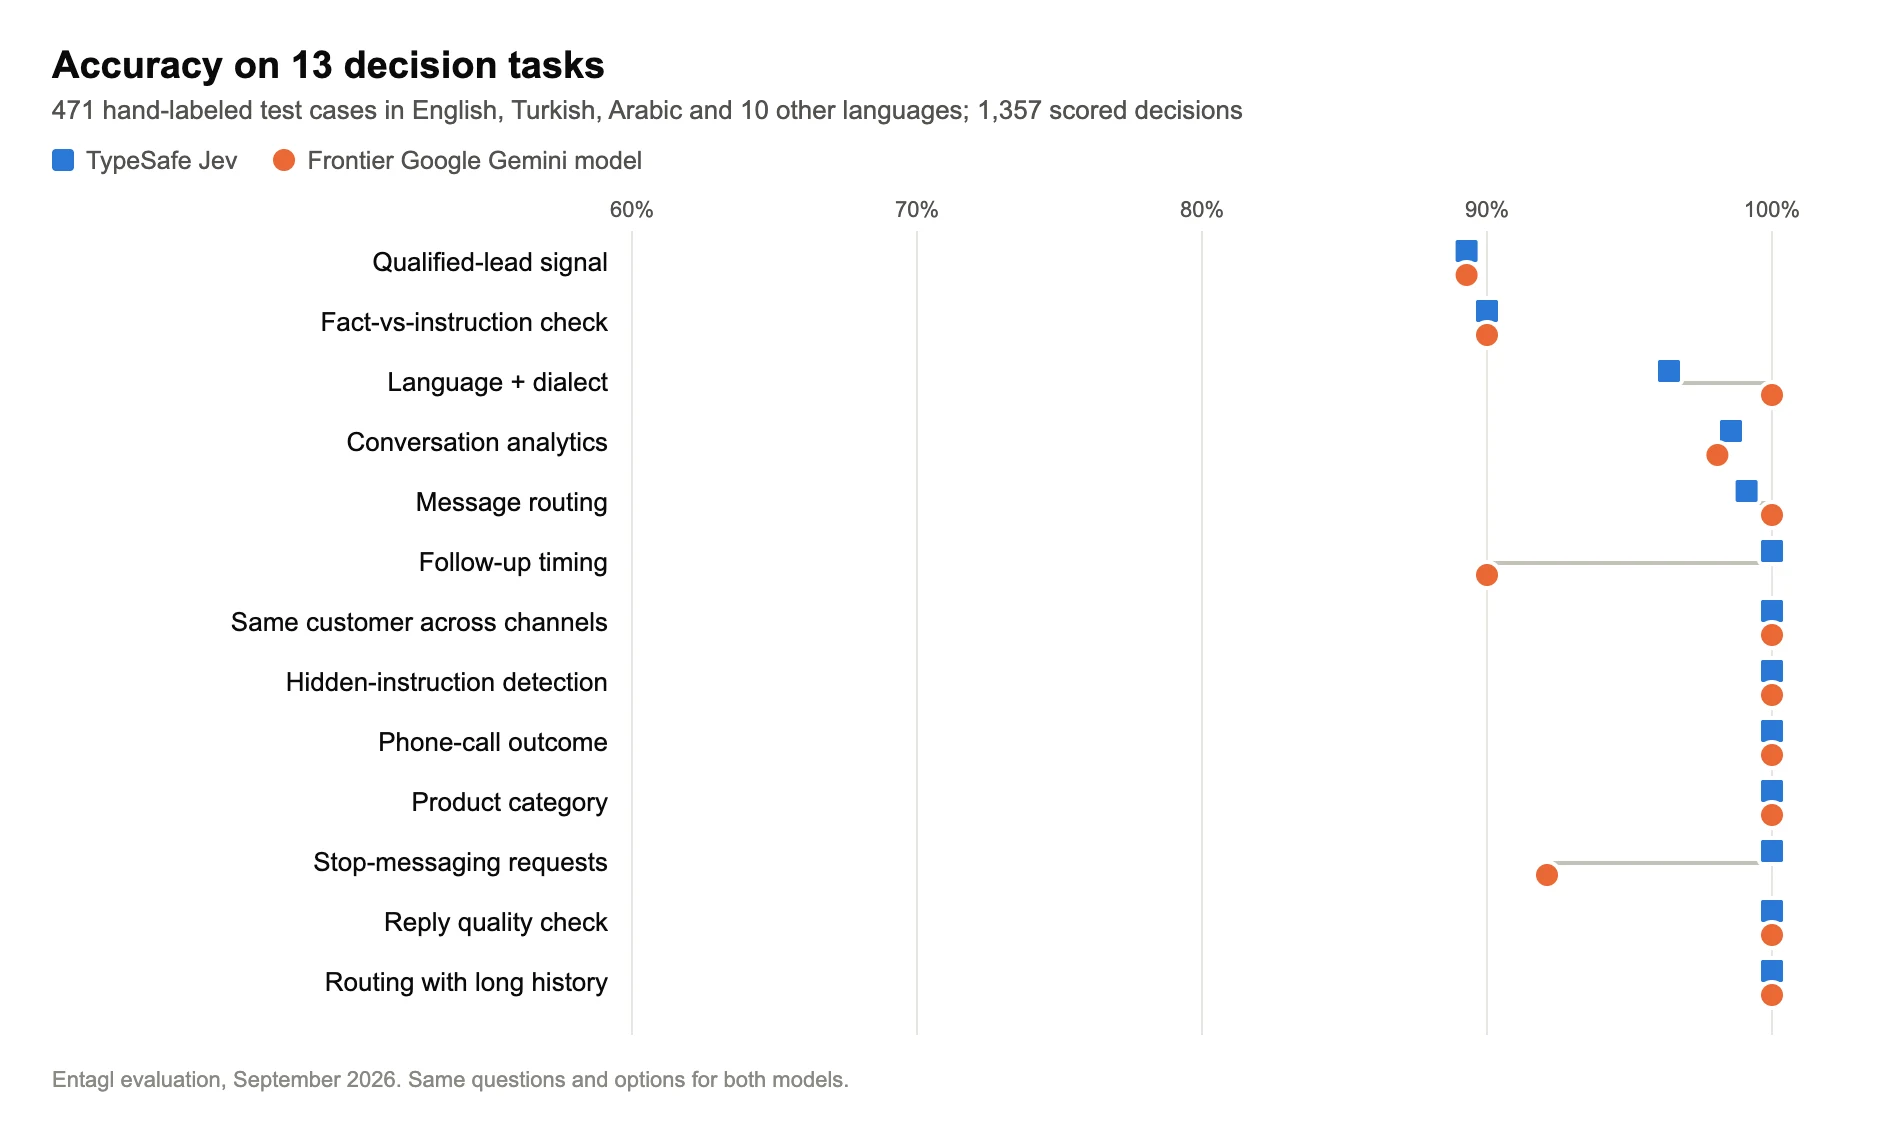
Die Unterschiede sind klein und gehen in beide Richtungen. Jev erkannte, dass „Ich habe kein Interesse mehr“ keine Abmeldung ist; Gemini markierte die Nachricht als solche. Gemini wertete außerdem „Unser Team ruft Sie an“ als Verweis des Kunden aufs Telefon und stufte „etwas teuer, vielleicht später“ als keinen Follow-up wert ein. Genau diesen Lead wollen Sie aber noch einmal anstoßen.
Jevs Schwachstelle waren arabische Dialekte. Dass der Text arabisch war, erkannte es immer. Zwei Nachrichten im Golf-Arabisch las es jedoch in jedem Durchlauf als ägyptisch oder levantinisch (insgesamt sechs Fehler). Und beide Modelle stuften „Wie viel? 😍“ als qualifizierten Lead ein, obwohl unsere Regel Preis plus Zeitpunkt oder Kontaktdaten verlangte. Das Problem lag hier bei der Regel, nicht bei den Modellen.
Kann man dem Konfidenzwert trauen?
In diesem Test: ja. Er ist das Nützlichste, was Jev zu bieten hat.
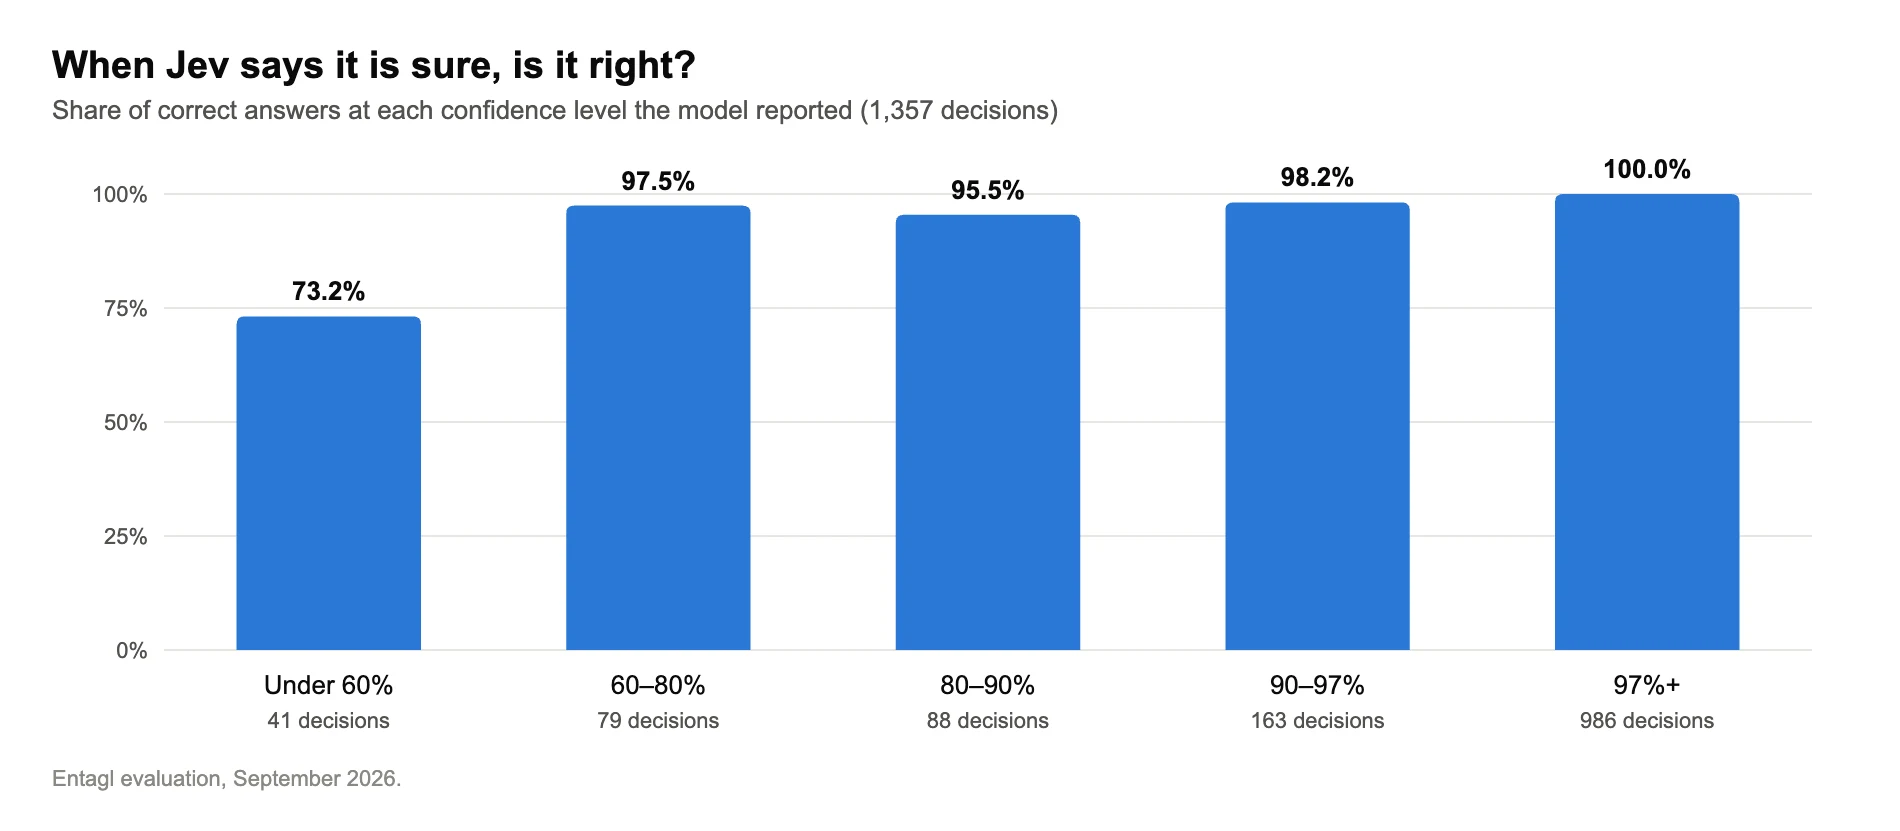
Legen Sie eine einfache Regel fest: „Jevs Antwort nur verwenden, wenn es sich zu mindestens 85 % sicher ist, sonst das größere Modell fragen.“ Dann übernimmt Jev 88 % der Entscheidungen mit einer Genauigkeit von 99,75 %, und 17 seiner 20 Fehler landen beim Backup. Jeder Fehler bei arabischen Dialekten kam mit einer Konfidenz von 0,36 bis 0,40, die Regel fing sie also alle ab.
Ein Fehler rutschte trotz hoher Konfidenz durch. Eine türkische Werbeagentur schrieb „Wir würden gern mit Ihnen zusammenarbeiten.“ Jev las das als Bewerbung, mit 0,95, in allen drei Durchläufen. Im Kontext richtete das keinen Schaden an (Jev markierte die Nachricht auch als Verkaufsanfrage, und diese Entscheidung hat Vorrang). Als Warnung taugt der Fall trotzdem: Ein Konfidenzwert ist ein Indiz, keine Freigabe. Auch nach dem Umstellen brauchen Sie weiterhin gelabelte Prüfungen und eine Kontrolle der tatsächlichen Ergebnisse.
Was passierte, als wir echte Unterhaltungen erneut abspielten?
Die reine Übereinstimmung mit den ursprünglichen Entscheidungen lag nur bei 74–84 %. Der größte Teil dieser Lücke ging aber nicht auf Fehler von Jev zurück.
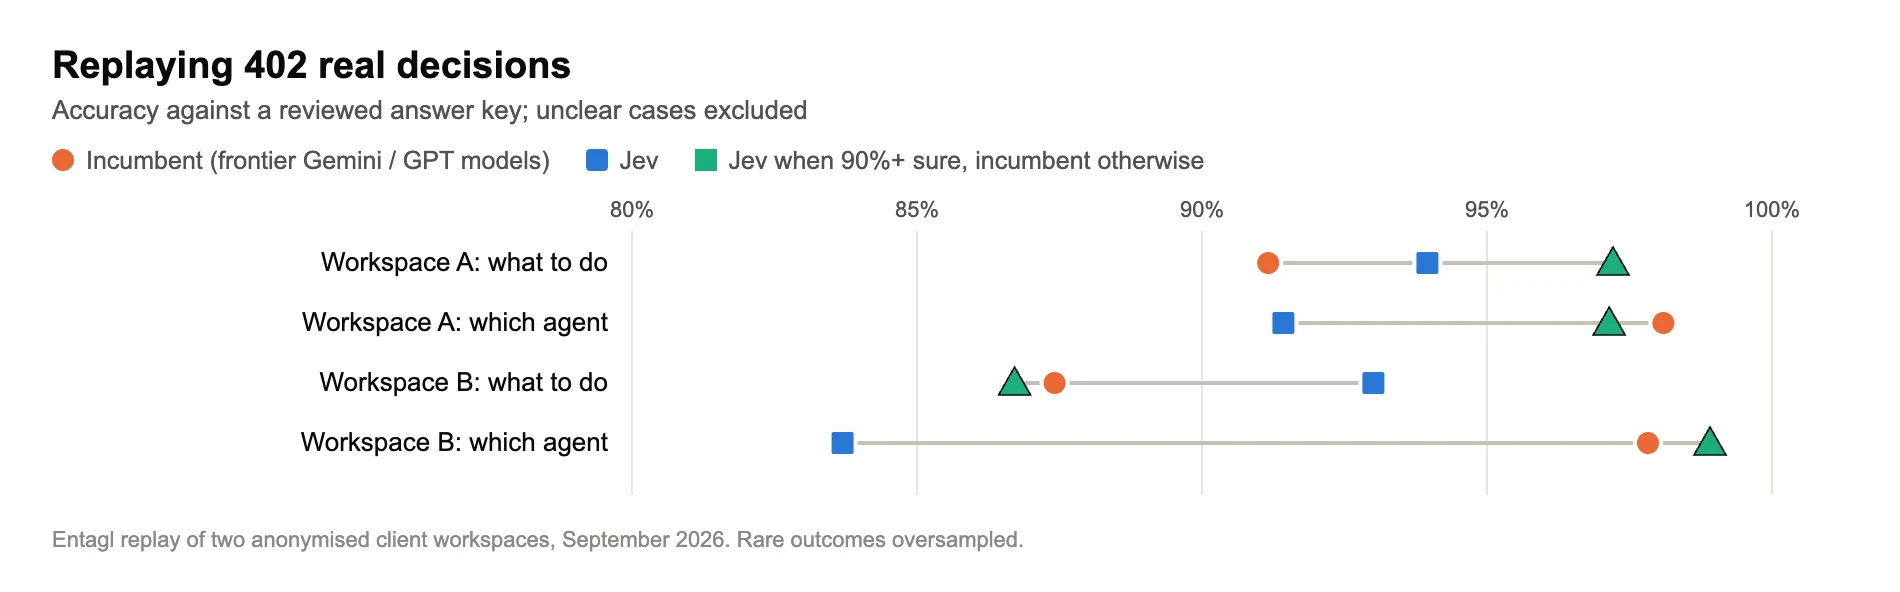
Bewertet anhand des geprüften Antwortschlüssels:
| Entscheidung | Original (Frontier-Modell von Gemini / GPT) | Jev | Jev bei 90 %+ Sicherheit, sonst Original |
|---|---|---|---|
| Workspace A: Was mit der Nachricht geschehen soll | 91,2 % | 94,0 % | 97,2 % |
| Workspace A: Welcher Spezialist antwortet | 98,1 % | 91,4 % | 97,1 % |
| Workspace B: Was mit der Nachricht geschehen soll | 87,4 % | 93,0 % | 86,7 % |
| Workspace B: Welcher Spezialist antwortet | 97,8 % | 83,7 % | 98,9 % |
Eine Auffälligkeit: In Workspace B verschlechterte die Schwelle die Nachrichten-Entscheidung leicht (86,7 %). Bei genau den Nachrichten, bei denen Jev unsicher war, bedeutete der Rückgriff auf das Original, dessen schwächste Antworten zu übernehmen.
Die Entscheidung, was mit einer Nachricht geschehen soll (antworten, ignorieren, übergeben, eine vorgefertigte Antwort senden), ging in beiden Workspaces an Jev. Bei der Wahl des Spezialisten war es umgekehrt, und der Grund ist konkret. Die meisten Fehler betrafen Folgenachrichten wie „India“ oder „Ich bespreche das morgen“ in einer Unterhaltung, die bereits mit einem bestimmten Spezialisten lief. Laut den Regeln des Kunden bleibt die Unterhaltung dann bei diesem Spezialisten. Jev sah die letzten acht Nachrichten, erfuhr aber nicht, wem der Chat gehörte, und riet deshalb anhand der Wörter. Das ursprüngliche Setup kannte diesen Kontext und nutzte ihn.
Das erneute Abspielen deckte auch Fehler in den ursprünglichen Entscheidungen auf, und zwar solche, die bei Stichproben durchrutschen:
- Eine Keyword-Regel, die die Falschen traf. Eine vorgefertigte Antwort mit Verweis an eine andere Stelle ging immer dann raus, wenn jemand das Wort „legal“ oder „lawyer“ verwendete. In einer Stichprobe von 20 Fällen waren 15 ganz normale geschäftliche Fragen wie „Welche rechtlichen Dokumente brauche ich dafür?“. Jev leitete sie zu einer echten Antwort weiter.
- Wiederholte Übergaben. Nachdem ein Kunde Namen und Nummer einmal genannt hatte, lösten spätere Nachrichten wie „thanks“ oder „obrigada“ jedes Mal eine neue Übergabe an das Team aus. 17 der 41 Übergaben in unserer Stichprobe waren solche Wiederholungen.
- Zwei Regeln, die sich widersprachen, sodass beide Modelle bei denselben Nachrichten raten mussten.
Wir haben diese Punkte zur Behebung an der Quelle gemeldet. Vor Keyword-Regeln wie der ersten warnt ausdrücklich unser Leitfaden gegen KI-Halluzinationen.
Wo stößt Jev an Grenzen?
Ohne Beschönigung:
- Feinheiten jenseits des Englischen. TypeSafes eigene Dokumentation nennt Englisch als primäre Trainingssprache; andere Sprachen würden „unterstützt, aber nicht gleich gut“. Das haben wir gesehen: 99,1 % auf Englisch, 98,4 % auf Türkisch, 96,5 % auf Arabisch. Sechs der neun arabischen Fehler waren Dialektverwechslungen; die übrigen drei gingen auf eine einzelne Grenzfall-Nachricht („Ist das eine Beschwerde?“) und ein Label zurück, über das wir selbst streiten würden.
- Fehlender Kontext, den es nicht ableiten kann. Wem die Unterhaltung gehört, ob Kontaktdaten bereits erfasst wurden: Beim erneuten Abspielen echter Daten verlor Jev immer dann Punkte, wenn die Antwort von einer Tatsache abhing, die nicht im übermittelten Text stand. Die Lösung besteht darin, diese Fakten im Code zu berechnen und mitzugeben, statt auf einen Treffer des Modells zu hoffen.
- Vorausgefüllter Anzeigentext. Viele WhatsApp-Chats aus Click-to-Message-Anzeigen beginnen mit einer Vorlagenzeile wie „Ich möchte mehr über Ihre Leistungen erfahren.“ Jev stützte sich auf diese Zeile und ließ mehrere echte Jobsuchende und Spendenanfragen als Geschäftsleads durch, eine davon mit 0,92 Konfidenz. Entfernen Sie die Vorlage vorher.
- Dinge, für die es nie gebaut wurde. TypeSafe listet selbst die „Jagged Edges“ des Modells auf: Arithmetik, Zählen, Datumsvergleiche, lange Eingaben voller irrelevanter Details und Text, der das Modell gezielt manipulieren soll. Rechnen und Datumslogik gehören in den Code.
- Es ist brandneu. Vorgestellt im September 2026, mit Rate Limits, die sich laut Anbieter noch ändern können. Alles, was darauf aufbaut, braucht einen Fallback.
Wo würden wir ein Entscheidungsmodell wie Jev einsetzen?
Überall dort, wo ein LLM aus einer Liste wählen soll und niemand den Output liest:
- Erstes Routing und Vorsortieren, mit einer Konfidenzschwelle und einem größeren Modell dahinter.
- Tägliche Gesprächsanalysen (Kategorie, Stimmung, „hat nach dem Preis gefragt“) für jede Unterhaltung statt nur für eine Stichprobe.
- Dauerhaft aktive Sicherheitsprüfungen: Abmeldewünsche in jeder Sprache oder Text, der dem Assistenten Anweisungen unterschieben will (siehe unseren Leitfaden zu Prompt Injection).
- Gesprächsergebnisse als Daten, direkt aus dem Transkript ausgelesen.
Bündeln Sie außerdem Ihre Fragen: TypeSafes eigener Test mit einem langen Dokument ergab, dass 13 Fragen in einem Aufruf statt in 13 Aufrufen 12,2-mal günstiger und 10-mal schneller waren, bei identischen Antworten.
Und wo wir es nicht einsetzen würden: beim Formulieren von Antworten, bei allem mit Zahlen und überall dort, wo eine selbstsicher falsche Antwort einen echten Kunden zum Schweigen bringt. Eine Nachricht komplett zu blockieren, sollte eine sehr hohe Konfidenz oder eine zweite Meinung voraussetzen.
Wie sollten Sie ein Entscheidungsmodell selbst bewerten?
Was bei uns funktioniert hat:
- Erst labeln, dann testen. „Stimmt mit dem aktuellen Modell überein“ ist nicht dasselbe wie „korrekt“. Unser Replay hat gezeigt, dass das bestehende Modell oft genug danebenlag, um ins Gewicht zu fallen.
- Nach Sprache aufschlüsseln. Ein Durchschnitt von 98 % kann eine Sprache mit 96 % verdecken, die Ihre Kunden tatsächlich verwenden.
- Genauigkeit nach Konfidenz auftragen, dann echte Historie abspielen. Ein günstiges Modell ohne verlässliche Schwelle ist ein Risiko. Unsere selbst geschriebenen Fälle erreichten bei beiden Modellen fast 100 %; erst im echten Verkehr zeigten sich die Unterschiede und die eigenen Fehler des bestehenden Modells.
- Erst im Schattenbetrieb, dann umstellen. Lassen Sie das neue Modell unbemerkt neben dem alten laufen und stellen Sie Aufgabe für Aufgabe um, nie alles auf einmal.
Das passt zu einem Punkt, den wir schon an anderer Stelle gemacht haben: Setzen Sie Ihr Produkt nicht auf ein einziges KI-Modell. Das richtige Modell zum „Entscheiden“ ist oft nicht das richtige zum „Schreiben“, und kleinere, günstigere Modelle übernehmen inzwischen mehr von der ersten Aufgabe, als die meisten Teams annehmen.
FAQ
Ersetzt TypeSafe Jev GPT oder Gemini?
Nein. Es ersetzt eine bestimmte Art von Aufruf: die Wahl aus Optionen, die Sie festlegen, eine Bewertung auf einer Skala oder eine Ja/Nein-Antwort. Texte schreiben, Tools nutzen oder Bilder lesen kann es nicht. Ein Agent mit Kundenkontakt braucht für die Antwort also weiterhin ein Sprachmodell.
Wie genau ist TypeSafe Jev im Vergleich zu Frontier-LLMs?
In unserem Test vom September 2026 mit 1.357 gelabelten Entscheidungen erreichte es 98,5 %, ein Frontier-Modell von Google Gemini 99,0 %. Bei echter Gesprächshistorie war es besser bei der Frage, was mit einer Nachricht geschehen soll, und schlechter bei der Wahl des richtigen Spezialisten mitten in einer Unterhaltung.
Funktioniert TypeSafe Jev auf Arabisch und Türkisch?
Ja, mit einer Einschränkung. Türkisch lag in unserem Test nah am Englischen (98,4 % gegenüber 99,1 %). Arabisch kam auf 96,5 %. Die meisten Fehler waren Dialektverwechslungen (Golf-Arabisch als ägyptisch oder levantinisch gelesen), nie eine falsche Sprache, und sie kamen mit niedrigen Konfidenzwerten.
Kann man sich auf Jevs Konfidenzwert verlassen?
In unseren Daten bildete er die Genauigkeit gut ab: 100 % richtig bei 97 % Konfidenz oder mehr, 73 % bei weniger als 60 %. Ein selbstsicherer Fehler (0,95) kam trotzdem vor. Nutzen Sie den Wert also, um zu entscheiden, wann ein Fallback greift, und prüfen Sie weiterhin die echten Ergebnisse.
Ist es günstiger und schneller als ein LLM?
Bei unseren Testaufrufen kostete es etwa 25-mal weniger und antwortete im Median in 329 ms statt 1.598 ms. Das liegt vor allem daran, dass Jev nur Input-Tokens berechnet und eine kurze typisierte Antwort liefert statt generierten Text.
Sie wollen KI, die weiß, wann sie unsicher ist?
Wir testen Modelle wie dieses, damit die Agenten, die Ihren Kunden antworten, die günstigen, schnellen Entscheidungen richtig treffen und die schwierigen an etwas Größeres abgeben. Wie das mit Ihren eigenen DMs funktioniert, zeigen wir Ihnen gern in einer 30-minütigen Demo. Oder sehen Sie sich an, wie unsere KI-Agenten für Instagram- und WhatsApp-DMs das heute schon lösen.
Quellen und Methode: Entagl-Evaluierung, September 2026. Runde 1: 283 von Hand gelabelte Testfälle (189 Standardfälle plus 94 schwierige Fälle mit je drei Durchläufen: 471 Testläufe), 1.357 bewertete Entscheidungen, TypeSafe Jev (jev-1.13.0) gegen ein Frontier-Modell von Google Gemini mit identischen Eingaben; der Kostenvergleich stellt die abgerechneten Tokens identischer Aufrufe zum Listenpreis des jeweiligen Anbieters (Stand September 2026) gegenüber (Jev berechnet nur Input-Tokens). Runde 2: 402 echte Routing-Entscheidungen aus zwei anonymisierten Kunden-Workspaces über 21 Tage, personenbezogene Daten vor der Verarbeitung maskiert; Abweichungen anhand der schriftlichen Regeln des jeweiligen Kunden geprüft, unklare Fälle ausgeschlossen, seltene Ergebnisse überrepräsentiert, daher sind die Prozentwerte kein Produktionsdurchschnitt. Ein Prüfer. Angaben des Anbieters: TypeSafe-Launch-Beitrag, TypeSafe-Modelldokumentation, Bekannte Einschränkungen von Jev 1.13, TypeSafe-Cookbook zu parallelen Fragen. Hintergrund zur Kalibrierung: Guo et al., ICML 2017.