AI News · industry
TypeSafe Jev مقابل Gemini في 1,759 قرارًا: أسرع 5 مرات، وأرخص 25 مرة، ودقة 98.5%
اختبرنا نموذج القرارات الجديد من TypeSafe على 1,357 قرارًا مُصنّفًا بـ13 لغة و402 محادثة حقيقية مع عملاء. اقترب كثيرًا من نموذج لغوي متقدّم بجزء بسيط من الوقت والتكلفة، ثم كشف لنا بالضبط أين ينكسر.
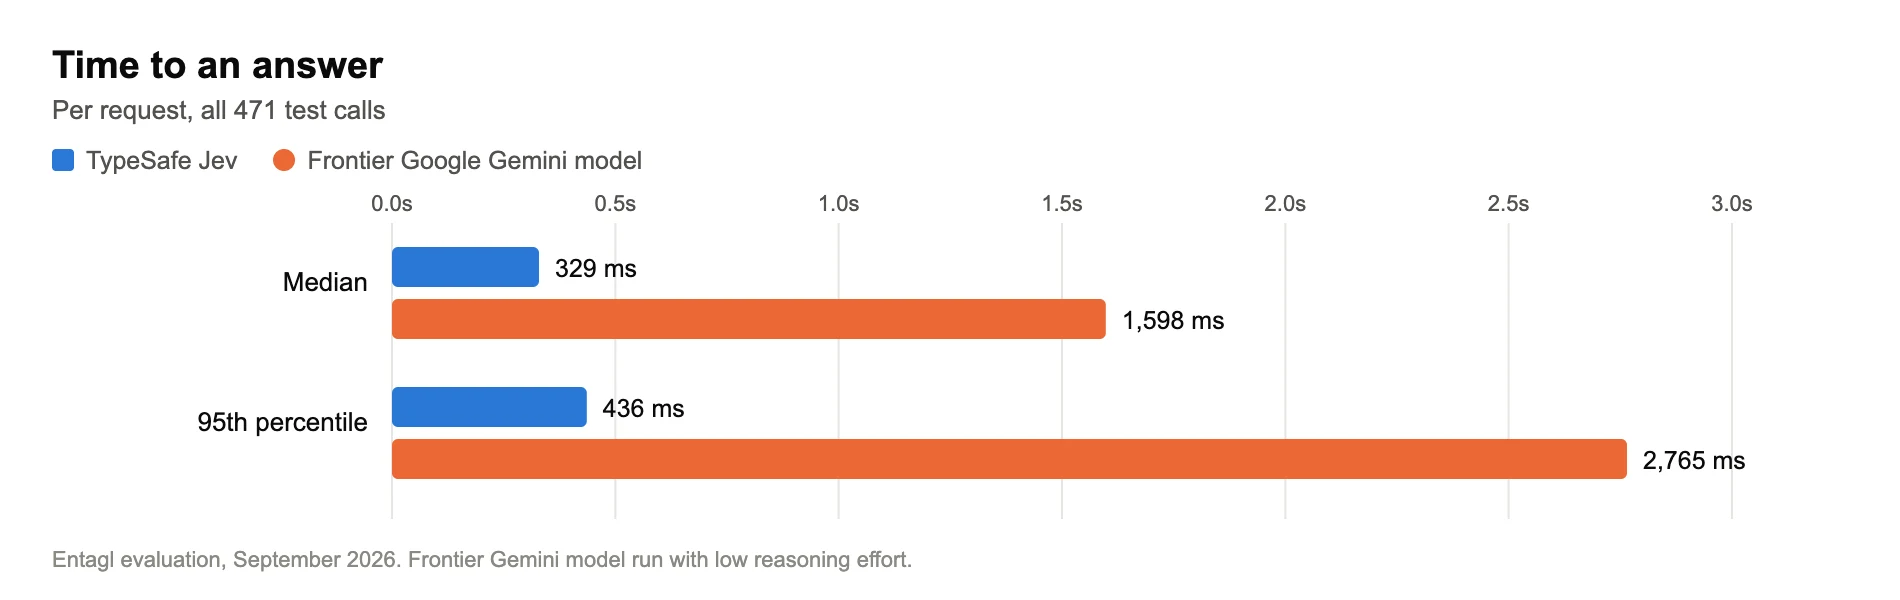
أعطينا TypeSafe Jev، نموذج القرارات الذي أطلقته TypeSafe في 15 سبتمبر، 1,759 قرارًا ليحسمها: 1,357 قرارًا اختباريًا صنّفناها يدويًا بـ13 لغة، و402 قرار توجيه حقيقي من محادثات عملاء فعلية. وفي مواجهة نموذج Google Gemini متقدّم، جاء أسرع 5 مرات (وسيط 329 ms مقابل 1,598 ms)، وأرخص 25 مرة، وبدقة تكاد تطابقه تمامًا (98.5% مقابل 99.0%). وحين قال إنه واثق بنسبة 97% أو أكثر، أصاب في 986 مرة من أصل 986.
بعدها أعدنا تشغيل حركة عملاء حقيقية، فتعثّر بطرق لم يتنبأ بها أي اختبار. إليك الصورة كاملة: الأرقام، والرسوم البيانية، ونقاط العمى، وأين نستخدمه وأين لا نقترب منه.
ما هو TypeSafe Jev، وبماذا يختلف عن النموذج اللغوي الكبير؟
أعلنت TypeSafe عن Jev في 15 سبتمبر 2026 بوصفه أول نموذج من فئة "System One"، وهو اسم مستعار من مفهوم "النظام 1" لدى Daniel Kahneman (دانيال كانمان)، أي التفكير السريع الحدسي. لا تطلب منه نصًا مكتوبًا. ترسل إليه الوقائع (رسالة، وسجلًا قصيرًا، وقائمة خيارات) مع أسئلة محددة النوع، فيعيد إليك واحدًا من ثلاثة أنواع من الإجابات:
| نوع السؤال | ما الذي تسأله | ما الذي يعود إليك |
|---|---|---|
| نعم/لا | "هل تطلب هذه الرسالة منا التوقف عن التواصل معهم؟" | احتمال، مثل 0.97 |
| اختيار واحد | "أيّ من هذه الفرق الأربعة ينبغي أن يرد؟" | الخيار المختار، واحتمال لكل خيار، ودرجة ثقة |
| تقييم | "ما مدى انزعاج هذا العميل على مقياس من 5 درجات؟" | موقع على المقياس مع مدى التشتت |
لا يستطيع كتابة الردود، ولا استدعاء الأدوات، ولا قراءة الصور. تدرّبه TypeSafe بما تسمّيه التعلم المعزّز للقرارات المعايَرة. والهدف أن تعني عبارة "واثق بنسبة 90%" فعلًا أنه يصيب نحو 9 مرات من كل 10، وهذا ما تُخفق فيه النماذج اللغوية المعتادة. فقد وجدت دراسة معروفة صدرت عام 2017 أن الشبكات العصبية الحديثة تميل إلى الثقة المفرطة (Guo et al., "On Calibration of Modern Neural Networks," ICML 2017). والتسعير أيضًا غير مألوف: تحتسب TypeSafe رموز الإدخال فقط، أما المخرجات فمجانية.
هل يستطيع نموذج قرارات ضيّق النطاق ورخيص أن يتولى خطوات "اتخاذ القرار" بدلًا من نموذج لغوي متقدّم دون أن تزيد الأخطاء؟ إليك بياناتنا.
كيف اختبرناه؟
جولتان، والأسئلة نفسها لكل نموذج.
الجولة 1: مجموعة اختبار مُصنّفة. كتبنا 283 حالة واقعية موزعة على 13 مهمة قرار، وحددنا الإجابة الصحيحة لكل منها قبل تشغيل أي شيء: 189 حالة عادية و94 حالة أصعب. شغّلنا الحالات الصعبة ثلاث مرات للتحقق من ثبات الإجابات، فصار المجموع 471 تشغيلًا و1,357 قرارًا مُقيّمًا. اللغات: الإنجليزية، والتركية، وأربعة أنماط من العربية، والعربية المكتوبة بحروف لاتينية، و10 لغات أخرى. وشملت المهام توجيه الرسالة إلى المختص المناسب، ورصد نصوص حقن الأوامر (prompt injection)، وقراءة نص مكالمة هاتفية لمعرفة نتيجتها، والتنبيه إلى ردّ يذكر سعرًا لم يحدده النشاط التجاري قط. وتلقّى كلٌّ من Jev ونموذج Google Gemini المتقدّم (بمستوى تفكير منخفض) الوقائع والأسئلة والخيارات نفسها تمامًا.
الجولة 2: إعادة تشغيل سجل حقيقي. أخذنا 402 قرار توجيه حقيقي اتخذه منتجنا بالفعل لمساحتي عمل تابعتين لعميلين خلال 21 يومًا، وأعدنا تمرير المحادثات نفسها عبر Jev، ثم قارنّا. مساحة العمل A شركة خدمات مهنية في الشرق الأوسط، ومعظم محادثاتها بالعربية عبر WhatsApp. ومساحة العمل B خدمة دعم في القطاع الصحي، ومعظم محادثاتها بالإنجليزية والبرتغالية عبر دردشة الموقع. جاءت قراراتهما الأصلية من نماذج Google Gemini وOpenAI GPT متقدّمة. وقبل أن يغادر أي نص أنظمتنا، أخفينا الأسماء وأرقام الهواتف وعناوين البريد الإلكتروني والروابط. وحيثما اختلف Jev مع القرار الأصلي، قرأنا المحادثة وحكمنا أيّ الإجابتين توافق القواعد المكتوبة لدى العميل نفسه. أما الحالات التي لم تحسمها القواعد فاستبعدناها.
ما مدى دقة Jev في الاختبار المُصنّف؟
دقته تقارب دقة النموذج المتقدّم: 98.5% مقابل 99.0% على 1,357 قرارًا مُقيّمًا، وسرعته نحو خمسة أضعاف.
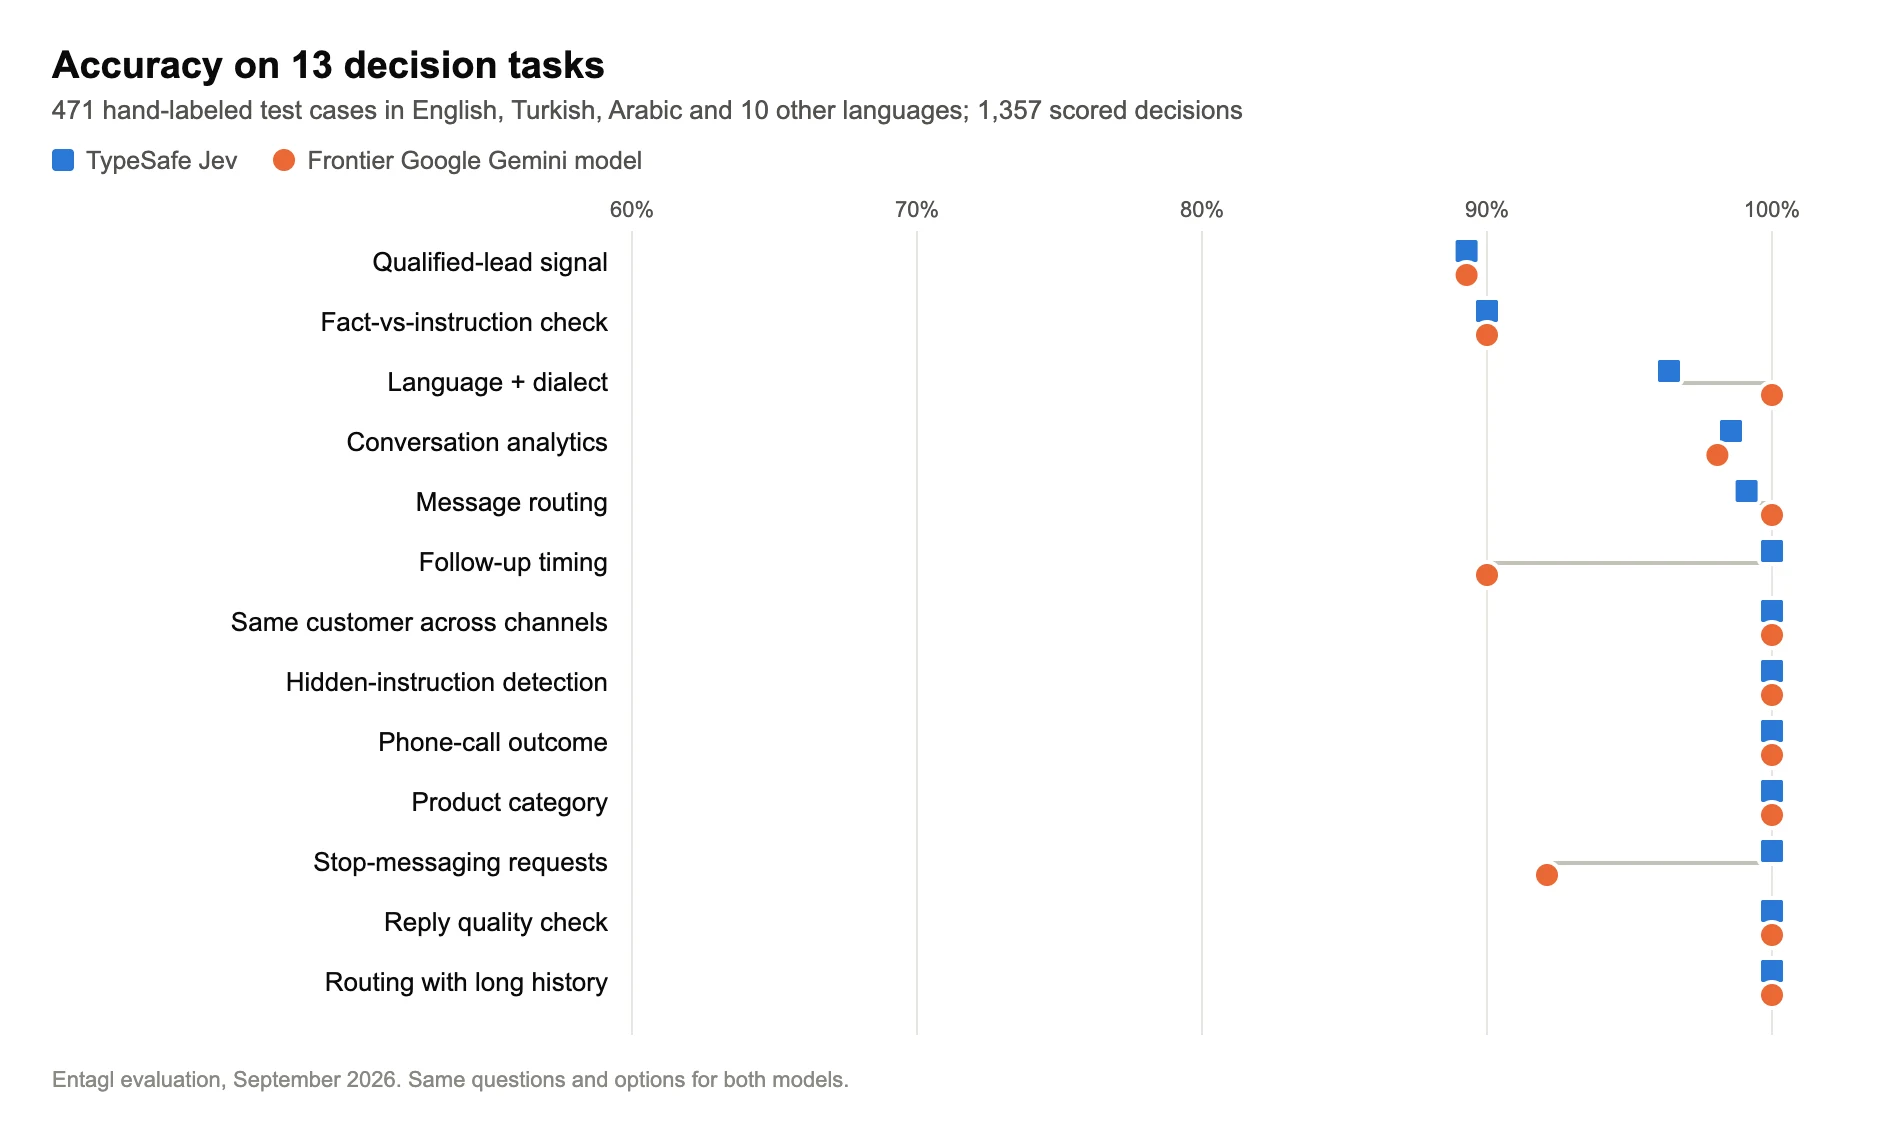
الفروق صغيرة وتميل في الاتجاهين. عرف Jev أن عبارة "لم أعد مهتمًا" ليست طلبًا لإلغاء الاشتراك، بينما صنّفها Gemini كذلك. كما عدّ Gemini عبارة "سيتصل بك فريقنا" تحويلًا للعميل إلى الهاتف، ورأى أن "السعر مرتفع قليلًا، ربما لاحقًا" لا تستحق المتابعة، مع أنها تمامًا العميل المحتمل الذي تريد أن تدفعه خطوة إلى الأمام.
نقطة ضعف Jev كانت اللهجات العربية. كان يعرف دائمًا أن النص عربي، لكن رسالتين بلهجة خليجية قُرئتا على أنهما مصرية أو شامية في كل تشغيل (ستة أخطاء إجمالًا). وصنّف النموذجان كلاهما رسالة "كم السعر؟ 😍" على أنها عميل مؤهَّل، في حين كانت قاعدتنا تشترط السعر مع التوقيت أو بيانات التواصل. المشكلة هنا كانت في القاعدة، لا في النموذجين.
هل يمكنك الوثوق بدرجة الثقة؟
في هذا الاختبار، نعم. وهي أثمن ما يقدمه Jev.
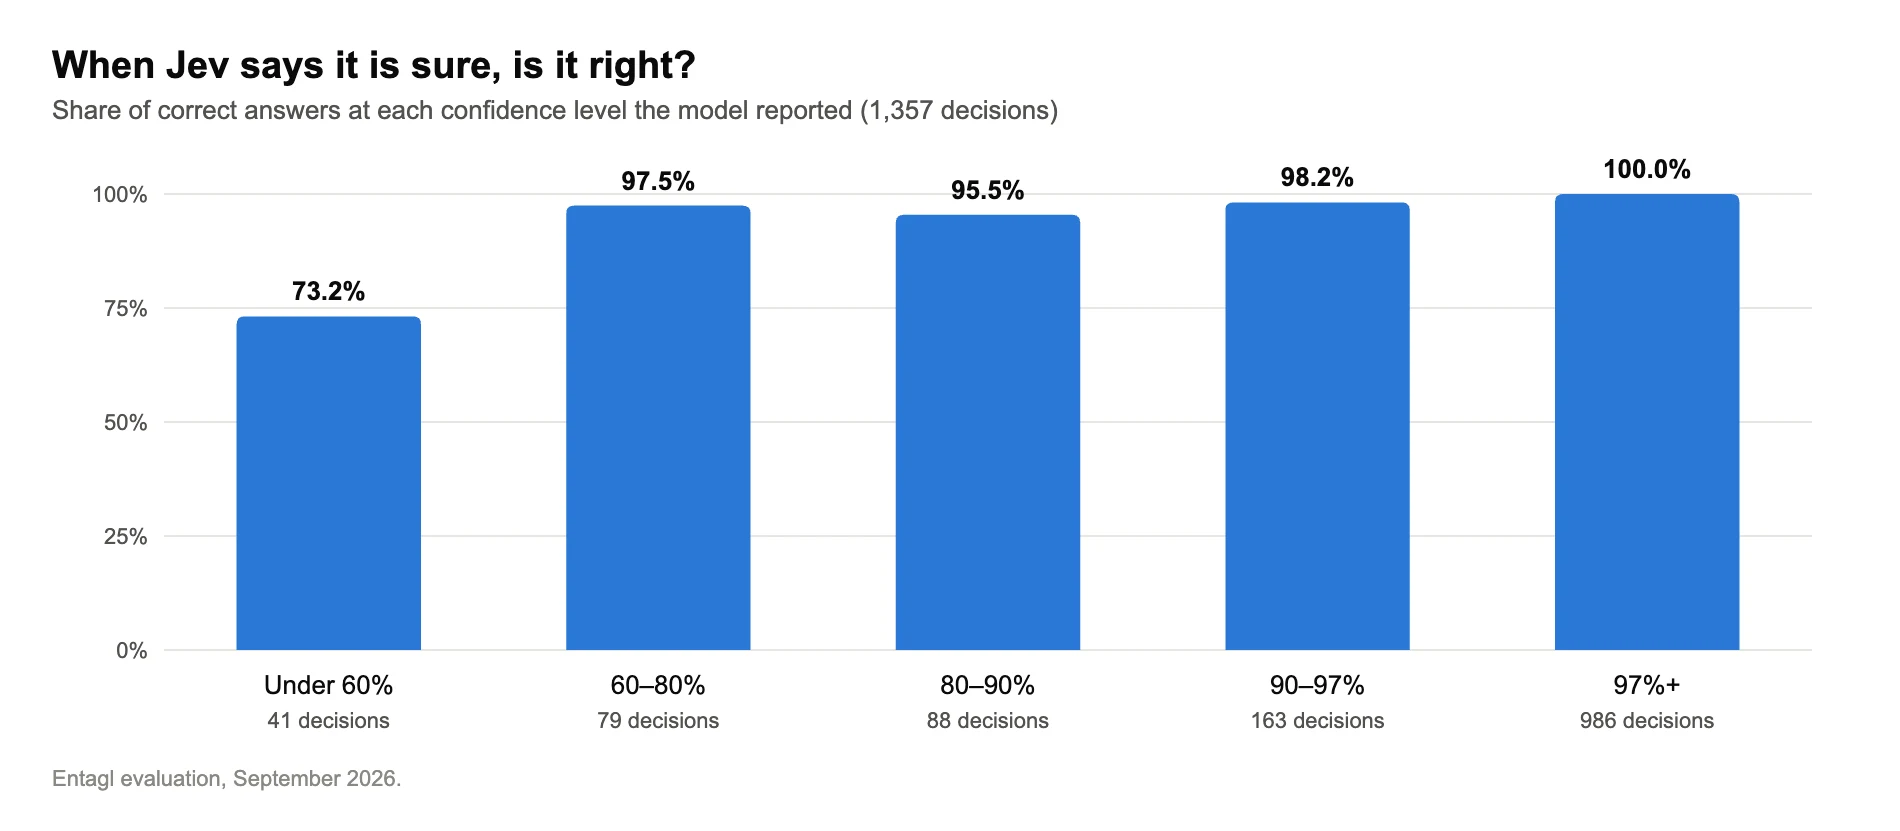
ضع قاعدة بسيطة: "اعتمد إجابة Jev فقط حين تكون ثقته 85% على الأقل، وإلا فاسأل النموذج الأكبر". عندها يتولى Jev 88% من القرارات بدقة 99.75%، ويُحال 17 من أصل 20 خطأً وقع فيها إلى النموذج الاحتياطي. وكل أخطاء اللهجات العربية جاءت بثقة بين 0.36 و0.40، فالتقطتها القاعدة.
ومع ذلك مرّ خطأ واحد بثقة عالية. كتبت وكالة إعلانات تركية "نودّ العمل معكم"، فقرأها Jev على أنها طلب توظيف، بثقة 0.95، في التشغيلات الثلاثة كلها. لم يُحدث ذلك ضررًا في سياقه (فقد صنّفها Jev أيضًا عرضًا بيعيًا، وهذا القرار هو الذي يُعتمد)، لكنه تحذير في محله: درجة الثقة دليل، وليست إذنًا. ما زلت بحاجة إلى فحوص مُصنّفة وتتبّع للنتائج بعد تفعيل أي شيء.
ماذا حدث حين أعدنا تشغيل محادثات حقيقية؟
لم يتجاوز التطابق الخام مع القرارات الأصلية 74–84%، لكن معظم هذه الفجوة لم يكن سببه أن Jev أخطأ.
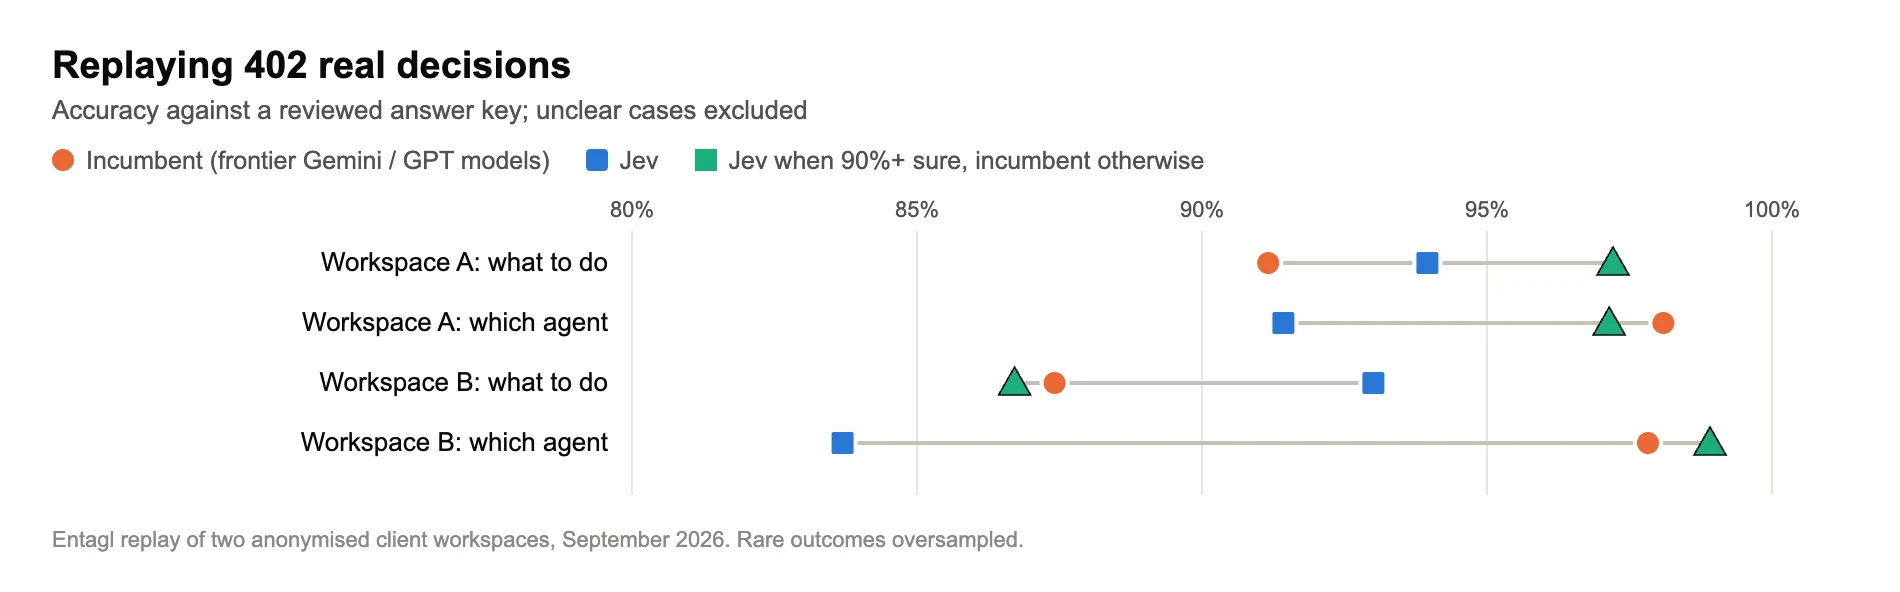
النتائج مقارنةً بمفتاح الإجابات المُراجَع:
| القرار | الأصلي (Gemini / GPT متقدّم) | Jev | Jev عند ثقة 90% فأكثر، والأصلي فيما عدا ذلك |
|---|---|---|---|
| مساحة العمل A: ماذا نفعل بالرسالة | 91.2% | 94.0% | 97.2% |
| مساحة العمل A: أيّ مختص يرد | 98.1% | 91.4% | 97.1% |
| مساحة العمل B: ماذا نفعل بالرسالة | 87.4% | 93.0% | 86.7% |
| مساحة العمل B: أيّ مختص يرد | 97.8% | 83.7% | 98.9% |
ملاحظة غريبة: في مساحة العمل B، جعل التقييد بالثقة قرار الرسالة أسوأ قليلًا (86.7%)، لأن الرجوع إلى القرار الأصلي في الرسائل التي تردد فيها Jev كان يعني الأخذ بأضعف إجابات القرار الأصلي.
تحديد ما يجب فعله بالرسالة (الرد، أو التجاهل، أو التحويل إلى موظف، أو إرسال رد جاهز) حسمه Jev لصالحه في مساحتي العمل. أما اختيار المختص فلم يكن كذلك، والسبب محدد. معظم الأخطاء كانت رسائل متابعة مثل "الهند" أو "سأناقش الأمر غدًا" داخل محادثة جارية أصلًا مع مختص بعينه. وقواعد العميل تنص على البقاء مع ذلك المختص. رأى Jev آخر ثماني رسائل، لكن أحدًا لم يخبره بمن يتولى المحادثة، فخمّن من الكلمات. أما الإعداد الأصلي فكان لديه هذا السياق واستفاد منه.
وكشفت إعادة التشغيل أيضًا أخطاء في القرارات الأصلية، من النوع الذي يفوت أي فحص عشوائي:
- قاعدة كلمات مفتاحية أصابت الأشخاص الخطأ. كان رد إحالة جاهز يُرسَل كلما استخدم أحدهم كلمة "قانوني" أو "محامٍ". وفي عيّنة من 20 حالة، كانت 15 منها أسئلة أعمال عادية مثل "ما المستندات القانونية التي أحتاجها لهذا؟". وجّهها Jev إلى إجابة حقيقية.
- تحويلات متكررة إلى الموظفين. بعد أن قدّم العميل اسمه ورقمه مرة واحدة، صارت الرسائل اللاحقة مثل "شكرًا" أو "obrigada" تطلق كل منها تحويلًا جديدًا إلى الموظفين. من أصل 41 تحويلًا فحصناها، كان 17 تحويلًا تكرارًا من هذا النوع.
- قاعدتان متناقضتان، فكان النموذجان كلاهما يخمّنان في الرسائل نفسها.
رفعنا هذه الملاحظات لإصلاحها من المصدر. وقواعد الكلمات المفتاحية مثل الأولى هي بالضبط ما يحذّر منه دليلنا لإيقاف هلوسة وكلاء الذكاء الاصطناعي.
أين يقصّر Jev؟
بصراحة:
- دقائق اللغات غير الإنجليزية. تقول وثائق TypeSafe نفسها إن الإنجليزية هي لغة التدريب الأساسية، وإن اللغات الأخرى "مدعومة لكن ليس بالجودة نفسها". ورأينا ذلك: 99.1% بالإنجليزية، و98.4% بالتركية، و96.5% بالعربية. ستة من أخطاء العربية التسعة كانت خلطًا بين اللهجات؛ والثلاثة الأخرى جاءت من رسالة حدّية واحدة حول سؤال "هل هذه شكوى؟" ومن تصنيف قد نختلف عليه نحن أنفسنا.
- سياق مفقود لا يمكنه استنتاجه. من يتولى المحادثة، وهل جُمعت بيانات التواصل مسبقًا: في إعادة التشغيل الحقيقية، خسر Jev نقاطًا كلما توقفت الإجابة على معلومة لم تكن في النص الذي أرسلناه. والحل أن تحسب هذه المعلومات في الشيفرة وتسلّمها إليه، لا أن تأمل أن يخمّنها النموذج.
- نصوص الإعلانات المعبّأة مسبقًا. كثير من محادثات WhatsApp القادمة من إعلانات "انقر لإرسال رسالة" تبدأ بسطر جاهز مثل "أودّ معرفة المزيد عن خدماتكم". اعتمد Jev على هذا السطر، فمرّر عددًا من الباحثين الفعليين عن عمل وطلبات التبرع على أنها عملاء محتملون، أحدها بثقة 0.92. احذف السطر الجاهز أولًا.
- أمور لم يُصمَّم لها أصلًا. تسرد TypeSafe "حوافه المتعرّجة" بنفسها: الحساب، والعدّ، ومقارنة التواريخ، والمدخلات الطويلة المليئة بتفاصيل لا صلة لها، والنصوص المكتوبة للتلاعب به. أبقِ الحسابات والتواريخ في الشيفرة.
- إنه جديد كليًا. أُطلق في سبتمبر 2026، مع حدود استخدام تقول الشركة إنها قد تتغير. وأي شيء يُبنى عليه يحتاج إلى بديل احتياطي.
أين نستخدم نموذج قرارات مثل Jev؟
في أي موضع يُطلب فيه من نموذج لغوي أن يختار من قائمة، ولا يقرأ أحد مخرجاته:
- التوجيه والفرز في المرحلة الأولى، مع بوابة ثقة ونموذج أكبر خلفه.
- تحليلات المحادثات اليومية (الفئة، والانطباع، و"سأل عن السعر") على كل محادثة، لا على عيّنة منها.
- فحوص أمان تعمل باستمرار: طلبات التوقف عن المراسلة بأي لغة، أو نصوص تحاول إصدار تعليمات للمساعد (راجع دليلنا عن حقن الأوامر).
- نتائج المكالمات كبيانات، تُستخرج من نص المكالمة.
واجمع أسئلتك في دفعة واحدة أيضًا: في اختبار أجرته TypeSafe على مستند طويل واحد، تبيّن أن طرح 13 سؤالًا في استدعاء واحد بدلًا من 13 استدعاءً كان أرخص بـ12.2 مرة وأسرع بـ10 مرات مع الإجابات نفسها.
أما حيث لا نستخدمه: كتابة الردود، وأي شيء رقمي، وأي موقف قد تُسكت فيه إجابة خاطئة واثقة عميلًا حقيقيًا. حظر رسالة بالكامل يجب أن يتطلب ثقة عالية جدًا أو رأيًا ثانيًا.
كيف تقيّم نموذج قرارات بنفسك؟
ما نجح معنا:
- صنّف قبل أن تشغّل. "يتفق مع النموذج الحالي" لا يعني "صحيح". فقد أظهرت إعادة التشغيل أن النموذج القائم كان يخطئ بما يكفي ليكون ذلك مؤثرًا.
- افصل النتائج حسب اللغة. متوسط 98% قد يخفي لغة عند 96% يستخدمها عملاؤك فعلًا.
- ارسم الدقة حسب درجة الثقة، ثم أعد تشغيل سجل حقيقي. النموذج الرخيص بلا بوابة ثقة يُعتمد عليها عبء لا ميزة، وقد وصلت الحالات التي كتبناها إلى قرابة 100% للنموذجين كليهما؛ فحركة العملاء الحقيقية هي التي أظهرت الفروق، وأظهرت أخطاء النموذج القائم نفسه.
- شغّله في الظل قبل التحويل. شغّل النموذج الجديد بصمت إلى جانب القديم، وحوّل مهمة تلو مهمة، لا دفعة واحدة أبدًا.
يتسق هذا مع نقطة أوسع طرحناها من قبل حول عدم المراهنة بمنتجك على نموذج ذكاء اصطناعي واحد: النموذج المناسب لـ"القرار" كثيرًا ما لا يكون المناسب لـ"الكتابة"، والنماذج الأصغر والأرخص باتت تتولى من المهمة الأولى أكثر مما تفترضه معظم الفرق.
الأسئلة الشائعة
هل TypeSafe Jev بديل عن GPT أو Gemini؟
لا. إنه يحل محل نوع واحد من الاستدعاءات: الاختيار من خيارات تحددها أنت، أو التقييم على مقياس، أو الإجابة بنعم أو لا. لا يستطيع كتابة النصوص، ولا استخدام الأدوات، ولا قراءة الصور، لذا يظل الوكيل الذي يتعامل مع العملاء بحاجة إلى نموذج لغوي لكتابة الرد.
ما مدى دقة TypeSafe Jev مقارنةً بالنماذج اللغوية المتقدّمة؟
في اختبارنا في سبتمبر 2026 على 1,357 قرارًا مُصنّفًا، سجّل 98.5% مقابل 99.0% لنموذج Google Gemini متقدّم. وعلى سجل محادثات حقيقي، كان أفضل في تحديد ما يجب فعله بالرسالة، وأضعف في اختيار المختص المناسب في منتصف المحادثة.
هل يعمل TypeSafe Jev بالعربية والتركية؟
نعم، مع تحفّظ. كانت التركية قريبة من الإنجليزية في اختبارنا (98.4% مقابل 99.1%). وكانت العربية 96.5%. معظم الأخطاء كانت خلطًا بين اللهجات (قراءة الخليجية على أنها مصرية أو شامية)، ولم يخطئ في تحديد اللغة نفسها قط، وجاءت تلك الأخطاء بدرجات ثقة منخفضة.
هل يمكن الاعتماد على درجة الثقة لدى Jev؟
في بياناتنا، تتبّعت الدقة جيدًا: صواب بنسبة 100% عند ثقة 97% أو أعلى، و73% عند أقل من 60%. ومع ذلك وقع خطأ واثق واحد (0.95)، لذا استخدم الدرجة لتقرر متى تلجأ إلى البديل، وواصل فحص النتائج الحقيقية.
هل هو أرخص وأسرع من النموذج اللغوي الكبير؟
في استدعاءات الاختبار لدينا، كانت تكلفته أقل بنحو 25 مرة، وأجاب في وسيط 329 ms مقابل 1,598 ms، ويرجع ذلك أساسًا إلى أن Jev يحتسب رموز الإدخال فقط ويعيد إجابة قصيرة محددة النوع بدلًا من نص مُولَّد.
تريد ذكاءً اصطناعيًا يعرف متى لا يكون متأكدًا؟
نختبر نماذج كهذه كي يحسم الوكلاء الذين يردّون على عملائك القرارات السريعة الرخيصة بشكل صحيح، وتُحيل الصعبة منها إلى نموذج أكبر. لترى كيف يعمل ذلك على رسائلك المباشرة، احجز عرضًا توضيحيًا مدته 30 دقيقة، أو اطّلع على كيفية تعامل وكلائنا الذكيين لرسائل Instagram وWhatsApp المباشرة مع ذلك اليوم.
المصادر والمنهجية: تقييم أجرته Entagl، سبتمبر 2026. الجولة 1: 283 حالة اختبار مُصنّفة يدويًا (189 حالة عادية، إضافة إلى 94 حالة صعبة شُغّلت ثلاث مرات: 471 تشغيلًا)، و1,357 قرارًا مُقيّمًا، TypeSafe Jev (jev-1.13.0) مقابل نموذج Google Gemini متقدّم بمدخلات متطابقة؛ وتقارن التكلفة الرموز المحتسبة لاستدعاءات متطابقة وفق سعر القائمة لدى كل مزوّد حتى سبتمبر 2026 (يحتسب Jev رموز الإدخال فقط). الجولة 2: 402 قرار توجيه حقيقي من مساحتي عمل لعميلين مجهولَي الهوية خلال 21 يومًا، مع إخفاء البيانات الشخصية قبل المعالجة؛ رُوجعت حالات الاختلاف وفق القواعد المكتوبة لدى كل عميل، واستُبعدت الحالات غير الواضحة، وزيدت نسبة النتائج النادرة في العيّنة، لذا فالنسب المئوية ليست متوسطًا للإنتاج الفعلي. مُراجِع واحد. معلومات المزوّد: منشور إطلاق TypeSafe، وثائق نماذج TypeSafe، القيود المعروفة لـJev 1.13، دليل TypeSafe للأسئلة المتوازية. خلفية المعايرة: Guo et al., ICML 2017.